1.1 · 学习路线与知识图谱: 不同背景者的进阶地图
1. 为什么你需要一张地图
大模型领域的知识密度之高、迭代速度之快,使得「碎片化学习」成为最隐蔽的学习陷阱. 你可能今天读了一篇关于 LoRA 的博客,明天看了一个 RAG 的教程,后天又在某个技术群里听到了「测试时计算扩展」这个新词——每一片信息看起来都有价值,但当你试图把它们拼成一张完整的认知网络时,会发现中间充满了巨大的断层.
**知识图谱的核心作用,就是消除这些断层. **
一张好的知识图谱不是 Wikipedia 式的概念罗列,而是一个带有依赖关系、难度梯度、验证节点的技能树. 它应该能回答三个问题:
- 我现在在哪里?(已掌握的技能节点)
- 我想去哪里?(目标岗位或研究方向)
- 最短路径是什么?(绕过非必要节点,直击核心依赖)
本节将首先呈现大模型领域的全景知识图谱,然后针对三类典型读者——学术导向的本科生/研究生、工程导向的算法工程师、应用导向的产品经理——分别给出阶段性的学习路径、关键资源推荐和自检标准. 最后,我们会将本知识库的全部章节映射到这张图谱上,让你清楚地知道每一章填补了知识网络中的哪个空缺.
2. 大模型领域全景知识图谱
大模型技术的知识网络可以划分为五个同心层,从内到外依次构建:
                    ┌─────────────────┐
                    │  第5层: 前沿探索  │  ← 多模态、Agent、世界模型、具身智能
                    │  (不确定性最高)  │
                    ├─────────────────┤
                    │  第4层: 应用构建  │  ← RAG、Prompt Engineering、工具调用、评估
                    ├─────────────────┤
                    │  第3层: 对齐与后训练│ ← SFT、RLHF、DPO、OPD、测试时扩展
                    ├─────────────────┤
                    │  第2层: 预训练    │  ← 数据工程、训练目标、Scaling Law、分布式
                    ├─────────────────┤
                    │  第1层: 核心架构  │  ← Transformer、注意力变体、位置编码、归一化
                    ├─────────────────┤
                    │  第0层: 数学基础  │  ← 线性代数、概率论、优化理论、信息论
                    └─────────────────┘
**层与层之间的依赖关系是严格的. ** 你无法在不理解自注意力机制的情况下真正理解为什么 GQA(Grouped Query Attention)能减少 KV cache 的显存占用; 你无法在不理解最大似然估计的基础上判断 DPO 的 loss 设计是否合理的. 因此,我们强烈建议读者遵循从第 0 层到第 5 层的递进顺序,除非你对某一层已经有了扎实的掌握.
2.1 第 0 层: 数学与编程基础
这一层是所有后续内容的先验条件. 如果你在这里存在漏洞,后续学习的效率会急剧下降.
线性代数: 矩阵乘法、特征值分解、SVD、张量运算. 重点不在于手算,而在于理解「矩阵乘法本质上是一种线性变换的复合」这一几何直觉. 这直接对应 Transformer 中 Q/K/V 的投影操作.
概率论与信息论: 条件概率、贝叶斯定理、期望与方差、熵、KL 散度、互信息. KL 散度是理解 SFT、蒸馏、VAE、RLHF 中几乎一切目标函数的基石.
微积分与优化: 梯度、链式法则、凸优化基础、随机梯度下降、动量法、自适应学习率. 你需要理解为什么 Adam 在实践中比纯 SGD 更稳定,以及 AdamW 相比于 Adam 在权重衰减处理上的关键改进.
编程基础: Python 熟练度无需多言. PyTorch 的 autograd 机制必须亲手调试过,理解「计算图」和「反向传播」在代码中的具体体现. 建议至少完整实现过一次从零开始的多层感知机(MLP)训练,不调用 nn.Linear 的高阶封装,而是手动管理权重矩阵和梯度.
2.2 第 1 层: 核心架构
这是大模型技术的「操作系统内核」.
Transformer 架构: 原始的 Attention Is All You Need 论文必须精读. 不是读摘要,而是逐行推导公式,理解为什么要除以 ,为什么需要多头,为什么需要残差连接,为什么需要层归一化. 本知识库第 2 章将提供比原论文更详尽的推导和变体对比.
注意力机制变体: Sparse Attention、Linear Attention、FlashAttention、MQA/GQA. 这些变体不是为了「发论文」而存在的学术游戏,而是真实的工程约束(显存、延迟、长上下文)驱动的架构演进.
位置编码: 从绝对位置编码(Sinusoidal, Learnable)到相对位置编码(RoPE, ALiBi),再到无位置编码的探索(如 NoPE). 位置编码的选择直接决定了模型外推能力的天花板.
归一化策略: Batch Norm 为什么在自然语言处理中失效?Layer Norm 的数学形式是什么?RMSNorm 相比于 Layer Norm 省略了哪些计算?为什么 Pre-LN 比 Post-LN 更稳定?这些问题将在第 2 章得到彻底解答.
2.3 第 2 层: 预训练
预训练是将一个随机初始化的神经网络转化为「会说话的知识库」的过程.
数据工程: 预训练的数据从哪里来?Common Crawl 的原始网页如何被清洗成高质量语料?去重、过滤、质量评分、隐私脱敏的具体 pipeline 是怎样的?数据配比(data mixture)如何影响模型的下游能力?Codex 和 The Pile 等经典数据集的设计哲学是什么?
Tokenizer: BPE、WordPiece、Unigram 算法的工作原理. 为什么 GPT 系列用 BPE,T5 用 SentencePiece?Tokenizer 的选择会如何影响模型的多语言能力和对罕见词的处理?
训练目标: 自回归语言建模(Next Token Prediction)是主流,但为什么不是唯一选择?Span Corruption(T5)、Prefix LM、Mixture of Denoisers(UL2)各自适用于什么场景?
Scaling Law: OpenAI 2020 年的 Scaling Law 论文揭示了什么?Loss 随计算量、参数规模、数据量如何幂律下降?Chinchilla 最优(参数与数据等比例 scaling)对工程决策有什么指导意义?
2.4 第 3 层: 对齐与后训练
预训练模型是一个「会说话的知识库」,但它不一定是一个「好用的助手」. 对齐技术解决的就是这个问题.
监督微调(SFT) : 指令数据的构造原则、多轮对话的格式设计、SFT 的隐式假设与暴露偏差(Exposure Bias)问题.
基于人类反馈的强化学习(RLHF) : Reward Model 的训练、PPO 在文本生成场景下的适配、KL 散度约束的作用、RLHF 的不稳定性和reward hacking 问题.
直接偏好优化(DPO) : 为什么 DPO 能绕过显式的 Reward Model 和 PPO?Bradley-Terry 模型与策略优化之间的数学联系是什么?DPO 的局限在哪里?
在线策略蒸馏(OPD)与自蒸馏: On-Policy 采样如何解决 Exposure Bias?Reverse KL 与 Forward KL 的行为差异?OPSD、GRPO 等后续方法如何在没有外部强教师的情况下实现自我提升?
测试时扩展(Test-Time Scaling) : o1 和 DeepSeek-R1 带来的范式转变——不再只在训练时烧钱,而是在推理时通过思维链(Chain-of-Thought)和搜索来换取更高的准确率.
2.5 第 4 层: 应用构建
将模型能力转化为产品价值.
Prompt Engineering: Zero-shot、Few-shot、Chain-of-Thought、Self-Consistency 的适用边界. 系统提示词(System Prompt)的设计原则.
检索增强生成(RAG) : Naive RAG 的架构、检索器(Dense vs. Sparse)的选择、重排序(Reranking)、查询重写、多跳推理、Advanced RAG 与 Agentic RAG 的演进.
Agent: ReAct、Plan-and-Execute、Reflection 等范式的对比. 工具调用(Tool Use)的接口设计、记忆机制(短期/长期)、多 Agent 协作的通信协议.
评估体系: Perplexity 为什么不足以评估对齐后的模型?MT-bench、AlpacaEval、HumanEval、GSM8K、MMLU 等基准测试各自测的是什么?如何设计面向业务的自定义评估 pipeline?
2.6 第 5 层: 前沿探索
当前技术边界之外的可能性.
多模态原生融合: 不是简单地把视觉Encoder 接到 LLM 上,而是从头开始在一个统一架构中处理文本、图像、音频、视频信号. Chameleon、Gemini、GPT-4o 的不同技术路线.
端侧部署: 模型压缩(剪枝、蒸馏、量化)、MobileLLM、Apple Intelligence 的架构选择. 在 8GB 显存的消费级设备上运行 70B 参数模型的技术栈.
Agent 操作系统: 从单一 Agent 到多 Agent 协作,再到具备任务调度、资源管理、错误恢复能力的 Agent 操作系统(如 AutoGen、LangGraph、Google DeepMind 的 Multi-Agent 框架).
世界模型与具身智能: Sora 作为世界模拟器的争议、从文本/视频生成到物理世界交互的跨越、人形机器人与大模型的结合.
3. 面向三类读者的学习路径
3.1 学术导向: 本科生与研究生的攀登之路
目标: 具备独立阅读前沿论文、复现代码、提出改进并撰写学术论文的能力. 最终能在一个细分方向(如长上下文建模、高效注意力机制、多模态对齐)达到领域前沿.
第一阶段: 基础夯实(第 0-1 层,约 2-3 个月)
如果你是大二或研一学生,先不要急着跑 LLaMA 的微调脚本. 花两个月时间,把地基打牢.
数学: 精读《Mathematics for Machine Learning》(Deisenroth 等)的线性代数、概率论、优化三章. 不需要做所有习题,但要确保每一章的核心定理(如谱定理、大数定律、梯度下降的收敛性)你能独立推导.
编程: 在 PyTorch 官方教程之外,强烈推荐 Andrej Karpathy 的「Neural Networks: Zero to Hero」系列视频. 从零实现 micrograd、MLP、RNN、WaveNet,再到 GPT. 这个系列的价值不在于代码量,而在于它培养了「用张量运算思考」的肌肉记忆.
论文精读: Attention Is All You Need(2017)、BERT: Pre-training of Deep Bidirectional Transformers(2018)、GPT-2(2019). 不要只看,要复现. BERT 的 MLM 任务、GPT 的自回归语言建模,各写一遍简化版.
第二阶段: 核心突破(第 2-3 层,约 3-4 个月)
预训练: 精读 Scaling Laws for Neural Language Models(OpenAI, 2020)和 Training Compute-Optimal Large Language Models(Chinchilla, DeepMind, 2022). 理解数据量与参数量的 trade-off.
后训练: InstructGPT(2022)的 RLHF pipeline 必须吃透. 然后阅读 Direct Preference Optimization(DPO, 2023)和本知识库第 4 章关于 OPD 的内容. 理解从 PPO 到 DPO 到 OPD 的演进逻辑——每一步都是为了解决前一步的某个工程痛点.
动手实验: 使用 TinyLlama 或 Qwen2.5-0.5B 这样的小模型,在自己的数据集上完成一次完整的 SFT + DPO pipeline. 不要用 TRL 库的一键脚本,而是手动拼接数据加载器、loss 计算和训练循环. 只有亲手写过,你才知道 DPO 的 reference model 为什么要设
requires_grad=False.
第三阶段: 前沿探索(第 4-5 层,持续进行)
选定细分方向: 长上下文(Long Context)是一个对初学者相对友好的切入点. 从 ALiBi、RoPE 外推、NTK-aware 插值,读到 YaRN、Mamba、Ring Attention. 每一个方法的动机都很清晰: 让模型在更长的序列上保持注意力质量.
参加开源社区: 给 transformers、vLLM、llama.cpp 等仓库提 PR. 哪怕是从修复文档 typo 开始,也能让你理解这些工业级代码库的协作流程和代码规范.
写作与发表: 不要等「做出了 SOTA 结果」才动笔. 写一个技术博客,把你对某篇论文的理解、实现中的坑、实验中的反直觉发现记录下来. 这既是知识巩固,也是学术影响力的起点.
关键论文清单(学术导向) :
| 阶段 | 必读论文 | 核心收获 |
|---|---|---|
| 基础 | Attention Is All You Need | 自注意力、多头、位置编码的原始定义 |
| 基础 | Layer Normalization (Ba et al., 2016) | 归一化的统计动机 |
| 核心 | GPT-3 (Brown et al., 2020) | Few-shot learning、涌现能力 |
| 核心 | Llama 2 (Touvron et al., 2023) | 开源预训练的标准配方 |
| 核心 | InstructGPT (Ouyang et al., 2022) | RLHF 的完整 pipeline |
| 核心 | DPO (Rafailov et al., 2023) | 直接偏好优化的数学优雅性 |
| 前沿 | Mamba (Gu & Dao, 2023) | 线性复杂度序列建模 |
| 前沿 | DeepSeek-V3 Technical Report | MoE、FP8、aux-loss-free 负载均衡的工程巅峰 |
关键代码仓库:
- pytorch/pytorch: 理解 autograd 和分布式通信原语
- huggingface/transformers: 模型架构的工业级实现标准
- huggingface/trl: SFT、PPO、DPO 的训练框架
- vllm-project/vllm: 推理优化的前沿实践
- meta-llama/llama: 最简洁的 LLaMA 实现,适合阅读
3.2 工程导向: 算法工程师的实战路径
目标: 具备从头预训练或大规模微调模型的工程能力,能在真实业务场景中完成模型选型、训练 pipeline 搭建、推理优化和部署上线. 能在「精度」与「成本」之间做出有理有据的权衡.
第一阶段: 工具链熟练(约 1 个月)
PyTorch 高级特性: 分布式数据并行(DDP)、Fully Sharded Data Parallel(FSDP)、Mixed Precision(AMP)、Gradient Checkpointing、TorchCompile. 不是「用过」,而是「理解其原理并能 debug」.
Hugging Face 生态: datasets、transformers、accelerate、peft(LoRA、QLoRA)、trl 的熟练使用. 能快速完成「加载模型 → 加载数据 → 配置训练参数 → 启动训练 → 评估 → 导出」的全流程.
云环境实操: 在阿里云 PAI、AWS SageMaker 或自建集群上完成一次多卡训练. 理解 NCCL 报错信息,知道如何排查 OOM、通信超时、数据加载瓶颈.
第二阶段: 训练与优化(第 2-3 层,约 2-3 个月)
预训练 pipeline: 数据清洗(MinHash/LSH 去重、质量打分)、Tokenization、训练脚本配置、Checkpoint 管理与断点续训、训练监控(WandB 集成、loss spike 检测).
高效微调: LoRA 的 rank 选择、alpha 缩放、target module 的选择策略. QLoRA 的 4-bit NormalFloat 量化对精度的影响. Prefix Tuning 与 Prompt Tuning 的适用场景.
分布式训练策略: ZeRO-1/2/3 的显存与通信 trade-off、Pipeline Parallelism 的 bubble 问题、Tensor Parallelism 的 all-reduce 开销、3D Parallelism 的组合策略.
第三阶段: 推理与部署(第 6 层,约 2 个月)
推理优化: KV Cache 管理、PageAttention(vLLM)、Continuous Batching、Speculative Decoding、Medusa/lookahead 解码.
量化与压缩: INT8/INT4 PTQ、AWQ、GPTQ、SmoothQuant、FP8(H100). 理解每种量化方法对模型不同层(attention vs. FFN)的敏感度差异.
服务化: TGI、vLLM、TensorRT-LLM 的部署实践. 动态批处理、流式返回、请求调度与优先级管理.
第四阶段: 垂直领域落地(第 4 层,持续进行)
RAG 系统: 不是「接入一个向量数据库」这么简单. 你需要理解嵌入模型(Embedding Model)与生成模型的能力错配问题、检索结果的上下文重排序、多轮对话中的查询消歧.
Agent 工程: 工具调用的 schema 设计、错误恢复策略、多轮状态管理、人类介入(Human-in-the-loop)机制.
自检标准(工程导向) :
- 能在 1 小时内,从零开始在一个 8×A100 节点上启动一个 7B 模型的全参数 SFT 训练,并正确配置 gradient checkpointing 和 FSDP.
- 能解释清楚「为什么 QLoRA 可以在单张 24GB 消费级显卡上微调 70B 模型」,并手动计算该配置下的显存占用分解.
- 面对业务方的「模型响应太慢」投诉,能给出从量化、投机采样、动态批处理到模型蒸馏的完整优化方案,并预估每种方案的精度损失和加速比.
3.3 应用导向: 产品经理与技术决策者的认知路径
目标: 建立对大模型技术边界、成本结构和风险因素的准确认知,能在产品设计中做出合理的技术选型,能与研发团队进行有效沟通.
第一阶段: 概念框架(约 2 周)
快速建立知识框架: 阅读本章及 1.2、1.3 节,建立行业全景认知. 不必理解 Transformer 的矩阵维度,但必须知道「预训练」和「后训练」分别决定了模型的什么能力.
体验主流产品: 深度使用 ChatGPT、Claude、Kimi、文心一言、通义千问至少各 10 小时以上. 记录它们在不同任务类型(创意写作、代码生成、数学推理、长文档摘要、多轮对话)上的表现差异.
了解 API 生态: 熟悉 OpenAI API、Anthropic API、国内主流厂商 API 的定价模型(按 token 计费 vs. 按请求计费)、速率限制、上下文长度限制.
第二阶段: 应用方法论(约 1 个月)
Prompt Engineering: 亲手写至少 50 个不同场景的系统提示词,观察细微措辞变化对输出质量的影响. 理解 Zero-shot、Few-shot、Chain-of-Thought 的适用边界.
RAG 与知识库: 理解向量检索 vs. 关键词检索的 trade-off. 亲手搭建一个基于开源方案的 RAG 系统(如 LangChain + Chroma + Qwen),体验「检索质量」如何成为 RAG 效果的天花板.
Agent 初探: 使用 Coze、Dify 或开源框架搭建一个能调用至少两个外部工具(如搜索引擎 + 代码执行器)的 Agent. 体验「规划失败」和「工具选择错误」等典型故障模式.
第三阶段: 评估与决策(持续进行)
评估体系理解: 知道 Perplexity、BLEU、ROUGE 为什么不适合评估对话质量. 了解 MT-bench、AlpacaEval、HumanEval 等基准测试的侧重点和局限性.
成本建模: 能估算一个客服机器人产品的月度 token 消耗和对应的 API 费用. 理解「推理成本随上下文长度超线性增长」这一关键约束.
风险管理: 幻觉(Hallucination)的不可根除性、数据隐私与合规(GDPR、国内数据安全法)、模型偏见的来源与缓解策略.
关键学习资源(应用导向) :
- OpenAI Prompt Engineering Guide: 官方最佳实践
- LangChain 文档: 应用框架的快速上手
- Dify.AI 开源版: 可视化的 LLM 应用开发平台,适合非代码背景者理解 pipeline
- 各厂商技术报告( skim 即可): OpenAI GPT-4 Technical Report、Anthropic Claude 3 Model Card、DeepSeek-V3/R1 Technical Report
4. 本知识库章节与知识图谱的映射
为了让读者清楚每一章填补了知识网络的哪个模块,我们将本知识库的八章内容与上述六层知识图谱进行交叉映射:
| 知识库章节 | 覆盖的知识图谱层级 | 核心填补能力 |
|---|---|---|
| 第 1 章 导论与基础 | 全层级(导航作用) | 建立全景认知,规划个人学习路径 |
| 第 2 章 核心原理 | 第 1 层 | Transformer 完整推导、注意力变体、位置编码、归一化策略的深度解析 |
| 第 3 章 预训练 | 第 2 层 | 数据工程、Tokenizer 设计、训练目标、Scaling Law 的极限展开 |
| 第 4 章 后训练 | 第 3 层 | SFT/RLHF/DPO/OPD/GRPO 的完整推导与代码实现,测试时计算扩展 |
| 第 5 章 模型全解 | 第 1-2 层(实例化) | GPT、LLaMA、DeepSeek、Qwen 等真实模型的架构拆解与工程取舍 |
| 第 6 章 训练优化 | 第 2-3 层(工程侧) | 分布式训练、混合精度、显存优化、推理加速、量化、编译优化 |
| 第 7 章 应用开发 | 第 4 层 | RAG、Agent、Prompt Engineering、评估体系的系统化方法论 |
| 第 8 章 多模态与工程化 | 第 4-5 层 | 多模态模型架构、端侧部署、MLOps、AI 基础设施 |
阅读路径建议:
研究路线(论文复现导向) : 第 1 章 → 第 2 章 → 第 3 章 → 第 4 章 → 第 5 章(选读目标模型)→ 前沿论文.
工程路线(落地导向) : 第 1 章 → 第 2 章(快速浏览)→ 第 5 章(选型参考)→ 第 6 章(精读)→ 第 7 章(应用开发).
产品路线(决策导向) : 第 1 章(含 1.2、1.3)→ 第 7 章 → 第 8 章(多模态与成本)→ 第 5 章( skim 了解模型能力边界).
5. 学习心法与常见陷阱
**心法一: 代码优先,先跑通再深究理论. **
拿到一篇新论文,不要先读公式,先去 GitHub 找官方实现或社区复现. 把代码 clone 下来,配好环境,跑通 demo. 当你看到终端里打印出合理的输出时,你对这篇论文的理解已经完成了 30%. 然后带着「这段代码为什么这样写」的问题回头去读公式,效率会提升数倍.
**心法二: 带着问题读论文. **
不要被动地接受论文的叙事. 在读之前,先问自己: 「如果我是审稿人,我最想质疑作者的是什么?」可能是实验设置、可能是 baseline 选择、可能是某个假设的合理性. 带着质疑去读,你会发现更多细节.
**心法三: 建立「演进家谱」意识. **
每学一个新算法,强迫自己回答三个问题: 1) 它的上一代方法是什么?2) 上一代方法在什么情况下失效了?3) 这个新算法引入了什么关键假设来突破局限?这个习惯能让你从「记住算法」跃迁到「理解领域」.
**常见陷阱一: 追逐 SOTA 焦虑. **
大模型领域的 SOTA 更迭速度是日级别的. 不要试图「学完所有新论文」. 选定一个与你当前工作最相关的细分方向,深入下去. 在单点上达到前 10% 的认知深度,远比在面上达到前 50% 更有价值.
**常见陷阱二: 重训练、轻数据. **
初学者往往把大量时间花在调学习率、换优化器上,却忽视了数据质量. 记住一个被反复验证的经验法则: 在大多数场景下,把数据质量提升 10% 带来的效果,远超把模型参数量翻倍. 数据清洗、去重、配比、指令格式设计,这些「脏活累活」才是决定模型上限的关键.
**常见陷阱三: 忽视评估. **
没有评估的训练就是盲人摸象. 很多初学者跑完训练脚本、看到 loss 下降曲线就以为万事大吉. 实际上,loss 下降与下游任务表现并不总是正相关. 从一开始就建立「训练-评估-分析」的闭环,用具体的 benchmark 和业务指标说话,而不是用主观感受.
6. 总结
本节提供了一张覆盖大模型领域五个认知层级的全景知识图谱,并针对学术、工程、应用三类读者分别给出了从入门到精通的阶段性路径、关键论文、代码仓库和自检标准. 知识图谱的价值不在于它标注了所有知识点,而在于它揭示了知识点之间的依赖关系——让你知道应该先学什么、后学什么、什么可以暂时跳过.
本知识库的全部八章内容被映射到了这张图谱上. 无论你选择哪条路径,都建议从第 2 章「核心原理」开始建立坚实的地基,因为 Transformer 架构的理解深度,将直接决定你后续学习预训练、对齐、优化和应用时的天花板高度.
下一节,我们将跳出技术细节,从行业生态的视角俯瞰大模型世界——那些你每天都在使用的模型和产品,背后站着怎样的技术团队和商业逻辑?
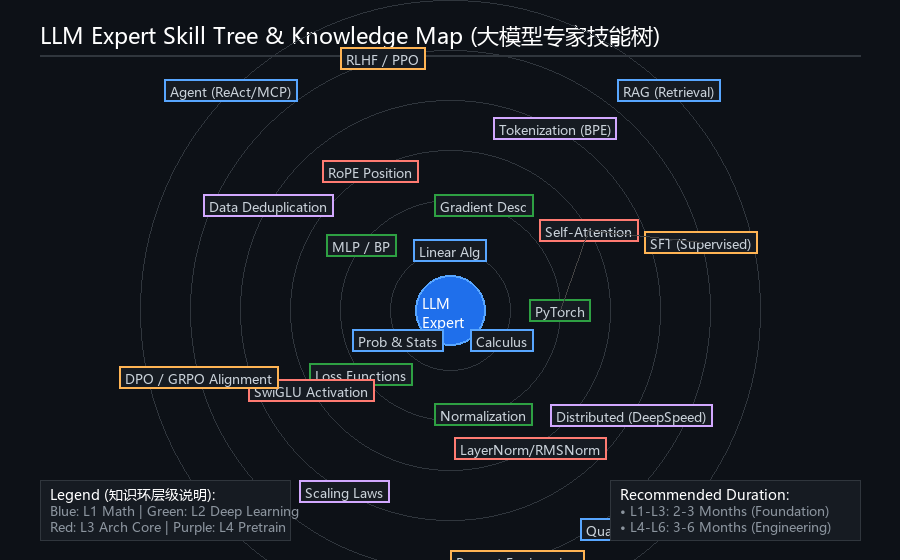
图 6.1 大模型专家全景技能树与知识图谱结构说明
- 中心节点(LLM Expert): 代表大模型领域专家的终极目标.
- 六大同心知识环(Concentric Rings L1-L6):
- L1: Math Foundations(数学基础): 最内层环. 包含线性代数(Linear Algebra)、概率统计(Probability & Stats)和微积分(Calculus),是理解神经网络与概率采样模型的底层基石.
- L2: Deep Learning(深度学习): 第二层环. 包含 PyTorch 框架、梯度下降(Gradient Desc)、多层感知机与反向传播(MLP/BP)等核心算法.
- L3: Transformer Core(架构核心): 第三层环. 包含自注意力机制(Self-Attention)、旋转位置编码(RoPE)、激活函数(SwiGLU)等大模型最核心的结构单元.
- L4: Pre-training(预训练工程): 第四层环. 包含 BPE 分词、数据去重、Scaling Laws 及分布式多机多卡训练(DeepSpeed).
- L5: Post-training(后训练对齐): 第五层环. 包含有监督微调(SFT)、强化学习对齐(RLHF/DPO/GRPO)等对齐算法.
- L6: Applications & Infra(应用与基建): 最外层环. 包含 RAG 检索增强、智能体(Agent/MCP)、推理部署加速(vLLM)和模型量化.
- 依赖连接线(Dependency Links): 表示跨层级技能的依赖关联(如 L2 PyTorch 指向 L3 自注意力机制,再指向 L5 SFT 的工程落地).