一个选择器真正要学的东西,可以压成一句话:用很便宜的表示,把主 attention 最舍不得丢掉的位置排进有限预算。训练同时面对检索与生成两个目标。检索目标要求候选集合覆盖关键证据,生成目标要求稀疏模型仍能预测下一个 token。单独优化检索会得到高召回却不会用证据的模型,单独优化生成又可能让路由依赖数据捷径。
先把两条训练路径分开. 教师概率 作为停止梯度的标签, 选择器参数 产生分数 , 经温度 的 softmax 得到学生概率 ;KL 损失训练这条打分路径. 主干则用硬 top-k 返回的整数位置 从历史 K/V 中取出选中项, 配合当前 query 计算稀疏 attention 和语言模型损失. gather 表示按位置取出张量行.
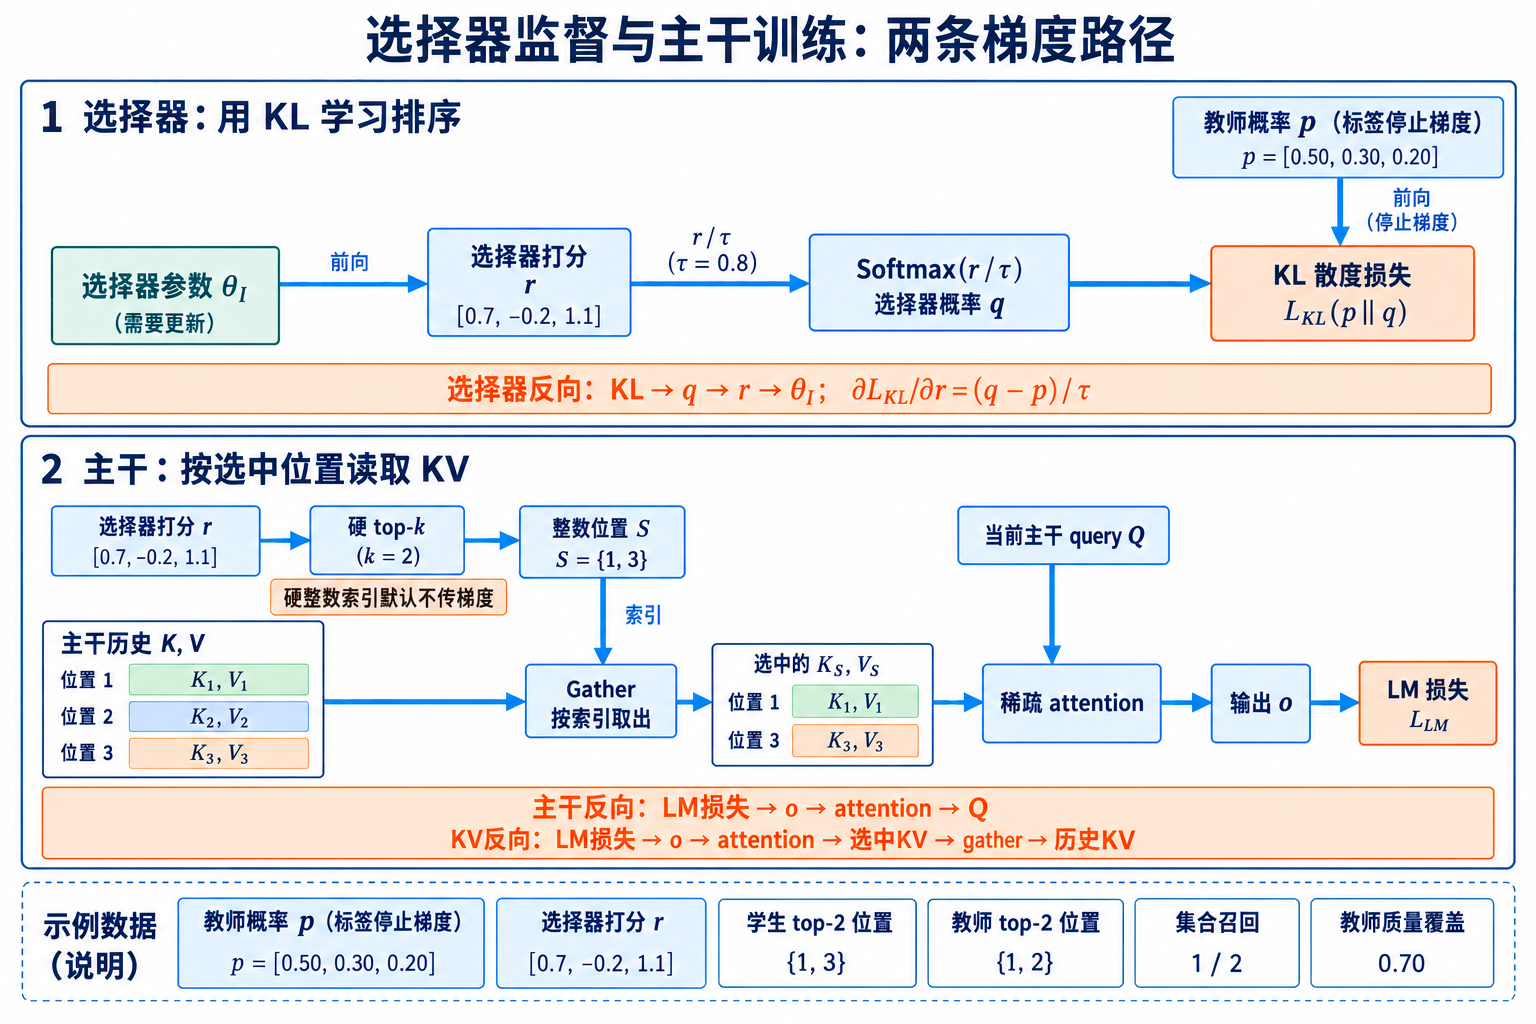
图 1: KL 监督打分与硬 top-k 主干训练的教学计算图, 对应下文式 (6)、(7) 及硬选择讨论. 教学数值已复算, 非模型实验;本图未启用 straight-through 代理梯度. 查看原尺寸.

图中位置从 1 开始, . 学生分数 选中位置 , 教师概率 的 top-2 为 , 因而集合召回为 , 教师质量覆盖为 . KL 可以直接训练选择器分数, LM 损失默认不能通过硬整数位置反传到分数. LM 梯度沿 attention 回到 query 和选中的 K/V, 再经 gather 返回相应历史张量行. 若选择器输入与主干共享表示, 共享参数还可能受到其他可微路径的更新, 但这不等于硬 top-k 的集合边界可导.
1. oracle 到底教什么
从 attention 分布构造集合。 对第 个 query,稠密教师 logits 与概率写成
包含因果与 padding mask。若部署预算为 ,最朴素的 oracle 是 。选择器产生低成本分数 ,再得到 。集合召回为
它容易解释,却把教师 top-k 内部的权重差异抹平。假设教师前四项概率为 ,预算 。候选 A 选中第 1、3 项,recall 为 ,概率质量为 ;候选 B 选中第 2、3 项,recall 同样为 ,概率质量只有 。集合指标完全相同,输出风险显然不同。
因此还要计算
即候选覆盖的教师概率质量。 直接关联被裁掉的 attention mass,但也不是最终任务质量的充分条件:两个 value 可能几乎相同,漏掉其中一个影响很小;也可能一个低概率 value 恰好携带唯一变量值。集合召回、质量覆盖和任务正确率要并列报告。
token、块与 GQA 的标签不可混用。 MoBA 与 NSA 的 selection 以连续块为单位。若块 覆盖位置集合 ,可以把 token 概率求和为块标签
求和适合估计整个块的概率质量;取最大值更重视块中单个尖峰;用块表示与 query 重新打分则训练的是代理相关性。三种定义会给出不同 oracle。实际 kernel 会读完整块,评测既要报告逻辑命中的关键 token,也要报告随块带入的总 token 数。
GQA 又多一层共享。同一 KV head 对应多个 query heads,部署若只允许一组共享候选,教师标签也应在组内聚合。可用各 head 块质量之和
它偏向服务多数 heads,少数检索 head 的唯一证据可能被淹没。可以比较逐 head 独立选择与组内共享选择:前者在每个 head 的预算内最大化教师概率质量,后者约束大家使用同一组位置。这个比较衡量共享规则造成的概率质量损失;最终任务质量还取决于 value 和后续计算。两种方案也要同时记录候选并集的物理读取量,否则独立选择的额外预算会混进结果。
正例之外要设计困难负样本。 随机负样本常常太容易。远处无关文本与 query 的主题差异明显,选择器只学关键词匹配便可分开;长上下文里真正危险的是同主题、同实体、同模板的错误片段。例如代码仓库里出现十次同名函数,文档里每章都有相同标题,工具轨迹里反复出现近似 JSON。
困难负样本可以来自教师 top-k 边界附近、同一文档的重复段、相邻块以及旧版本答案。边界样本训练排序精度,相邻块暴露块表示的模糊性,重复段检验位置与语义能否共同消歧。负样本池还要随长度增长;32K 内只有一个同名实体,扩到 1M 后可能出现几十个,训练难度已经改变。
oracle 也会泄漏与漂移。 自回归 selector 在位置 只能使用 产生的状态. 若目标是模仿该位置的稠密 attention, 教师 query 也应取自同一可见前缀;用答案 token 的 hidden state 回头检索 prompt, 得到的是另一个时刻的分布. 完整答案仍可以用于构造后见的证据标签或任务回报, 但它不能进入 selector 的输入特征. 离线预处理需要分别检查标签如何产生、学生实际读了什么, 避免把双向编码的答案信息送入部署时不可获得的表示.
教师还会随着主干更新而变化。联合训练开始时,稠密 checkpoint 的 attention 是一套 oracle;主干适应稀疏图后,query、key 与 head 功能都会漂移。始终使用旧标签,selector 可能准确模仿一套已经不存在的分布。每步重跑当前稠密教师最及时,也最昂贵。折中方案包括周期性刷新、教师参数的指数滑动平均,以及固定一部分探针 batch 比较新旧 oracle 的 Jaccard 与概率质量。
不同层的 attention 也不能合成一份通用标签。浅层常偏局部与词法,深层可能检索实体、指令或中间结论;同一个位置在相邻层的重要性会改变。跨层共享 selector 时,标签聚合规则就是模型假设:求和偏向多层共同需要的位置,取最大值保护只在单层突出的证据,分层蒸馏则保留差异但增加参数和缓存。共享带来的节省必须与单层 oracle 的损失一起测量。
1.1. 损失怎样穿过 top-k
KL 蒸馏训练低维 indexer。 DSA 的 Lightning Indexer 用低维 key 与多组 query 表示给全部历史位置打分。稠密预热阶段可以把主 attention 分布作为教师。令选择器概率
则蒸馏损失可写成
式 (6) 的温度 作用于学生分布, 教师 在式 (7) 中保持不变. 对学生分数求导得到 : 学生过度尖锐时, 教师在其他位置的非零质量仍会提供梯度. 若希望同时软化教师, 要另行定义教师温度, 并明确蒸馏双方采用的分布. 若稠密矩阵无法长期保存, 可以只保留教师 top- 与一个 tail mass;通常令 为部署边界附近的位置留下监督, 但困难负样本是否被覆盖还取决于采样方式.
DSA 的公开训练路线先用稠密 attention 预热 indexer,再启用 token 选择并联合优化全部参数。预热解决冷启动:随机 selector 若直接控制主 attention,早期候选近似随机,主干输入随 step 剧烈变化。联合阶段则让主干适应被裁剪后的分布。两阶段之间的 、长度和学习率切换都可能造成 loss 台阶,需要单独记录。
排序损失直接盯住边界。 KL 拟合完整概率形状,但部署只关心谁跨过第 名。对正例 与困难负例 ,可以用 margin loss
手算一个例子:,正例分数 ,负例 ,损失为 ;负例降到 后损失归零。它把梯度集中在排序不够安全的 pair 上。若只采最容易的负例,损失很快为零;若永远只采最难一个,又容易追逐教师噪声。可混合边界负例、随机负例与同主题负例。
cutoff margin
也值得监控。 很小时,FP8 量化、并列排序和不同 kernel 的归约顺序都可能翻转候选。平均 recall 没变,不代表这些翻转不会集中发生在关键 query 上。
soft routing 与 straight-through。 soft routing 可以令 , 用 对全部候选加权, 计算仍接近稠密. 无并列分数时, 温度趋零会使这个门集中到最高分位置, 对应 top-1;它不会自动变成保留 个位置的 hard top-k 掩码. 若部署保留多个位置, 需要连续 top-k 松弛或逐位置阈值门, 并明确与主 attention 权重怎样组合. 温度降得太快会让探索消失;一直很高又可能让主干依赖部署时消失的小权重.
straight-through 用 hard mask 做前向,用 soft gate 近似反向:
数值上 ,所以前向只看选中候选;对 求导时,stop-gradient 项消失,梯度沿 返回。这个估计让训练形状贴近部署,却把离散跳变当作连续变化,梯度有偏。应与纯教师监督、扩大候选训练做消融,而不是把「有梯度」等同于「梯度正确」。
候选探索给集合外样本一次机会。 hard top-k 的另一种训练办法是在预算外加入少量探索位置。设部署预算为 ,训练前向取 个高分位置,再从其余位置按概率或分桶抽取 个探索样本。探索样本参与教师排序或主 attention,但不计入部署质量。随着训练进行, 从较大值退火到零。
均匀随机探索在百万候选中很难撞到关键位置。更有效的抽样来自三处:教师高分而学生漏掉的位置,学生 cutoff 附近的位置,以及距离、主题、文档段落分桶后的代表项。第一类直接纠错,第二类稳定排序边界,第三类防止训练只覆盖高频距离。抽样概率进入 loss 时需做重要性校正,否则频繁被抽中的位置会被过度加权。
假设候选空间有 1024 块,部署 ,再抽 16 个均匀探索块。某个唯一漏选证据被碰到的概率只有 。若先用教师或粗索引缩到 64 个困难块,再从剩余 48 个里抽 16 个,概率升到 。探索是否有效,取决于采样池是否含有有价值的错误,单纯增加若干随机块效果很弱。
NSA、MoBA 与 KDA 的边界。 NSA 的压缩分支对全局压缩条目做 attention,其权重汇总成 selection 的块重要性。压缩输出本身参与最终结果,因此这条全局路径能正常接收语言模型梯度;选中的原始块补充细节,滑窗保证局部连接。hard top-k 的集合边界仍不可导,但压缩分支不会因某个原始块漏选就完全失去全局信号。训练时应分别观察三个 gate、压缩质量和 selected-block recall。
MoBA 用 query 与块均值 key 的点积给块排序,选中块与当前因果块进入精确 attention,没有独立的路由器参数。它可以在 full 与 sparse 模式之间切换,切换后每个 query 的归一化集合也会变化。预算从宽到窄的实验可研究主干怎样适应候选减少;原论文还研究了先 MoBA、后 full attention 的混合训练,不能把所有转换都理解为先训练一个选择器。
Kimi Delta Attention(KDA)通过门控递归状态保存历史,属于线性 attention。它没有为每个 query 从全部历史 token 中产生 hard top-k 集合,因而 recall@、候选负载均衡和随机 gather 不是它的核心训练指标。KDA 更关心有限状态能否写入、擦除并保留关联记忆,以及周期性 full attention 怎样弥补状态压缩。把它列在同一章的意义是划清训练问题,而非声称所有长上下文结构都有一个 selector。
1.2. 联合目标与预算手算
四项损失各管一件事。 一个可操作的联合目标是
校正最终预测,KL 保留教师概率结构,排序损失盯住 top-k 边界,预算项限制选择规模。四个数相加后得到的总 loss 很难诊断,日志中必须拆开。 太大时,学生被迫复现教师的细小尾部差异; 太大时,分数 margin 增大但概率校准变差; 太大时,选择器可能为了省预算放弃困难 query。
预算项若写成平均 gate 数,只控制均值。设四个 query 的候选数为 ,平均为 4;定长 kernel 的预算若是 4,三个短行浪费槽位,长行仍要截掉 6 个。更接近部署的约束是对超预算部分惩罚:
这里 必须是各位置可独立开启的保留门, 例如 sigmoid 阈值门, 而不是前面总和恒为 1 的 softmax 概率. 若直接代入 softmax 且 , 式 (12) 恒为零, 无法约束候选数量. 独立连续门仍不能生成固定形状, 所以后期要用真实 hard top-k 前向.
一次预算与质量手算。 假设 8 个历史块的教师质量为
部署选择 3 块。oracle 覆盖 。学生排序选中第 1、2、5 块,recall@,质量覆盖为 。这是 8 块上的概率教学例子。
另算长度为 8192、块长 64 的读取预算,此时共有 128 块。选择 3 块读取 192 token,再加上 128-token 固定窗口;若窗口与所选块不重合,逻辑候选数为 320,比例为 。若存在重合,去重后的候选更少;不同分支重复读取和物理 tile 扩张则要另外计算。这里没有给出 128 块的教师分布,前面的 覆盖不能沿用到这个长度例子。
若 selector 为每块读取一个 32 维 BF16 摘要,8 块只读 字节;扩到 1M token、块长 64 时共有 15625 块,单 query 摘要读取约 0.95 MiB。主 attention 虽保持 320 token,selector 扫描成本却随长度增长。训练损失只约束候选质量,不会自动消除这部分带宽。
把长度从 8192 扩到 131072,仍选 3 个全局块与 128 个窗口 token,主读取比例降到约 。比例更稀疏并不意味着任务更容易:候选块从 128 个增至 2048 个,困难负样本增加 16 倍。长度外推必须同时看 selector 召回与扫描成本。
概率质量可以控制自适应预算。 固定 对尖锐分布很浪费,对平坦分布又可能不够。若 selector 已经过概率校准,可以选择最小集合 ,使累计代理质量达到阈值 :
例如排序概率为 , 时需要 3 项;另一行是 ,同一阈值需要 5 项。这能把预算给更困难的 query,前提是 的校准在长度外仍可靠。
实际 kernel 可把 量化到几个档位,如 64、128、256、512,再按档位组 batch。这样比完全 ragged 更容易获得规则 tile,也比全批统一最大值少浪费。日志中要同时给平均 、P95/P99 和每档请求比例;只报平均值会隐藏少数超长行造成的尾延迟。
预算课程不能和长度课程绑死。 若长度从 8K 提到 32K,同时把 从 16 降到 4,质量下降无法归因。更清楚的实验分三组:固定长度只退火 ,固定 只增加长度,再测试两者联合调度。证据距离和干扰块数量也分别控制,才能判断模型怕远距离,还是怕相似负样本。
训练时可以用 起步,随后逐步缩小。每个阶段都在部署 上跑旁路评测,否则大候选掩盖的问题会在切到部署预算时集中爆发。若模型只在大预算下稳定,应回到标签与负样本,而非继续增加退火步数。
2. 训练—推理一致性
一致的是数据流,不只是参数。 训练保存 BF16 selector key,推理量化成 FP8;训练每个 head 独立选取,推理按 GQA 组共享;训练输出任意 token 索引,kernel 按页或块扩张;训练允许候选 512 个,服务配置截成 256 个。参数完全相同,实际邻接图已经不同。
最直接的检查是把部署 selector 与 kernel 索引器接回训练框架,在同一 batch 保存三组集合:教师 oracle、训练实现候选、部署实现候选。逐层计算交集、概率质量和输出误差,再按 query 类型分桶。只比较最终 perplexity 会把少量严重漏检淹没在大量局部 token 中。
并列分数要有确定规则。top-k 在 cutoff 处出现相同值时,不同设备可能返回不同索引;activation checkpointing 的 backward 若重算出另一集合,梯度会对应错误前向。可固定次级排序键,或在 forward 保存索引而不重算。保存索引增加 activation,重算则要求随机状态、量化与归约顺序完全可复现。
索引缓存与参数版本要同步。 选择器 key 常在 token 写入时计算并缓存。训练中参数每步更新,若一条长序列被切成多个 micro-batch,旧 token 的缓存可能来自旧参数,新 token 来自新参数;两者被同一个 query 打分,分数尺度未必一致。完整序列并行训练通常一次构造全部 key,在线继续训练或带状态训练则必须定义缓存版本。
可选方案有三种:每次参数更新后重算活跃序列索引;在一个序列完成前冻结 selector key 投影;或用慢速 EMA 参数生成缓存,使跨 step 漂移更小。第一种精确但贵,第二种限制优化频率,第三种引入教师滞后。无论采用哪种,训练模拟和服务端都要遵循同一更新边界。
跨层共享也需要版本标记。上游层生成的候选交给若干下游层复用时,下游梯度若无法回到候选生成器,训练目标应显式包含这些层的联合 oracle。否则 selector 只对产生索引的那一层准确,下游层只能被迫适应一组并不合适的固定候选。
teacher forcing 会放大路由偏差。 语言模型训练看到真实前缀,生成时看到自己的历史输出。早期生成错误会改变后续 query 表示,selector 随之访问不同证据。普通自回归模型已有这种暴露偏差;动态路由又增加一层离散放大:query 轻微变化可能让第 与第 名交换。
可以用带噪 query、短段自由生成或学生轨迹蒸馏检验稳定性。语义相近的 query 应保住关键块,同时允许次要候选随表达变化。记录 Jaccard、质量覆盖差与 cutoff margin,比只看 router logit 的均方误差更贴近部署。
稀疏 backward 也要兑现。 训练原生稀疏只有在 forward、backward 都沿稀疏边执行时才节省训练成本。若 forward 选少量块,backward 为了方便又物化稠密 mask 或完整分数矩阵,显存和计算仍可能平方增长。NSA 强调训练、prefill 与 decode 的硬件对齐,正因为反向 kernel 也是完整方法的一部分。
训练报告应列出每层保存的索引、softmax 统计量和压缩状态,区分逻辑 FLOPs 与实测 step time。selector 教师若周期性运行稠密 attention,还要按频率摊入平均训练成本。
2.1. 长度外推与召回验收
三类召回指标。 第一类是集合 recall@,用于快速比较排序。第二类是式 (3) 的概率质量覆盖,能区分教师强弱项。第三类是证据召回:数据已知答案依赖哪些 span,检查候选是否覆盖这些 span。三者回答不同问题。
还可计算 selected attention 与 dense attention 的输出差
输出差包含 value 冗余信息,但仍停留在单层。最终要用长文问答、代码定位、多证据合成和 agent 轨迹回放验证。平均指标之外报告最差分位数,尤其关注低 margin、高熵与证据极远的 query。
长度网格怎样设计。 至少在训练长度内、训练长度边界和数倍外推长度上画曲线,例如 8K、32K、128K、512K。每个长度保持任务难度有可比版本,再增加固定数量与随长度增长的干扰项。若只把无关填充重复到更长,容易高估外推能力。
固定 曲线揭示候选竞争加剧;固定保留比例曲线揭示质量需要多少计算;固定概率质量阈值曲线揭示每个 query 需要多少自适应预算。三条曲线一起看,才能决定线上采用定长 top-k、分桶预算还是质量阈值。
失败模式对应哪些日志。 路由塌缩表现为少数块访问频率极高、候选熵下降、不同 query 集合趋同;先检查负载损失和局部数据捷径。边界抖动表现为 接近零、量化前后候选交集下降;检查分数尺度、难负样本和确定排序。长度退化表现为短序列 recall 稳定、长序列随负样本数快速下降;需要扩大训练候选池与相似干扰,而非只调位置编码。
辅助损失下降但 LM 质量变差,常见原因是教师 attention 只代表一条合理路径,selector 过度拟合某个 head 的概率形状,或预算迫使主干失去可替代信息。训练正常、部署突然退化,则对比候选粒度、共享规则、量化和尾页 mask,避免把实现偏差误诊成模型能力。
多证据任务要测联合覆盖。 单点 passkey 命中一次便可答对,容易掩盖 selector 只会抓最显眼证据。若答案需要 三段信息,逐段召回率分别为 ,粗略独立假设下三段同时命中的概率只有 。单段指标看起来都很高,完整推理仍可能频繁断链。
数据应标注证据组,并计算 all-evidence recall、至少命中一个证据的 any-recall 以及证据出现的最远距离。对于存在多套等价证据的问题,标签用若干可接受集合表示;强迫模型命中某一套固定 span,会把合理路径误判为错误。代码任务还要覆盖定义、调用点与修改点同时检索,工具轨迹则覆盖早期观察、后续状态和最终约束。
2.2. 让每个实验都能回到具体原因
最小消融矩阵。 一组紧凑消融应包含:无辅助损失、仅 KL、仅排序、KL 加排序;soft routing、straight-through 与 hard teacher selection;随机负样本与困难负样本;独立 head 与 GQA 共享候选;训练长度内与长度外。每组固定主 attention 预算和实际块大小。
DSA 类 indexer 还要区分稠密预热 token 数与稀疏联合训练 token 数。NSA 类结构分别关掉 compression、selection 和 window,观察某条保护路径是否掩盖选择器失败。MoBA 类结构比较 full 到 sparse 的切换时点与候选数。KDA 不进入这套 top-k 消融,它应测试状态容量、门控和 full-attention 层比例。
训练过程可以明确写成四个状态。状态 A 只收集教师统计,确认不同层和 head 的分布是否值得压缩;状态 B 冻结主干,训练 selector 到召回与 margin 达标;状态 C 开启稀疏前向,以较宽预算联合优化;状态 D 收紧到部署预算,并接入真实量化与 kernel。每次状态切换只改变一组变量,还要留出固定 token 数的重叠评测窗口。
状态 B 中 selector loss 下降而 recall 不动,应拆开边界项与尾部项的 KL 贡献,检查优化是否主要改善了不影响 top-k 的概率。增加边界排序样本可以直接监督集合交换;提高教师温度会扩散概率质量,不能默认它能解决尾部占主导的问题。recall 上升而质量覆盖不动,可能命中了更多低概率 oracle 项,需要同时检查概率加权指标。状态 C 中 LM loss 突升、selector 指标稳定,可检查主干适应、attention 归一化集合与 value 路径;状态 D 才退化,则优先比较预算、量化和 kernel 索引。
这套状态机也便于计算成本。假设稠密预热 20B token、宽预算联合训练 100B、部署预算训练 200B,报告中应分别列出三段吞吐与总 GPU 时。只报部署预算阶段200B token的稀疏吞吐,会漏掉为 selector 取得可靠起点所付出的稠密成本。若教师每 100 step 刷新一次,也把该 step 的额外计算摊回平均值。
一张验收表。 模型侧记录 LM loss、perplexity、下游准确率和长上下文任务;选择侧记录 recall@、质量覆盖、证据召回、cutoff margin、候选熵和量化前后交集;系统侧记录 selector 时间、top-k 时间、主 attention 时间、HBM 字节、索引 activation 与通信不均衡;成本侧记录稠密教师频率和完整训练 step 吞吐。
所有指标都绑定长度、层、head 或 GQA 组、块大小和预算。一个「平均召回 95%」若没有这些条件,无法判断它对应 8K 还是 1M、token 还是 block、独立候选还是共享读取。
验收表还要保留分布,不只保留均值。对每层画 与 的直方图,再按 query 位置、证据距离和任务类型切片。若总体质量覆盖为 0.97,但靠近输出的 10% 层只有 0.82,生成任务可能仍在深层整合时失败。若平均 cutoff margin 尚可,而少量长序列行接近零,线上尾部错误会集中在这些请求。
系统指标与选择指标用同一个样本 ID 对齐。某些 query 的候选分散在大量物理页上,逻辑 token 数相同,HBM 事务却更多;某些 batch 的 GQA 组并集过大,单 head recall 很高,实际读取没有下降。把 profiler 结果聚合到另一批数据上,会失去定位算法错误与布局代价的机会。
一个实用的回归门槛可以同时包含:长度内概率质量下降不超过给定阈值,长度外 all-evidence recall 不低于基线,P99 候选数不越过 kernel 档位,量化前后候选交集达到目标,端到端吞吐超过 full attention。具体数值由模型和业务决定,但不能用吞吐提升抵消证据召回失败,也不能用高召回掩盖预算溢出。
概率校准也应进入验收。把 query 按 selector 预测的覆盖置信度分桶,比较每桶真实教师质量;若模型声称有 0.9 覆盖的样本实际只有 0.6,自适应预算会过早停止。Expected Calibration Error 可以概括差距,可靠性图则能看出偏差集中在高置信还是低置信区。长度变化后重新画图,因为 32K 上校准良好的分数,面对 1M 候选时可能系统性过度自信。
线上没有稠密教师时,可以保留极小比例的影子流量,在离线环境重放完整 attention;正常请求只记录候选数、margin、距离分布、页数和耗时等不含正文的统计量。影子样本要覆盖长尾长度与低 margin 区间,随机均匀采样会被大量简单短请求占满。发现漂移后先冻结模型版本和 selector scale,再回放同一批输入,避免服务负载变化与模型变化混成一个原因。
对涉及隐私的线上数据,影子回放可以只保留经过授权的评测集与合成难例。候选统计按层和长度聚合,原始 token、页地址与用户标识都不落盘。这样仍能观察预算和边界漂移,又不会为了诊断 selector 建立另一份长上下文副本。
从一次错误反推训练环节。 假设长代码任务回答错了,稠密模型能答对。先把生成答案固定在错误前一 token,运行稠密教师与部署 selector。关键定义不在候选中,就查看教师是否把它列为高质量项;教师高、学生低,属于 selector 排序问题;教师也低,oracle 或主干 attention 已没有提供正确监督。关键定义已入选而输出仍错,则检查 sparse attention 数值、value 聚合和后续层是否再次丢失。
若错误只在 FP8 selector 出现,比较量化前后 、 与 scale。大量翻转集中在小 margin 行,可用量化感知训练、分层 scale 或更稳的次级排序;直接扩大 虽能止血,却会永久增加读取。若错误只在 batch 较大时出现,继续检查变长行 padding、候选缓冲区溢出和跨请求页表,训练 loss 无法覆盖这些实现问题。
若同一证据在 32K 能召回、128K 消失,固定 query 与正例分数,观察新增负样本中谁越过 cutoff。同主题重复块占满 top-k,说明难负样本不足;远距离正例分数系统下降,说明位置或表示外推存在偏差;selector 仍命中而 GQA 聚合后丢失,则共享规则压制了少数 head。三种现象需要完全不同的修复。
可复现性落在索引细节上。 复现实验至少保存 selector 参数版本、教师 checkpoint、温度、top-k 并列规则、负样本采样种子、块边界、尾块有效长度和 GQA 聚合方式。若使用周期性 oracle,还要记录刷新间隔与每次刷新覆盖的 token。它们共同决定训练期间实际出现的稀疏图。
检查点除了模型与优化器状态,还要包含课程进度、当前预算、温度、EMA 教师和采样器状态。恢复训练时若预算退火回到初值,模型会突然看到更多候选;若教师 EMA 丢失,KL 目标会跳变;若随机负样本序列改变,短窗口内的 route loss 也难以逐步对齐。
端到端复现应固定一小组索引探针。每次保存 checkpoint 时,对同一输入输出逐层 top-k、分数 margin 与质量覆盖。模型质量出现回归后,可以沿 checkpoint 追到最早发生候选翻转的层和长度,不必只凭最终 benchmark 猜测原因。
最终判断。 router loss 收敛只完成了训练日志中的一项。部署数据流还要用规定预算召回证据,主干能够使用这组候选,长度增加后的退化也能被指标定位。oracle 给方向,代理梯度解决可训练性,预算把模型约束到可执行形状,联合训练让主干学会在缺边的图上工作。
四者的顺序也很重要:确认教师标签与部署粒度一致之后,再选择 KL、排序或 straight-through;随后逐步收紧预算,并用真实 kernel 回放候选。若一开始就把所有技巧堆进总 loss,训练即使稳定,也很难知道究竟是哪条路径支撑了结果。
3. 教师计算与分布式训练
稠密教师会不会抵消训练节省。 如果每个稀疏训练 step都额外运行完整稠密 attention产生教师, forward成本可能重新接近平方级. DSA式预热明确接受这笔开销, 目标是先获得可靠selector; 稀疏联合阶段则要检查教师分数是全量重算、只在候选上重算, 还是由周期checkpoint提供. 三种路径的监督强度和训练成本不同.
离线教师可以预先为固定语料保存 top位置与概率, 不必在学生训练时重复稠密前向. 代价是标签绑定教师checkpoint和当时的tokenization、位置与数据增强. 学生主干继续更新后, 旧教师描述的attention偏好可能不再匹配. 在线EMA教师跟随学生更及时, 需要维护额外参数或稠密计算.
周期性刷新是中间方案. 每隔 step运行一次稠密教师, 中间使用缓存标签. 平均教师开销约降到原来的 , 标签陈旧度上升. 应记录刷新前后recall和LM loss是否跳变; 若每次刷新都出现明显冲击, 说明学生表示变化快, 太大或教师目标不稳定.
不要保存平方概率矩阵。 KL监督看起来需要教师整行分布, 长序列下直接保存 attention不可接受. 一种做法是在FlashAttention重算中流式提取 top-教师位置、对应logits与行log-sum-exp. 对选中位置 , 概率可由:
恢复. 未保存的长尾可聚合为剩余质量, 或用采样负例近似. 这样标签容量为 , 仍需说明. 只保留 top-会丢掉尾部分布, KL含义已经从全分布蒸馏变成截断蒸馏.
Block selector可在tile内直接累计块质量, 保存 的块矩阵仍可能很大. 进一步只保留每行 top blocks和LSE, 或边计算边产生困难负样本. 教师提取kernel需要与训练attention共享QK计算, 若另起一次完整前向, 省下的activation可能换成重复FLOPs.
Sequence Parallel 下怎样构造全局标签。
历史token分散在 张卡时, 每卡只拥有本地keys和局部教师候选. 全局 top-可先在本地取 项, 再交换最多 项做merge. 这与分布式检索相同, 通信从全部分数降为候选对 (score,index). 全局位置要带序列分片offset, merge后再广播学生需要的标签.
概率质量还需要全局LSE. 每卡先求局部最大值 与指数和 , all-reduce得到:
随后 . 只合并top候选而用本地分母, 会高估本地概率并给不同rank不一致的教师. 这个collective位于训练关键路径, 要进入step time.
若主attention heads按Tensor Parallel切分, 共享selector教师还要在head维聚合. 可以先各rank计算本地head贡献, 再归约token分数; 也可以让每rank生成局部重要token并合并集合. 前者更接近全局教师, 通信量大; 后者保留专用head峰值, 候选并集可能膨胀. 训练配置必须与部署时共享规则一致.
路由负载与优化器状态。 某些块长期不被选时,其 K/V 缺少来自这些 query 的直接 attention 梯度;块只是当前输入的一部分,没有各自独立的一套 MoBA 专家参数。共享投影仍可从其他位置和路径更新。带可学习 indexer 的方法还要另查打分参数的监督。物理热点确实造成负载瓶颈时,可以研究均衡约束,并同时记录证据召回,防止为分散负载而移走相关候选。
路由参数通常远小于主模型, 可使用不同学习率与优化器组. 稠密预热阶段只有selector更新时, scheduler步数不应误推进主模型的退火; 联合阶段再分别设置. 检查点必须保存各组step和momentum. 恢复时若selector优化器被重置, 候选会在短期漂移, 主模型即使参数未变也会看到不同稀疏图.
梯度裁剪最好分组记录. 主LM梯度稳定而selector梯度频繁触顶, 可能来自极小cutoff margin或少数困难样本; 全局统一裁剪会顺带压低主模型更新. 反过来, selector loss数值较小也不表示梯度小, KL温度和候选数都会改变尺度.
3.1. Oracle标签与真实输出之间还有一层距离
最大attention权重未必对应最大输出贡献。 教师注意力把分数变成概率 ,输出为 。若删去位置j并在其余位置重新归一化,输出变化可以精确写成
这条式子把“权重大”和“删掉以后影响大”分开了。 很大,但 与当前输出接近,删除影响仍可能很小; 较小,但 携带一个方向独特的特征,变化会更显著。直接用attention top-k作oracle,默认概率质量足以代表value贡献,这个近似在value高度冗余时尤其粗糙。
输出感知标签可以使用 作为单点重要性近似. 它来自式 (17) 在 较小时将 近似为 1 后的主项, 计算只需教师概率、value 和输出;高概率位置则应保留分母. 块级标签可比较删除整块后的输出变化, 或对块中单点贡献求和. 多个 value 方向可能相互抵消, 逐点求和无法完整表示这种交互;直接做块消融更准确, 成本也更高.
训练可混合两类oracle。概率质量标签稳定、容易流式计算,输出感知标签更贴近当前层表示。令
控制教师分布忠实度与输出敏感度。式 (18) 要求分母大于零;若所有有概率质量的 value 都等于输出,输出敏感度为零,此时直接退回 。这个标签描述单层局部影响,仍需结合语言模型损失检验;它可以给边界位置提供更有区分力的监督。
成组删除揭示证据之间的互补与替代。 稀疏选择一次删除很多位置,单点贡献相加无法表示交互。两个token单独删除都影响很小,合并删除却可能丢掉全部证据,因为它们互为备份;另一些token分别承载事实和限定条件,需要共同保留才能回答。集合价值可以记为
其中 是只保留集合S得到的输出,D可取均方误差、余弦距离或下游logit散度。训练selector实际在有限预算下寻找高F集合。
若F近似满足边际收益递减,贪心扩展集合具有良好性质:每轮加入让F提升最大的块。attention重归一化、value抵消和后续非线性会破坏严格次模性,因此它更适合作为oracle构造启发,而非普遍定理。离线可在小候选池上贪心生成高质量集合,再蒸馏给廉价selector。
替代证据要求标签允许多解。文档中两处都写明同一事实,固定teacher top-k可能只选其中一处,学生选择另一处仍能保持输出。将标签写成唯一二元集合会制造伪负例。可用输出保持作为软判据,或把等价证据簇标成“命中任意一个即可”。多解标签会降低表面集合recall,却更忠实地反映任务。
下游logit蒸馏把层误差映射到预测空间。 选择器最终服务于下一个token分布。令dense模型输出logit为 ,稀疏模型为 ,可加入
温度平方用于补偿软化后梯度尺度。它允许稀疏模型采用与attention教师不同的内部路径,只要预测分布保持接近。缺点是归因较弱:logit变化可能来自selector、主干适应或其他层误差,单靠输出蒸馏无法告诉哪一层漏掉了什么。
一种折中是随机选择少量层单独稀疏,其余层保持dense,测该层引起的logit KL。这样可为各层生成敏感度权重,训练时给高敏感层更强监督或更大预算。逐层消融成本高,不必覆盖每个step;周期性探针足以估计相对排序。
语言模型交叉熵与logit蒸馏也会冲突。教师在某个样本上预测错误时,完全模仿教师会阻碍学生学习正确标签;只用真值交叉熵又可能让稀疏路径偏离dense能力。可让蒸馏权重随教师真值概率变化,教师越确信正确答案,保持其分布的价值越高。
因果oracle只能使用选择时可见的信息。 标签可以由未来结果评估,selector输入却必须受部署因果性约束。例如生成完整答案后,能够知道早期哪个文档片段真正有用,并把它作为监督标签;训练时selector仍只能看当时query与历史缓存。这样的后见标签类似强化学习中的回报,不构成输入泄漏。泄漏发生在未来token、答案表示或未来层状态进入selector特征时。
应把“标签可使用的信息”和“策略可使用的信息”列成两张表。标签侧可以用dense attention、完整答案正确性、块消融和后续logit变化;策略侧只有当前层query、已缓存索引、位置与合法元数据。离线生成标签时把答案拼入双向编码器,再将该编码器表示喂给线上selector,会得到不可部署的高分。
工具调用轨迹的因果边界更细。当前决策可以读取已经返回的工具结果,下一次工具调用结果尚不可见;训练记录里二者常被存成完整轨迹,切片稍有错误就会泄漏。按事件时间戳构造可见前缀,并为每个路由决策保存visibility mask,能把约束落实到数据层。这条边界需要用自动测试固定下来。
3.2. 离散选择的梯度究竟在估计什么
Softmax松弛优化的是加权混合。 用连续门 替代 hard top-k 时, 主 attention 可以读取更多位置的加权混合. 部署函数记为 , 训练松弛函数为 . 松弛是否在温度趋零时逼近目标掩码, 取决于 的具体定义;普通 softmax 只趋向 top-1, 保留多个位置需要对应的 top-k 松弛. 有限温度下, 两个函数的前向行为不同, 梯度
描述“轻微调整每个位置权重”的收益,无法完全代表“把第k与第k+1项交换”的离散收益。温度越低,函数更接近hard选择,softmax导数也更容易集中或消失。
可用训练—部署差距直接监控松弛质量。同一batch分别运行soft门、hard门和扩大预算hard门,比较输出与梯度方向。soft质量很好而hard质量差,说明主干利用了大量小权重;两者前向接近但selector梯度方向差异大,则可能存在边界不稳定。只观察训练loss无法区分这两种情况。
稀疏化可以使用连续阈值门,再在后期切换top-k。阈值门允许每行候选数变化,适合学习“哪些位置值得保留”;top-k强制固定容量,适合部署。切换前需让阈值产生的候选数分布靠近目标K,否则一次形状变化会同时改变质量和负载。
Straight-through估计器的偏差可以被测量。 straight-through把hard前向的梯度替换成soft代理梯度。设真实期望目标为 ,代理给出的 一般有偏。小候选空间中可以枚举或有限差分估计真实变化:逐个提高边界候选分数,观察hard集合翻转后的loss差,再与代理梯度符号比较。
符号一致率比梯度均方误差更有解释力。选择问题关心某个候选应上升还是下降;尺度可以由优化器吸收,方向反转会持续强化错误排序。可在训练探针上报告边界位置的符号一致率、余弦相似度以及发生集合翻转时的实际loss变化。
代理温度、margin和候选间隔共同影响偏差。分数差很大时,集合稳定,代理梯度主要做无用的继续拉开;分数接近时,集合敏感,过低温度又可能让梯度只落到当前赢家。训练可把梯度重点放在一个cutoff带内,例如第 到 名,避免对显然无关的长尾消耗容量。
随机门控可以得到无偏但高方差的估计。 将选择视为从分布 采样集合,REINFORCE给出
在采样与损失计算正确时,该估计无偏;集合空间巨大,方差往往难以接受。baseline b可取同query的滑动平均、dense损失或另一个价值网络。采样若直接从百万token中进行,绝大多数集合质量很低,学习信号接近噪声。
分层采样可先由便宜规则缩小候选池,再在池内随机探索。还可成对采样两个仅差一个块的集合,用损失差作为局部优势,抵消共享噪声。它与困难负样本排序相连:排序loss使用教师给局部交换定方向,策略梯度使用任务loss评估交换结果。
随机估计更适合后期微调少量边界选择,而非从零训练整个indexer。先靠蒸馏建立可用排序,再用任务回报修正教师代理目标与真实质量的偏差,可以显著缩小探索空间。
Gumbel扰动训练的是随机排序分布。 给每个分数加入独立Gumbel噪声再取top-k,可从无放回的排序分布采样集合。训练中使用可微近似,能让边界外候选按分数获得探索概率。噪声尺度大时集合多样,主干承受更强随机缺失;尺度小时接近确定top-k,探索迅速消失。
随机路由相当于结构化dropout,会迫使模型减少对单一路径的脆弱依赖,也可能降低精确检索能力。应分别测确定推理与随机训练下的质量,确认收益来自鲁棒性而非测试时继续采样多个集合。线上若只运行一次确定top-k,训练目标最终要向该行为收敛。
Gumbel噪声的可复现性涉及sequence parallel。各设备若对同一全局候选生成不同噪声,归约后集合不再对应单一采样;应使用全局位置派生随机数或由负责分片生成并带分数归并。activation重算也要恢复同一随机流,否则backward看见另一集合。