联合评测的关键是让同一条请求贯穿四层:任务层知道答案和证据,模型层知道 dense 与 sparse 输出,路由层知道候选覆盖,系统层知道真实字节和时间。四张各自漂亮的汇总表无法互相解释;逐请求 join 后,才能回答「这个错误是否由证据漏选造成」「这次加速是否来自少读 KV」。
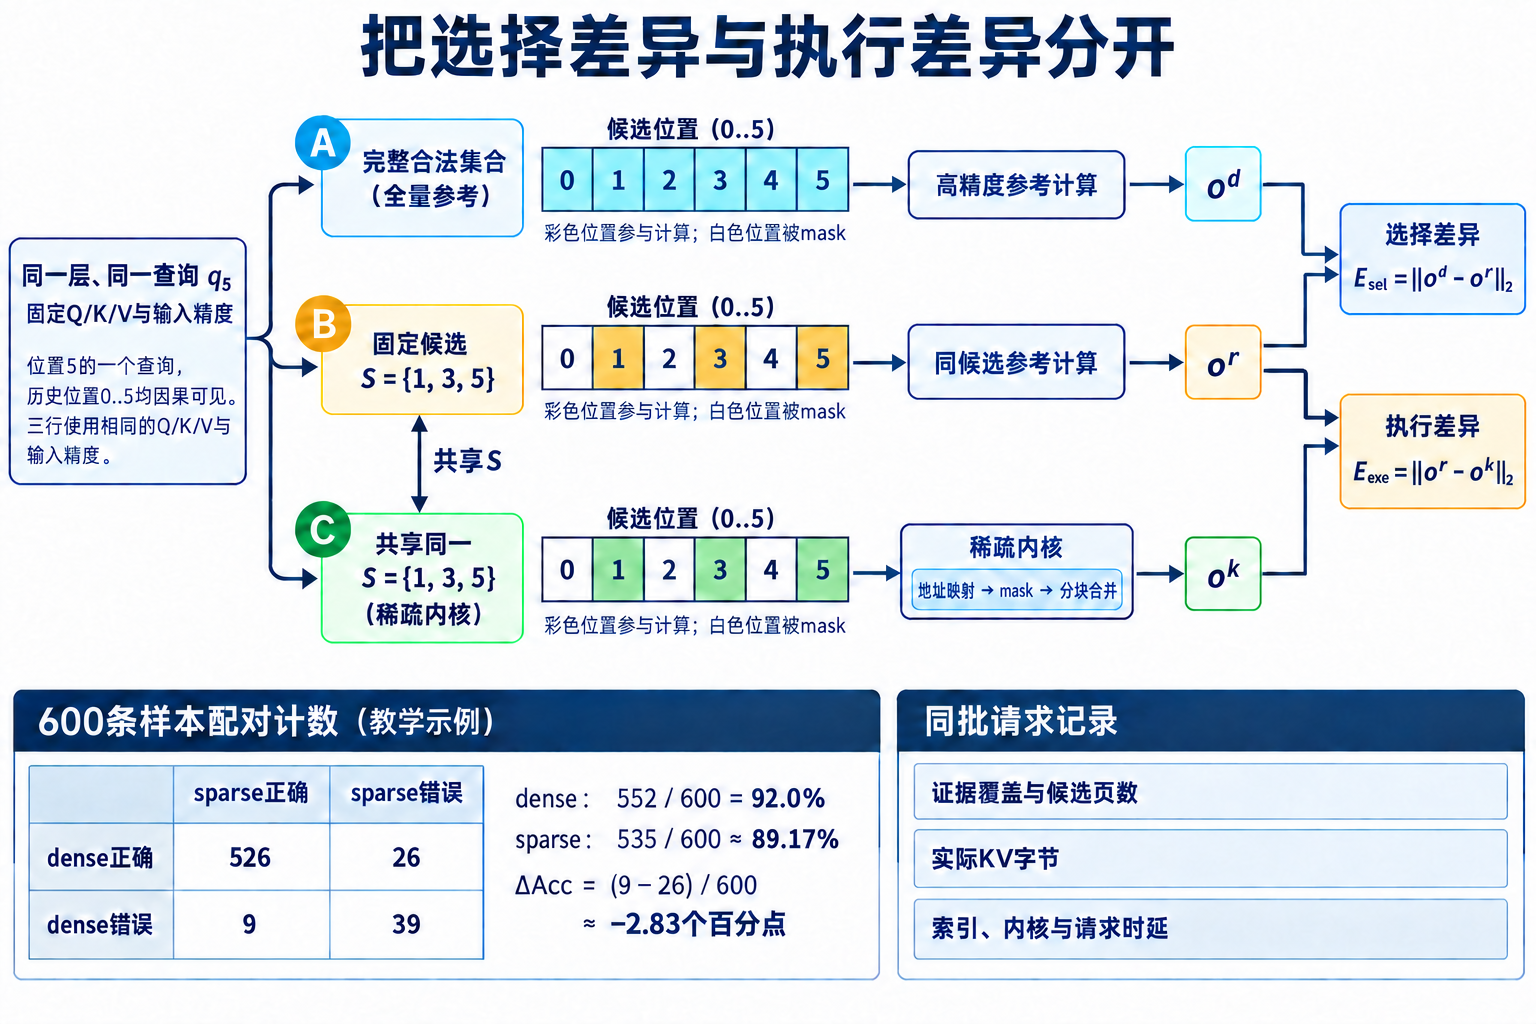
图1:固定同一层、查询和Q/K/V,完整合法集合得到参考输出;冻结实际候选后,同候选参考实现得到,待测内核得到。前两者的差异诊断删边影响,后两者的差异诊断执行误差。双向线表示B、C使用同一个候选集合,不复用参考输出。下方为600条样本的教学配对计数,非真实实验结果。

1. 数据记录与 Full Attention 对照
1.1. 逐请求 schema
每条记录至少包含 request_id、任务、样本 ID、token 长度、证据 span、证据深度、证据数、干扰类型、随机种子、dense/sparse 答案与分数。路由字段包含每层每 head 的候选数、证据召回、dense mass、block/page 数和 cutoff margin;系统字段包含 selector、top-k、index、prefill、decode、归并、队列时间与 HBM 字节。 原始候选可能暴露正文位置或占用大量空间,可保存聚合统计,并在受控离线环境保留少量可回放样本。配置与代码 commit 单独写 manifest,结果表引用 manifest hash,避免同名实验使用不同 kernel 或 prompt。
1.2. 四格配对结果
对准确率任务,将样本分成:dense/sparse 都对 ,dense 对 sparse 错 ,dense 错 sparse 对 ,两者都错 。质量差额为
若 ,sparse 比 dense 低 2.5 个百分点。只报 sparse 的 78% 无法知道基座本身是多少。McNemar 检验关注 与 ,比把两组当独立样本更合适。 开放生成用相同 judge、相同顺序随机化和盲评;自动 F1/ROUGE 与人工抽样并列。dense 失败样本仍保留,因为 sparse 偶尔通过压缩或去噪改正错误,这些 能揭示结构差异。
2. 质量任务矩阵
2.1. Needle、RULER 与 LongBench
Needle 网格用于连通性诊断。长度 ,深度 ,每格至少多个随机种子。针的措辞、实体和背景主题轮换;加入不存在的 key 检查幻觉。答案 exact match,另保存容错规范化规则。 RULER 官方实现支持可配置长度与任务复杂度,13 个任务分属四类,适合测单针、多 key、多 query、变量追踪与聚合。记录每个子任务曲线,不用一个平均分盖住变量追踪崩溃。LongBench 有 21 个中英文与代码任务,LongBench-E 还平衡不同长度区间;使用官方 prompt、最大生成长度与 metric,注明是否发生 head-tail 截断。 真实任务与合成任务相互校验。合成任务能精确标注证据位置,适合路由归因;真实任务包含摘要、代码和多文档推理,能发现「证据进入候选但模型仍不会组合」的问题。
2.2. 长度、深度、证据数分离
一次只改变一个主变量。固定 64K 改证据深度,得到位置敏感曲线;固定深度改长度,得到候选竞争曲线;固定长度改证据数与相似干扰,得到联合召回曲线。把三项同时增加,分数下降后无法归因。 深度用 token 位置而非字符比例计算。prompt 模板、问题和预留输出也计入窗口,实际证据距 query 的 token 数单独保存。对 sliding window 方法,距离决定结构可达性;对动态选择器,总候选数量与相似负例决定排序难度。
多证据联合覆盖。 样本证据集合为 。any recall 检查至少一段进入候选,all recall 要求全部进入:
还可记录覆盖比例 。答案要求比较、合取或排序时,all recall 更接近最低条件。存在多套等价证据时,用若干可接受集合,命中任一完整集合即可。
3. 路由诊断
3.1. attention mass 与证据召回
dense 教师分布 下,候选质量覆盖为
若候选以 block/page 执行,同时计算逻辑 token mass 与物理扩张后的 mass。高 、低证据召回说明 dense attention 本身没把标注证据视为高权重,或任务需要多层传播;低 、答案仍对说明存在冗余路径,不能把 attention mass 当唯一真值。 按层与 head 报告 的均值、P10 和失败样本分布。平均 0.95 可能由浅层局部 head 抬高,关键深层只有 0.6。GQA 共享候选还要比较 per-head oracle 与组共享候选,量化共享造成的损失。
3.2. 候选稳定性
对不改变答案的 prompt 改写、段落重排和无关填充,计算候选 Jaccard 与证据覆盖差。稳定性不要求候选完全相同,而要求关键证据不因小扰动掉出。cutoff margin 小的 query 单独成桶,检查 FP8 selector 与不同 top-k kernel 是否翻转排序。 候选预算记录平均、P95、P99 和最大值。阈值路由常在难样本上扩大候选,质量稳定却可能抬高尾延迟。固定 top-k 则系统稳定,质量风险集中在平坦分布。二者用质量—实际 KV 字节曲线比较。
4. 系统基准
4.1. microbenchmark 的计时边界
四个边界分别测:dense FMHA;固定 indices 的 sparse kernel;索引规范化加 sparse kernel;selector 到输出的完整 attention。每组统一 QKV 投影、RoPE、mask 和输出投影是否计入。JIT、autotune 与首次分配在正式计时前完成,GPU event 记录设备时间。 输入形状覆盖 prefill 的多 query、decode 的单 query、不同 GQA 比例、候选率和候选聚集度。随机均匀 mask 之外,使用真实路由统计生成长尾行、热门页与共享 prefix。报告 median/P95/P99、DRAM bytes、带宽、FLOPs、L2 hit、workspace 和峰值显存。
4.2. TTFT、TPOT 与吞吐
TTFT 从请求到达到首 token 可见,分解为 queue、schedule、prefill、首步 decode。TPOT 定义为后续输出 token 的平均时间,ITL 还保留逐 token 分布。固定输出长度 时,总时间近似
例如 TTFT 从 800 ms 降到 400 ms,TPOT 从 20 ms 降到 16 ms,输出 101 token 时,总时间由 2800 ms 降到 2000 ms,加速 1.4 倍;只报 prefill 2 倍会高估用户收益。 吞吐同时给 requests/s、input tokens/s、output tokens/s。batch 与并发固定时比较延迟;SLO 固定时比较最大吞吐。稀疏路径节省显存后可能容纳更大 batch,这属于容量收益,应与同 batch 的 kernel 收益分开。
HBM 与索引成本。 理论 KV 字节由物理读取 token 数、KV heads、head dimension 和 dtype 计算,profiler 的 DRAM bytes 用来检查事务放大。索引成本包含 selector key 读取、score、top-k、去重、排序、页表与 workspace 清零。总 attention 时间为
每项既报绝对时间也报占比。kernel 加速 5 倍而 selector 占 40%,端到端上限受 Amdahl 定律约束。
5. 服务负载
5.1. open-loop 与 closed-loop
按 Poisson 或回放真实时间戳注入请求,扫描到达率,例如 1、2、4、8、16 req/s。系统过载后继续到达,请求进入队列,P99 会在饱和点附近急升。每个点运行足够长时间覆盖稳态,丢弃启动阶段,报告完成数、拒绝数、队列长度和 SLO 达标率。
closed-loop。 设置 1、4、16、64 个客户端,每个客户端收到完整响应后发送下一条。它限制在途请求数,适合交互业务的并发扫描。与 open-loop 使用相同输入长度和输出长度分布,结果分别命名,不能把 closed-loop 的低排队时延当固定到达率表现。 continuous batching 参数、最大 tokens/batch、chunked prefill、调度优先级和 prefix cache 命中率全部固定。稀疏 selector 的 ragged 候选可能改变 batch 组成,因此还要保存实际 batch size、padding、候选最大/平均比。
5.2. 统计置信区间与失败归因
配对 bootstrap。 对 条请求有差值 。从索引 有放回抽样 次,计算均值,重复 10000 次,取 2.5% 与 97.5% 分位数作为 95% 区间。抽样单位是原始样本;同一文档派生多个深度版本时,应按文档 cluster bootstrap,避免把相关样本当独立证据。 若平均差为 -0.8 分,区间 ,下降虽小但数据支持稳定负差;区间 则无法排除无差异。实际可接受阈值应预先设定,例如非劣界 -1 分,再判断区间下界是否越界。
延迟分位数。 时延重尾,不用正态均值区间描述 P99。按请求 bootstrap,重新计算 P50/P95/P99;open-loop 还可按时间窗口 block bootstrap,保留突发相关性。报告样本数与区间,少量请求算出的 P99 可信度很低。 多长度、多任务同时检验会增加偶然显著结果。主指标与主长度在实验前指定,其余作为分层诊断;需要作强结论时使用多重比较修正。结果表保留 effect size,不只给 p 值。
失败归因矩阵。
| 质量 | 证据召回 / mass | kernel | 端到端 | 首要检查 |
|---|---|---|---|---|
| 下降 | 下降 | 正常 | 正常 | selector、候选预算、长度外推 |
| 下降 | 正常 | 正常 | 正常 | 候选内 attention、层间传播、训练适配 |
| 正常 | 正常 | 慢 | 慢 | block 扩张、gather、tile、带宽 |
| 正常 | 正常 | 快 | 慢 | top-k、索引、plan、队列与 fallback |
| 波动 | margin 很小 | 波动 | 尾延迟高 | 量化翻转、ragged 长尾、动态编译 |
从单条失败开始。
dense 对 sparse 错时,先检查标注证据是否进入任何关键层候选。未进入,比较 selector score、cutoff margin 与相似负例;已经进入,再比较候选内 logits、mass、value 输出和后续层是否丢失。dense 也错时,该样本用于任务难度分析,不直接计为 sparse 特有故障。 质量正常而系统不快时,对照逻辑 token、物理 page、DRAM bytes。实际字节远高于逻辑值,检查页扩张和随机事务;kernel 快而端到端慢,拆 selector、top-k、CPU plan 与 CUDA Graph miss。P50 快、P99 慢时,按最大候选行、fallback 与 workspace 扩容切片。
一次可复算汇总。
假设 64K RULER 子集 1000 条,dense 92.0%,sparse 90.8%,配对 bootstrap 的 ,95% 区间 。dense 对 sparse 错 31 条,其中 24 条 all-evidence recall 为 0;剩余 7 条证据已覆盖。于是主要质量损失可定位到漏选,同时保留 7 条候选内失败继续分析。 同批请求 dense TTFT P50/P99 为 900/1450 ms,sparse 为 520/1100 ms;TPOT 为 19/31 ms 与 14/29 ms。kernel-only 加速 3.4 倍,完整 attention 加速 2.1 倍,端到端 TTFT 加速 1.73 倍。HBM 字节下降 4.6 倍,selector+index 占 sparse attention 时间 27%。这些数字共同说明收益存在,也明确了质量代价和下一处性能瓶颈。
6. 联合评测、回归与结果解释
6.1. 64K 联合评测与预算扫描
64K 联合评测手算。
样本与候选。
构造 600 条 64K 样本,其中单证据、双证据、四证据各 200 条。每组证据深度在 10%、30%、50%、70%、90% 均匀分配,每格 40 条;一半样本加入 16 个同主题干扰块。dense 与 sparse 使用同一 checkpoint、greedy decode 和最大输出 64 token。 假设 sparse 每个 query 选择 256 个 16-token pages,另保留 16 个窗口页,去重后平均 266 页,即 4256 个物理 token。相对 65536 token,逻辑读取率为 。kernel 以 64-token tile 运行,真实路由统计显示平均需要 190 tiles,即物理计算容量 12160 token,tile 有效率 。 若 8 个 BF16 KV heads、head dimension 128,每 token K+V 为 字节。理想 sparse KV 读取约
dense则为256 MiB。16.625 MiB只计算4256个候选位置;若190个tile都完整装载,且每个KV head各读一次,输入读取量为。以下假设profiler记录50 MiB,比完整tile输入略高,包含事务与元数据开销,相对dense减少5.12倍。若实测HBM字节低于47.5 MiB,要进一步检查L2复用、实际装载粒度和计时范围,不能只归因于事务放大。这里及后续表格均为教学假设数据。
质量与路由配对。
dense 答对 552 条,sparse 答对 535 条。四格计数设为 ,于是 dense 92.0%,sparse 89.17%,差额
26 条 dense 对 sparse 错的样本中,18 条未覆盖任何标注证据,5 条只覆盖部分证据,3 条完整覆盖。前 23 条检查 selector 与预算,其余 3 条进入候选内数值和层间传播分析。9 条 sparse 独有成功也要人工抽样,检查压缩去噪、答案格式差异或 dense 偶发生成错误。 按证据数拆分后,单、双、四证据 sparse 准确率为 94%、90%、83.5%,对应 all-evidence recall 为 98%、93%、84%。accuracy 与 all recall 同步下降,支持联合覆盖是主要瓶颈。若any recall仍保持在95%以上,只报 any recall 会完全掩盖多证据断链。
系统总时间。
固定输出 65 token,dense TTFT 820 ms、TPOT 18 ms,sparse TTFT 480 ms、TPOT 13 ms。总时间分别为
完整请求加速 1.50 倍。sparse TTFT 内部为 selector 65 ms、top-k/索引 38 ms、attention 290 ms、其余 87 ms;selector 与索引合计占 21.5%。若只优化 290 ms 的 attention,即使无限加速,TTFT 下限仍是 190 ms。 这组结果不能直接宣称 sparse 更优,因为质量下降 2.83 点。下一轮应画 budget sweep:128、256、384、512 pages 分别给出准确率、all recall、TTFT 与 DRAM bytes,找满足预设非劣界的最小预算。联合评测的产物是一条质量—成本前沿,而非单个最快配置。
可复算的预算扫描。
同一模型扫候选预算。
每个预算使用相同 600 条样本与请求顺序。示例结果如下:
| pages | 准确率 | all recall | TTFT P50 | DRAM bytes | |
|---|---|---|---|---|---|
| 128 | 84.5% | -7.5 | 78.0% | 390 ms | 19 MiB |
| 256 | 89.2% | -2.8 | 91.7% | 480 ms | 50 MiB |
| 384 | 91.2% | -0.8 | 96.8% | 565 ms | 66 MiB |
| 512 | 91.7% | -0.3 | 98.2% | 650 ms | 87 MiB |
| Dense | 92.0% | 0 | 100% | 820 ms | 256 MiB |
若非劣界预设为-1个百分点,384 pages是表中第一个点估计达标的配置,TTFT加速约1.45倍。确认非劣还需要预先约定的配对置信区间,其下界也超过-1;这张表没有区间,不能据此确认最小合格预算。128 pages的点估计明显越界;512 pages质量更接近dense,速度收益缩小。预算选择由约束与统计证据共同决定。
长度改变后重扫。
固定 384 pages 从 16K 扩到 128K,候选比例从 37.5% 降到 4.69%,速度更有利,selector 难度却上升。每个长度都重算质量差额与 all recall。若 16K 的 、32K 为 -0.4、64K 为 -0.8、128K 为 -3.1,不能用四档平均 -1.125 概括;128K 已越过可用边界。 也可以保持候选比例固定,但那会让 pages 随长度线性增长,复杂度与服务成本随之上涨。固定预算与固定比例回答不同问题,两条曲线都值得报告。自适应阈值路由再额外报告 pages 的 P50/P95/P99,防止均值隐藏难样本扩容。
6.2. 控制变量、停止规则与失败复现
benchmark 的控制变量。
模型与生成。
Full 与 sparse 使用同一权重;若 sparse 经过继续训练,增加两个基线:训练前 dense 与训练后 dense。前者衡量整体改造,后者把训练收益与稀疏推理损失拆开。tokenizer、chat template、system prompt、stop token、temperature、top-p、最大输出与 repetition penalty 完全一致。 长输入发生截断时,保存截断前后 token 数和策略。LongBench 常见 head-tail 截断会直接改变证据可见性;模型窗口足够时关闭截断,必须截断时 dense/sparse 使用同一结果。RULER 的生成器版本、任务集合和每档样本数写入 manifest。 judge 模型会带来额外随机性与位置偏差。可 exact match 的任务优先使用规则;开放题固定 judge 版本与 prompt,交换答案顺序复评一部分样本。人工核验集中在 dense/sparse 不一致样本,而非只看随机总体样本。
硬件与软件。
记录 GPU 完整型号、数量、互连、显存容量、功耗上限、驱动、CUDA、框架和 kernel commit。锁频不可用时保存每轮实际频率与温度。MIG、其他进程与共享云实例会污染尾延迟,应隔离或明确说明。 dense 基线使用当前优化实现,并与 sparse 统一 dtype、KV layout、GQA、quantization、CUDA Graph 和 prefix cache。一个路径使用 FP8 KV、另一个使用 BF16,字节与速度没有直接可比性。workspace 预留与最大 batch 同样计入显存。 基准顺序交错,例如 ABBA,而非先跑完 dense 再跑 sparse,降低温度和系统负载漂移。每个配置至少独立启动多轮;同一进程内重复反映短期波动,重启后的重复还能暴露编译缓存和 allocator 状态。
batch 与调度。
离线测试固定 batch size,并报告实际有效 token 数;在线测试固定请求 trace 和调度器参数。continuous batching 的最大序列数、最大 batch tokens、chunked prefill 大小与优先级会改变 TTFT/TPOT 权衡。
稀疏方法可能以更小显存承载更多请求。等 batch 比较展示单请求效率,等显存比较展示容量收益,等 SLO 比较展示服务价值。三种口径分别命名。把 sparse 的最大 batch 与 dense 的小 batch 直接比较,会把容量和 kernel 两种收益混在一起。
置信区间手算与停止规则。
二项准确率的直觉。
若 600 条样本准确率约 90%,独立近似下标准误差为
单模型 95% 区间宽度约 点。配对设计利用同一样本,差值方差通常更小,但 0.3 点差异仍很难由 600 条样本确认。要论证极小非劣界,需更多样本或多次生成;不能把「看起来接近」写成等价。 多深度版本来自同一原文时相互相关。以原文为 cluster 有放回抽样,每次带上该原文的全部长度/深度变体,再算曲线与差额。普通逐行 bootstrap 会把有效样本数夸大,区间过窄。
性能样本。
延迟基准在预热后采集 1000–10000 个请求。P99 位于样本尾部,1000 条只有约 10 个观察落在其上方,区间仍可能很宽。open-loop 以时间窗口分块重采样,保留排队相关性;把每条请求当独立样本会低估突发带来的不确定性。
实验在达到预设样本数或时间后结束。中途查看结果只用于健康检查,不因当前加速明显而提前停止。失败重跑规则也预先定义,例如硬件 Xid、进程崩溃或日志缺字段可作废;质量不好、P99 太高不属于作废理由。
三类失败的复现实验。
selector 漏选。
选择 dense 对 sparse 错、all recall 为 0 的样本,固定 query hidden state 和 dense 教师分布。依次扩大预算、改用教师 top-k、移除相似干扰。教师 top-k 能恢复答案,说明主干与 kernel 有能力完成任务;扩大预算恢复说明 cutoff 问题;移除干扰恢复说明负样本排序问题。三步形成可反驳链条。
候选覆盖但答案错误。
固定 sparse 候选,用朴素 gather attention 与优化 kernel 比较输出。两者不一致进入 kernel 数值诊断;一致则逐层替换为 dense attention,寻找最早恢复答案的层组。若所有层候选都覆盖证据,仍可能因被裁掉的背景 mass 改变归一化或训练适配不足。
kernel 快、服务慢。
同一 trace 下逐步打开 selector、索引、CUDA Graph、continuous batching 与 prefix cache,形成瀑布表。kernel-only 45 微秒、完整 attention 90 微秒、服务单步 180 微秒时,分别核对 top-k/index 与调度/同步。Nsight 时间线和服务事件使用同一 request ID 对齐。
若 P99 只在候选超过 workspace 档位时出现,固定这批请求重放并预先扩容;尖峰消失即可验证分配假设。若扩容后仍存在,再检查 dense fallback、JIT 与 CPU plan。一次只改变一个开关,故障才有清楚归属。
6.3. 从路由指标走到最终输出
路由指标与最终输出之间的桥。
输出扰动。
候选质量覆盖 很高时,仍可能漏掉方向特殊的 value。对同一 query 保存 dense 输出 与固定候选输出 ,计算
把 与 、证据召回和最终答案正确性作散点图。若 高而 大,检查被裁位置的 value 范数与方向;若单层 小、深层 hidden state 差异持续扩大,残差和后续非线性在放大扰动。 还可做候选替换实验。保持候选数量不变,将 selector 候选依次替换成 dense top-k、随机候选和标注证据块。dense top-k 恢复质量,说明 selector 排序有改进空间;标注证据块仍无法恢复,说明任务依赖更广背景或主干未适应稀疏分布;随机候选与 selector 相近,则当前路由信号价值有限。
层组回退。
逐层全开 dense 的成本很高,可以按层组回退。模型有 32 层时,以 4 层为组,先把第 1–4 层切回 dense,其余保持 sparse,随后测试 5–8 层,得到敏感层组。找到关键组后再逐层细分。
回退实验同时记录质量与 HBM。某个层组恢复 80% 的质量差额,只增加 10% 字节,可以形成混合部署方案;若每组贡献均匀,问题更像全局预算不足。回退顺序和候选缓存要固定,避免上游 dense 表示改变下游 selector 后无法比较。
attention mass 的局限通过实验处理。
dense attention 权重是诊断参照,其可靠性由干预检验。把教师高 mass、低 mass 的位置分别遮掉,观察输出与答案变化;高 mass 遮掉影响更大时,教师排序在该任务上具有预测力。若相关性很弱,继续用 mass 作为唯一 oracle 会误导 selector 评测,此时提高证据标注和输出扰动的权重。 不同 head 的概率不可直接平均后声称覆盖。一个专门检索变量定义的 head 可能只有很小组权重,却决定代码答案。按 head 计算 mass 与输出扰动,再用 GQA 组实际共享规则聚合,能看到少数 head 是否被多数局部 head 淹没。
服务负载的完整核算。
open-loop 饱和曲线手算。
设服务在稀疏配置下稳定处理 12 req/s,dense 为 8 req/s。open-loop 以 2 req/s 递增注入。在 6 req/s 时两者队列接近零;10 req/s 时 sparse 仍稳定,dense 到达率超过服务率,队列持续增长。此时比较固定 5 分钟的 P99 会受到测试终止时间影响,应同时报告完成率与队列斜率。 以简化 M/M/1 直觉,利用率 接近 1 时,等待会非线性增长。sparse 在 时 ,dense的 已不稳定。饱和点本身就是结果,超过饱和点的时延只表示系统积压,不能当稳态延迟横向比较。 到达过程至少包含 Poisson、固定间隔和真实 burst trace。Poisson 便于复算,固定间隔消除到达方差,真实 trace 检查业务突发。每种 trace 使用相同 request ID 与输入长度序列,调度器看到的工作量才能配对。
prefix 与长尾请求。
构造 80% 8K、15% 64K、5% 128K 的长尾 trace,分别设置 0%、50%、90% prefix 命中。prefix 命中减少 prefill,却不一定减少 decode 的动态 selector 扫描;共享页还可能改善 cache locality。TTFT、TPOT 与 HBM 按命中状态分桶。
长请求会占据更多 KV cache 和 prefill 时间。chunked prefill 将其切片后与 decode 交错,可以改善短请求 TPOT,却延长长请求 TTFT。dense/sparse 使用相同 chunk size,再额外扫一组最优 chunk size,区分机制收益与调参收益。 调度公平性用每个长度桶的 slowdown 表示:请求实际时延除以独占运行时延。总体吞吐提高时,若 128K 请求 slowdown 急剧上升,系统在牺牲长请求。候选 ragged 还可能让同长度请求出现不同 slowdown,因此加入物理 page 数分桶。
SLO 容量。
预设 SLO,例如 TTFT P99 小于 1.5 秒、TPOT P99 小于 30 ms。逐步增加 open-loop 到达率,找到两项均达标的最大负载。dense 最大 6 req/s、sparse 最大 10 req/s 时,SLO 容量提升 倍。 显存也形成容量约束。相同 GPU 上 dense 最多并发 32、sparse 最多 48 时,分别在各自最大并发测吞吐属于等显存结果;两者都并发 32 属于等 batch 结果。报告把两个数字放在不同列,避免将 48 对 32 的吞吐提升全部归到 kernel。
训练评测。
等 token、等算力与等质量。
等 token 比较在相同训练 token 后的 loss 和任务质量,能看稀疏结构的样本效率;等算力按 GPU-hours 或实际 FLOPs 对齐,允许更快结构训练更多 token;等质量比较达到目标 validation loss 所需的总时间。三种结果共同描述训练价值。 例如 dense 训练 100B token 用 1000 GPU-hours,loss 2.5;sparse 100B token 用 700 GPU-hours,loss 2.55。sparse 训练到 130B token、910 GPU-hours 后达到 loss 2.5。它在等 token 下质量略差,等质量下仍节省 9% 时间。只报单 step 快 30% 会遗漏多训练的 30B token。
完整 step 分解。
记录数据等待、forward attention、其他 forward、backward attention、其他 backward、通信和优化器。sparse backward 的索引转置与 归约单列。forward 加速后通信占比上升,完整 step 收益受 Amdahl 限制。 训练吞吐以有效非 padding tokens/s 计算。长短序列混批时,按最大长度 padding 会虚增 token 计数;packing 后保存每条序列边界,attention mask 也要阻止跨样本访问。稀疏索引构造不能错误跨越 packed sequence。
收敛与稳定性。
每个配置运行多个训练种子,保存 loss、gradient norm、selector recall、候选熵和 fallback。均值 loss 接近而某个种子路由坍缩,仍是稳定性风险。曲线按 token 与 wall-clock 两个横轴绘制,分别展示统计效率和系统效率。 长度课程阶段切换时,在固定探针集运行 dense/sparse 配对评测。loss 台阶伴随 recall 下降,优先检查 selector;recall 稳定而 loss 上升,检查主干适配、学习率和归一化。训练结束后的一个总分无法定位阶段性退化。
评测产物与自动回归。
文件结构与校验。
每次实验产出不可变 manifest、逐请求结果、逐层路由摘要、系统 trace、汇总表和环境信息。manifest 记录所有输入文件 hash;汇总脚本只读取逐请求表,不手工改数字。图表标注 experiment ID,可以回到原始行。 敏感正文不进入共享 trace。保留 token 数、证据 span 的匿名编号、候选距离和页复用统计;需要复现的公开 benchmark 保存样本 ID 与官方版本。内部数据用受控 runner 重新生成相同聚合指标。
回归门槛。
小型 CI 每次改动运行 4K/16K 少量样本,检查 dense 对齐、候选召回、数值误差和 fallback;每日运行 64K 质量—系统联合集;发布前运行完整 LongBench、RULER、长度深度网格和 open-loop 服务 trace。 门槛采用绝对值与相对差:dense/sparse 输出最大误差、任务 、all recall、TTFT/TPOT P99、DRAM bytes 与 workspace。性能噪声较大时使用历史分布控制线,连续多次回归再报警;质量差异通常确定性更强,一次越过硬门槛便阻止发布。
结果表的最小字段。
公开结果至少列模型、训练方式、长度、任务、样本数、dense/sparse 分数、配对差额与区间、候选预算、逻辑/物理读取、硬件、dtype、batch、TTFT、TPOT、吞吐、HBM 和计时边界。缺少样本数与区间,质量差难以解释;缺少物理读取与完整路径时间,加速难以复算。 同一篇报告的图表统一采用 manifest 中的配置名。预算 256 pages、block 16、GQA 共享与 selector FP8 都属于配置的一部分。只写方法名会让后续读者无法知道不同表格是否对应同一实现。
语义突兀会泄露位置。
经典 needle 把一条城市与数字事实塞进风格完全不同的长文,模型可能依靠异常表达定位,而非稳定访问任意位置。更严格的版本让 haystack 全部由同形的 KEY = VALUE 记录组成,needle 与干扰项在格式和主题上保持一致,key 与 value 每轮随机生成。
位置网格加入 jitter。若每次 50% 深度都落在完全相同 token 附近,模型或 cache 布局可能对固定边界形成偶然优势。设目标深度 ,在 随机取实际位置,同时保存 token offset。每个格子的颜色来自多次重复,而非一次成败。 不存在的 key 占 10%–20%,正确答案为明确的「未找到」。它衡量模型是否在长上下文压力下编造近似 value。只统计存在 needle 的召回,会奖励总是猜一个值的策略。报告把召回率、拒答准确率和宏平均分别列出。
多针与顺序关系。
多针测试不能只一次问出十个互不相关的 value,因为答案长度和格式解析会成为新变量。可以将十个 query 拆成独立请求,共享同一 haystack;也可以保留联合请求,同时给出逐 key exact match、all-correct 和输出格式错误率。
顺序任务要求找出多个事件并按时间或位置排序。selector 命中全部证据只是最低条件,模型还要保留相对位置。记录 evidence recall、顺序准确率和答案准确率,能区分漏选与排序推理失败。 threading 任务让一个 needle 指向下一个 key,形成长度 2、4、8 的链。每一步的条件依赖前一步结果,各步独立且每步召回95%时,八步联合命中的近似概率为 。链长曲线比单针更容易暴露小概率漏选的累积影响。
真实任务中的证据标注。
LongBench 一类真实任务不总有完整 evidence span。可对 dense/sparse 不一致子集补充人工标注:答案依赖的最小 span、可替代 span、跨文档关系和无关高相似段。两名标注者独立完成,冲突由第三人裁决,并报告一致率。
摘要任务很难列出唯一证据,可把源文切成语义段,使用删除实验估计段落影响:遮掉某段后 dense 摘要的事实覆盖下降,该段成为候选证据。删除会改变上下文流畅性,结果只作诊断;最终仍以事实单元覆盖与人工检查为准。 代码任务记录符号定义、调用点、类型约束和目标修改位置。一个答案可能需要同时访问声明文件与测试文件,all-evidence recall 比单个 span 更合适。仓库路径与文件长度还可解释 page 分散度,连接质量失败和 HBM 随机读取。 多文档问答保存每份文档的角色:支持、反驳、背景、干扰。selector 只命中支持文档而漏掉反驳文档,答案可能显得合理却不完整。按角色计算 recall,能够发现总 evidence recall 相同、错误性质完全不同的样本。
一张发布前验收表。
发布候选配置固定后,质量侧填写短上下文回归、LongBench 分类分数、RULER 长度曲线、needle 长度—深度网格、多证据 all recall、dense 配对差额及区间。路由侧填写 mass、证据召回、margin、候选 pages 分位数和量化前后交集。 系统侧填写 dense、固定候选和完整 sparse 三档时间,prefill/decode 分离,TTFT/TPOT/吞吐/P99 齐全;HBM、workspace、峰值显存、fallback 与 CUDA Graph miss 同时记录。服务侧填写 open/closed-loop 饱和点、SLO 最大负载和不同长度桶 slowdown。 任何红项都保留对应 request IDs 与复现命令。质量红项能回到证据、候选和层组;性能红项能回到 trace、kernel shape 和 workspace 档位。验收表的作用是把发布判断绑定到可重跑证据,避免同一个平均分覆盖互相冲突的局部结果。
首次运行不能混进稳态延迟。
稀疏路径常包含JIT编译、autotune、CUDA Graph捕获、workspace分配和page table初始化. 首次请求若把这些开销全算进TTFT, 会夸大常规用户延迟; 完全删掉又会掩盖扩容、模型热更新或新shape到来时的真实尖峰. 报告应分成冷启动、预热后稳态和容量越界重规划三组. 冷启动从新进程或清空编译缓存开始, 记录模型加载以外的首次shape准备. 稳态先运行固定warm-up, 再在不触发新分配的条件下计时. 重规划测试让候选数或batch跨过容量档位, 测量退出Graph、扩容和重新捕获. 三组回答不同问题, 不能取一个平均值.
线上新版本灰度时, 编译缓存可能按GPU型号、驱动、kernel hash与shape键命中. Manifest要记录缓存状态. 两次实验若一边命中、一边重新编译, 端到端差额不能归因于算法. 对动态长度流量, 还要报告多少请求触发新shape, 以及shape归桶后Graph命中率.
Prefix cache 命中率会改变结论。
长上下文服务中, prefix cache命中可以跳过大段Prefill. 稀疏方法若主要加速Prefill, 高命中流量中的收益会低于无缓存基准. KV读取型稀疏仍可能改善Decode, 两者要按实际命中率加权:
还随复用前缀长度变化. 评测至少设置0%、目标线上比例和高命中三档, 同时确认prefix cache是否包含selector摘要、跨层indices等派生状态. 若命中后仍需扫描前缀重建索引, 这部分应计入 . Cache命中也影响显存容量. 多请求共享物理KV页时, resident bytes不能简单按请求相加; selector的query相关候选则通常不共享. 报告逻辑KV、唯一物理页、索引状态分别占多少, 才能比较 dense与sparse在真实共享负载下的并发上限.
多个预算点会带来选择偏差。
研究者常扫描许多 、block size、层表与量化组合, 然后只报告最优点. 如果同一小验证集既选配置又给最终质量, 偶然噪声会被当成收益. 应把数据分成配置选择集和锁定后的报告集, 或使用嵌套重采样. 最终报告保留完整Pareto曲线, 不只保留获胜配置.
任务很多时也会出现多重比较. 某方法在20个子任务中偶然赢两项并不罕见. 与其只标单项显著性, 更适合报告宏平均配对区间、各类别方向一致性和预先定义的关键任务门槛. 若需要对多项假设作结论, 使用Holm等校正并注明检验族. 配置一旦锁定, 所有系统基准使用同一候选预算与回退规则. 不能在质量表选大 , 性能表换小 ; 若展示两种配置, 明确标成不同工作点. 质量—速度Pareto前沿要求每个点都同时完成两侧测量.
配对差额要保留失败方向。
对每个样本记录 . 均值接近零可能由一半变好、一半变差抵消. 同时报告胜、平、负比例, 以及负例的任务类型、长度和证据结构. 对exact match, McNemar四格表能直接显示 dense对/sparse错与dense错/sparse对各有多少.
生成式评分还要固定解码. Greedy最适合隔离logit变化; sampling实验固定随机种子仍可能因候选集合变化导致随机消费路径分叉. 如果业务使用采样, 在确定性回归之外再运行多seed分布, 不用单次随机生成判断质量. 长任务失败往往相关, 例如同一文档拆出的多个问题同时受一个漏页影响. Bootstrap若把问题行当独立样本, 区间会过窄. 更稳妥的做法以文档或会话为cluster重采样, cluster内问题一起抽取. 服务trace也按请求或会话重采样, 不把同一请求的每个token当作独立延迟样本.
版本回归按变化来源切片。
一次发布可能同时更换模型权重、selector、kernel和驱动. 总结果变好无法说明每项都正确. 回归矩阵至少包含旧模型+旧kernel、旧模型+新kernel、新模型+参考kernel、新模型+新kernel. 参考kernel固定候选, 用来隔离实现; 稠密模型对照用来隔离稀疏算法. Kernel更新先跑固定indices数值与性能, selector更新再跑候选重合与任务, 模型更新重建稠密基线. 驱动或编译器更新需要重跑autotune和交叉点, 但不应改变固定候选数学输出超出容差. 按变化来源拆开, 线上回归才有明确回退对象.
6.4. 多轴统计与发布回归
三层对照把选择误差与执行误差拆开。
Dense层给模型能力与数值基准。
第一层运行相同模型权重、相同K/V精度、相同生成参数的dense attention。它回答两个问题:模型在完整上下文上能否完成任务,以及稀疏结果应该逼近哪个函数。若dense本身失败,该样本不能证明selector漏选;它仍可用于系统性能或分析模型能力上限。 Dense reference要与稀疏路径共享输入预处理、tokenizer、RoPE配置、停止条件和采样随机数。只替换attention邻接图。若dense使用BF16 KV、稀疏使用INT8 KV,质量差异同时含量化;若生成温度不同,闭环分叉也失去归因。 每条样本保存dense答案、任务分数、逐步logit摘要、选定层的attention概率或输出,以及完整运行成本。保存全部注意力矩阵通常不可行,可流式聚合块质量、证据质量和top-m位置。评测协议应说明dense侧保留了哪些oracle信息。
同预算oracle比较候选规则。
第二层使用与部署相同的块粒度、局部窗口、GQA共享规则和物理预算B,但候选由dense教师分数或已知证据产生。它检验这些候选规则在当前约束下的表现,不能保证已经找到任务最优集合。按teacher attention质量选块,逼近注意力分布;按删除块后的输出变化选块,更接近单层表示;按任务损失搜索候选,更贴近最终答案但成本最高,也可能只找到局部较优集合。至少报告attention oracle,关键实验再加入输出感知oracle。不同oracle差距本身就是目标错配线索。
同预算必须按真实成本定义。selector选128个token,kernel扩张到80个页,oracle若只选128个token却不扩页,二者并不公平。应把预算写成触及页数、读取K/V字节或目标kernel档位,并让oracle遵守同一因果与尾块语义。
Dense成功、oracle成功,说明存在满足当前约束且能完成该样本的候选;dense成功、oracle失败,只说明这项oracle规则没有完成任务,需继续比较候选规则、预算与粒度;dense失败,则保留为该模型配置的失败样本,稀疏路径仍可能通过减少干扰而成功。以上结果都按样本记录,不由一次失败推出模型或结构的绝对能力上限。
固定候选reference隔离kernel执行误差。
第三层把真实selector候选冻结,用朴素gather加高精度attention计算输出,再与真实kernel比较。两条路径拥有完全相同的逻辑集合,差异只来自索引映射、mask、量化重构、online softmax、split归并或浮点顺序。记dense输出为,同候选reference为,kernel输出为。选择误差与执行误差可分别度量
总差 通常不等于二者简单相加,但三点对照能判断主要来源。大、小应查候选;小、大应查kernel。 固定候选reference需要覆盖页扩张后的真实集合。若kernel按整页读取,reference也应读整页并应用相同mask;若reference仍按selector原始token集合计算,会把粒度差异误判成执行错误。
四种结果组合对应不同结论。
对每条样本记录dense、oracle、selector-reference和真实kernel四个结果。Dense与oracle都成功、selector失败,属于路由能力不足;selector-reference成功、kernel失败,属于执行错误;oracle失败且dense成功,需要继续检查候选规则、预算与粒度;四者都成功则进入性能对照。 还会出现selector成功、dense失败。可能是稀疏化偶然去掉干扰,也可能是采样随机性。不能把它简单计为“稀疏更强”。应固定解码或比较正确答案概率,并检查多个随机种子。若稀疏路径稳定改善,说明dense注意力含有有害上下文,值得作为独立现象研究。
汇总表应保留方向计数,而不只给平均差。记dense正确selector错误为 ,dense错误selector正确为 。两者相抵后净准确率变化可能很小,但暴露的回归仍然很多。发布门槛可以同时限制净变化与单向回归率。
归因需要逐层干预而非相关性。
候选质量低与最终失败相关,并不能证明某一层导致失败。可只在一个层组使用oracle候选,其余层保持真实selector,观察答案或logit是否恢复。逐层组扫描形成敏感度曲线,定位真正瓶颈。 反向干预也有价值:所有层使用oracle,只把某层换回selector。若质量立即下降,该层候选关键;若无变化,低recall可能被残差或其他层补偿。两种干预结合,可避免只看attention mass做过度解释。
Kernel归因同理。固定所有层候选,只替换一个层组的真实kernel为reference实现。执行误差在哪一层出现、是否被后续放大,可以由隐藏状态差和最终logit差同时观察。干预代价高,可在失败样本子集运行。
多轴网格与统计推断。
长度与证据距离要分开控制。
上下文长度L增加时,证据距离d、干扰块数N和位置编码外推往往同时变化。评测网格应固定其中两项扫描第三项。例如固定L,把证据放在10%、50%、90%深度;固定绝对距离,增加证据之后的无关尾部;固定深度比例,扩大总长度。 若只比较8K近证据与128K远证据,下降原因无法归属。可将任务结果写成 ,至少采样若干正交组合,再用分层模型或切片曲线观察主效应与交互。长度外推常与干扰数量交互,单变量曲线不够。 真实任务无法完全控制距离,可按标注证据的最远位置、跨度和相对深度分桶。没有证据标注的样本不能进入证据距离结论,可保留在总体任务质量中。
干扰难度比无关填充更重要。
重复随机文本只增加长度,selector很容易排除。困难干扰应与证据共享实体、主题、格式或关系,同时给出错误属性。可分为词汇相似、实体冲突、时间版本、结构重复和推理角色相似五类。 对每类干扰分别增加数量,观察候选margin、证据召回与任务成功。若长度增长只有同主题干扰才导致退化,问题来自排序竞争;若任何填充都退化,可能是位置外推或索引扫描数值分布变化。 反事实干扰可检验模型是否读了正确证据。把错误块的值替换为另一答案,selector若持续选择它,输出应随之改变;若候选变化但输出不变,主干可能忽略该块。候选与任务之间的因果链由此更清楚。
预算与块粒度形成二维曲面。
固定候选块数K时,块长B增大会增加读取token;固定读取token时,B增大会减少可选择块数。只扫K会把两种效应混在一起。应在多个 组合上报告质量与真实字节。 定义逻辑预算 ,真实流量由事务与元数据修正。相同 下,小B提供更精细选择但索引多,大B带入更多无关token但kernel规则。质量—时间曲面能找到每种长度上的合适粒度。 预算网格还应包含局部窗口与动态预算的分配。总页数固定时,扫描 ;多证据远程任务可能偏向global,语言建模和代码局部补全偏向local。单一分配无法代表全部任务。
质量指标要连接概率覆盖与任务成功。
候选覆盖teacher概率质量C、证据联合召回R、层输出误差E和任务成功Y构成一条指标链。先画 对C、R、E的条件曲线,再观察是否存在明显阈值。平均C很高但Y仍差,可能因为少数关键query低覆盖或teacher注意力并非充分解释。 对多证据样本,any-recall与all-recall同时报告。若m段证据分别以概率 命中,独立近似下联合命中为 ,证据数增加会迅速放大单段漏检。真实命中并不独立,所以最终使用直接统计的all-recall。 任务指标应保留原始定义,例如exact match、pass@1、执行成功或轨迹完成。用模型裁判时固定裁判版本、提示与随机性,并抽样人工核对。路由指标不能替代任务指标,任务指标也无法单独定位路由问题。
配对统计与区间比单点均值可靠。
同一批样本运行dense与sparse,分析配对差 。均值区间可用配对bootstrap:按样本重采样,始终成对保留两个系统结果。若任务包含同一文档的多个问题,应按文档簇重采样,避免把相关样本当独立观测。 准确率差可报告McNemar方向计数与置信区间。性能分位数使用请求级bootstrap,并保留时间顺序做block bootstrap以应对负载相关。只给P99点估计,在尾部样本很少时波动会很大。 多预算、多长度同时比较会产生选择偏差。若从几十个点挑最漂亮一个,需要独立验证集确认,或报告完整曲线与同时置信带。调参集与最终测试集分开,避免在测试任务上选择K。