材料是 DeepSeek-AI 2024 年 1 月 11 日挂出的论文 DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models (arXiv 2401.06066, 33 页), 一作戴达迈 (北京大学), 作者里另有清华和南京大学的实习生. 官方仓库 deepseek-ai/DeepSeek-MoE 放了 16B 的 Base 与 Chat 权重和微调脚本, 模型实现在 Hugging Face 的 deepseek-moe-16b-base 里 (modeling_deepseek.py, config.json). 逐段译文见 对照译稿.
论文要解决的成本很具体: MoE 用稀疏激活换参数规模, 但 GShard 那种「16 个大专家里选 2 个」的结构, 参数利用率不高, 同样的专家参数和 FLOPs 下还有效果可挖. 作者给的两条改动都不增加参数和计算, 只改专家的粒度和分工: 把专家切细, 把通用部分单独拿出来常开. 后面的 V2, V3, V4 都沿用了这套结构, 只在路由打分和负载均衡上继续改. DeepSeekMoE 在 llm-guide 里有一篇机制文章 DeepSeek MoE: 共享专家与细粒度路由, 下文侧重论文本身的设定, 实验口径, 参数核算和前后版本的差别.
1. 两条结构改动
1.1. 起点: GShard 式 MoE 的门控
一层标准 MoE 把 FFN 换成 个结构相同的专家. 第 个 token 在第 层的注意力输出记为 (维度 ), 每个专家 有一个可学习的中心向量 . 路由器算内积再做 Softmax 得到亲和度, 取最高的 个, 输出是这 个专家按亲和度加权求和再加残差:
这是论文式 (3)–(5). 有一个细节后面会反复用到: Softmax 在全部 个专家上做, 取 Top- 之后不再归一化, 所以 个门控值之和小于 1, 而且随 token 浮动. 官方 16B 实现也是这样, config.json 里 norm_topk_prob 为假, MoEGate 取完 topk 不再除以和. 路由越分散, 路由专家这一路的输出幅度越小.
作者把 top-1/top-2 MoE 的问题归成两条. 一是知识混杂: 专家只有 8 或 16 个, 分到一个专家的 token 覆盖的知识类型多, 这个专家的参数要同时装下彼此不相干的东西. 二是知识冗余: 不同专家的 token 都需要某些通用知识 (语法, 高频搭配), 每个专家都各学一份. 两条都是假说, 论文没有直接测「一个专家装了几类知识」, 证据是间接的: 第 3.3 节的消融和第 4 节的屏蔽实验. 这两条假说各对应一个改动, 下面分开讲.
1.2. 细粒度切分: 参数和 FLOPs 怎么保持不变
细粒度切分把每个专家 FFN 的中间维度缩到 , 一个专家变成 个小专家, 专家总数从 变成 ; 同时激活数从 提到 . 输出形式不变, 只是求和上限和 Top-K 的 换了 (式 6–8):
参数和计算不变可以直接数出来. 设标准 FFN 的中间维度为 , SwiGLU 专家有三个矩阵, 参数 . 切细后一个小专家 , 共 个, 总量仍是 ; 每 token 过 个, 激活量仍是 . 变的是组合数. 论文的例子是 : top-2 有 种选法, 切成 4 份后 top-8 有 种. 组合数只计「选了哪几个」, 门控值本身是连续的; 它能说明的是, 时一个原专家的 4 块可以只用其中一两块, 相当于在原 FFN 的中间维度上按块做 token 相关的稀疏选择, 这在 时做不到.
细粒度不是越细越好. 小专家意味着更多更小的矩阵乘, GPU 上单个专家的 GEMM 变瘦, 访存和调度开销占比上升; 路由器的输出维度也从 变成 . 16B 档停在每专家 0.25 倍标准 FFN, 论文给的理由正是「专家过小可能降低计算效率」, 并说更大规模可以更细. 145B 档就用了 0.125 倍. 后来 V2 的路由专家中间宽 1536, V3 是 2048, 隐藏维度分别是 5120 和 7168, 相对标准 FFN 的比例都在 0.1 上下. 细粒度带来的另一个成本在专家并行: 激活专家多了, 一个 token 的专家可能散在更多卡上, all-to-all 的目标数变多. 这个问题在 DeepSeekMoE 里还没出现 (16B 每层专家全放一张卡), V2 才用设备受限路由处理.
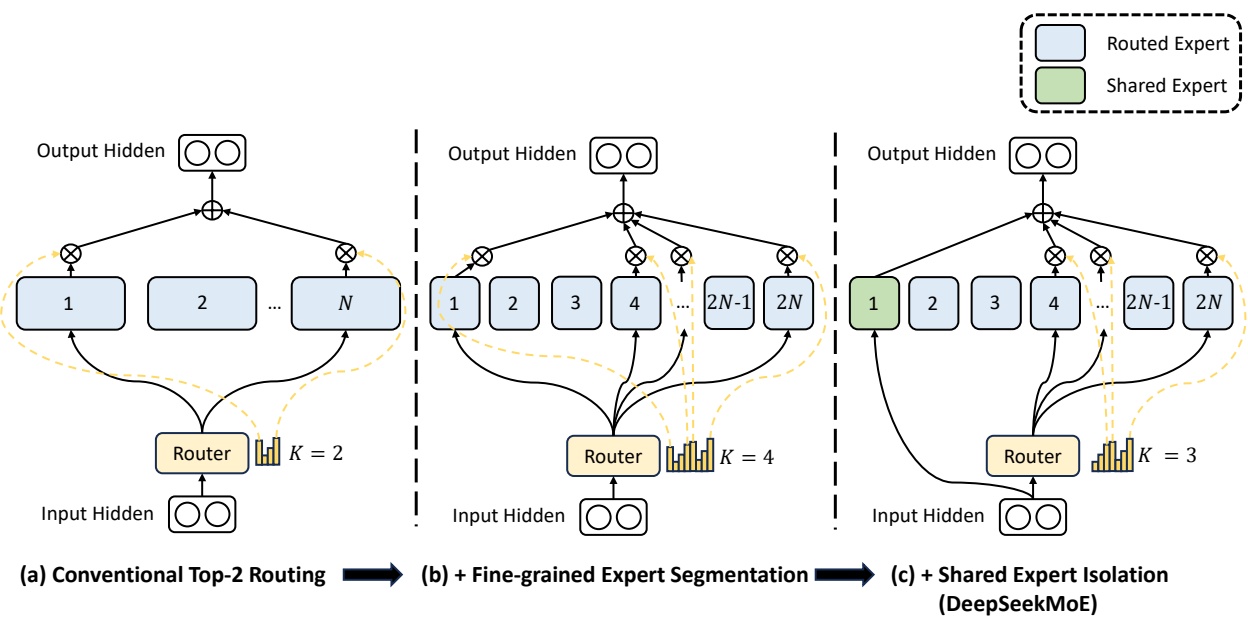
图 1: 三种 MoE 层的结构对照, (a) 传统 top-2 路由, (b) 加细粒度切分后 个小专家选 4 个, (c) 再隔离 1 个共享专家后路由部分选 3 个, 即完整的 DeepSeekMoE, 原文 Figure 2.
图 1 解析: 蓝色块是路由专家, 绿色块是共享专家, 黄色虚线表示路由器给出的门控权重, 只连到被选中的专家; (c) 中共享专家 1 直接接输入, 没有经过路由器, 输出也不乘门控. 图里专家块的宽度随切分变窄, 表示中间维度缩小, 三个子图的专家参数总量和激活量相同. 图中 (b) 是 , 论文实验用的是 ; 图也没有画出共享专家占用的是原来 个名额中的一个, 这一点在式 (9)–(10) 里才写明.
1.3. 共享专家隔离: 常开的那一路
在细粒度切分之上, 从 个专家里拿出 个作为共享专家, 每个 token 都过, 不经路由; 为保持计算不变, 路由部分的激活数降到 (式 9–10):
第一项的系数恒为 1, 与第二项的门控不在一个量级: 第二项的 个门控值是全体 Softmax 的分量, 和小于 1. 共享专家这一路的相对权重因此始终偏大, 而且路由越不确定 (Softmax 越平), 共享专家占比越高. 实现上, 个共享专家既然对所有 token 都算, 就可以合并成一个中间宽度为 倍的 MLP: 16B 的 DeepseekMoE 里 shared_experts 就是一个中间宽 的 DeepseekMLP, 与逐个算两个专家再相加在数学上等价, 但少一次 kernel 调用.
论文承认共享专家的原型来自 DeepSpeed-MoE (Rajbhandari et al., 2022) 的 Residual-MoE, 区别是对方从工程出发 (固定一个稠密 MLP, 再加一个 top-1 专家做修正), DeepSeekMoE 从「减少路由专家间冗余」的算法目的出发. 两者在结构上的差别是共享部分的大小: DeepSeekMoE 的共享专家与路由专家同尺寸, 数量由消融定 (第 3.3 节的 1:3).
式 (9) 规定共享专家从 个名额中划出, 2B 档守住了这一点: 1 个共享加 63 个路由, 合计 个标准 FFN. 16B 和 145B 档没有守住: 16B 是 2 个共享加 64 个路由, 145B 是 4 个共享加 128 个路由, 专家总量都是 16.5 个标准 FFN, 共享专家是加在 64 或 128 个路由专家之外的. 这会影响第 5.2 节「145B 比 GShard 137B 大 6%」的归因.
2. 负载均衡: 专家级与设备级两项损失
2.1. 专家级损失: 归一化与梯度走向
负载不均有两个后果: 路由塌缩, 少数专家总被选中, 其余训不到; 专家分在多张卡上时, 忙卡拖慢整层. 专家级损失针对前者 (式 12–14). 记路由专家数 , 每 token 激活的路由专家数 :
是专家 的实际负载. 个 token 各选 个, 共 次选择, 均匀时每个专家 次, 系数 把它归一到 . 是专家 的平均亲和度, 由于 Softmax, . 均匀路由时 , 损失等于 . 指示函数不可导, 梯度只经 回到 Softmax 和 , 而 的权重正是 : 被选得多的专家, 它在所有 token 上的亲和度都被往下压, 压的力度正比于它超载的程度. 这一形式来自 Switch Transformer, 推导见 MoE 负载均衡与容量.
式 (13) 没有写 的统计范围. 官方 16B 的 MoEGate 有两条分支, 发布的配置走 seq_aux=True: 用 scatter_add_ 按每条序列统计各专家被选中的次数, 除以 seq_len * top_k / n_routed_experts, 与这条序列的平均亲和度相乘求和, 再在 batch 上取平均. 所以 16B 的专家级损失是序列级的, 要求每条 4K 长的序列内部也大致均衡. 这一点后来变得重要: Loss-Free Balancing 和 V3 的消融把「均衡在序列内还是在 batch 上统计」当成影响专家特化的主要因素, 见 Loss-Free Balancing 解析. 另一个实现细节是 AddAuxiliaryLoss: 它在前向时原样返回专家输出, 反向时给辅助损失一个值为 1 的梯度, 这样每层的辅助损失不必一路传到外面去求和, 直接挂在该层的计算图上.
2.2. 设备级损失与三档系数
设备级损失针对计算瓶颈. 把路由专家分成 组 , 每组放一个设备 (式 15–17):
取组内平均, 均匀时仍是 1; 取组内求和, 是设备 上全部专家的亲和度总和, 均匀时为 . 损失在均匀时等于 , 与专家级同尺度. 它只要求每张卡的总负载均衡, 卡内哪个专家多拿, 哪个少拿不管. 作者的出发点写在论文第 3.3 节: 专家级约束过强会损害性能, 而系统只关心卡间均衡, 所以专家级系数取小, 只防塌缩, 设备级系数取大.
三档模型的系数和并行方式如下表. 三档都不丢 token, 这与同期 GShard, Switch 普遍用容量因子丢 token 不同; 能不丢的前提是 2B 和 16B 每层专家都在一张卡上, 145B 也只把路由专家铺到 4 张卡.
| 规模 | 专家部署 | (专家级) | (设备级) | 丢 token |
|---|---|---|---|---|
| 2B | 全部参数单卡 | 0.01 | 不用 | 否 |
| 16B | 流水线并行, 每层专家同卡 | 0.001 | 不用 | 否 |
| 145B | 每层路由专家均匀铺 4 卡 (专家并行加数据并行) | 0.003 | 0.05 | 否 |
16B 的 取 0.001, 比 2B 的 0.01 小一个数量级, 论文的理由是: 每层专家都在一张卡上, 专家间均不均衡不影响吞吐, 更大的系数只会伤性能. 这说明作者已经把辅助损失当成必须压低的干扰项, 后来 V3 把专家级损失整个换成不进梯度的偏置, 方向是一致的. 16B 和 145B 的第 1 层保留稠密 FFN, 理由是第 1 层的负载均衡「收敛得特别慢」; 论文没有给第 1 层的负载曲线. V3 把前 3 层都留成稠密, V4 前几层改用 Hash 路由, 都是在处理浅层路由不稳定这件事, 但各自都没有公布浅层负载数据.
设备级损失在论文里只有 145B 用过, 而且 145B 只训了 245B token, 没有关于它的消融. 它的完整作用要到 V2 才看得到: V2 把专家铺到 8 卡, 在设备级之外又加了通信级损失和设备级 token 丢弃.
3. 2B 验证实验: 与 GShard 对比的口径
3.1. Table 1 的对齐方式
验证实验的模型很小: 9 层, 隐藏维度 1280, 10 个注意力头, 词表 8K, 所有 FFN 都换成 MoE, 训练 100B token. 「标准 FFN」的大小文中没有直接给出, 可以从 Table 2 反推: Dense×16 的专家参数是 1.89B, 除以 9 层和 16 个 FFN 得每个 FFN 约 13.1M, 即 中 , 也就是 . 所有 MoE 基线的专家总量都是 16 个标准 FFN, 激活量按路由方式分两类: Hash Layer 和 Switch 是 top-1, 激活 1 个标准 FFN; GShard 是 top-2, DeepSeekMoE 是 1 共享加 7 路由, 每个 0.25 倍, 激活量都是 2 个标准 FFN. 所以 Table 1 里真正同参数, 同计算的对照只有 GShard 与 DeepSeekMoE 这一对, 两者都是总参 2.0B, 激活 0.3B, 每 2K token 4.3T FLOPs.
这组 FLOPs 可以复算. 按 DeepSeek LLM 的口径, 每 token 训练 FLOPs 是 6 倍的非嵌入激活参数 (含输出头), 加注意力分数项 . 2B 档激活专家参数 0.24B, 注意力 M, 输出头 M, 合计约 0.31B, 乘 6 再加 G, 每 token 约 2.14G, 乘 2048 得 4.38T, 与表中 4.3T 一致; Dense 基线同法得 2.88T, 表中 2.9T. 数字能对上, 说明 Table 1 的「激活参数相同」是按专家参数严格对齐的.
Table 1 的结果: GShard 的 Pile loss 1.867, DeepSeekMoE 1.808; 下游任务 DeepSeekMoE 全部领先, 差距最大的是知识类, TriviaQA 从 10.2 到 16.6, NaturalQuestions 从 3.2 到 5.7. 这个规模下代码任务的数字几乎是噪声: MBPP 五个模型在 0.2 到 2.2 之间, HumanEval 在 0 到 4.9 之间. 论文用「压倒性优势」概括, 落到数字上, 可靠的部分是 Pile loss 和 HellaSwag (50.5 到 54.8), TriviaQA 这几项.
3.2. 往上比: GShard×1.5, Dense×16 和 13B 档
为了估计 DeepSeekMoE 相当于多大的 GShard, 作者把 GShard 的专家放大 1.2 倍和 1.5 倍. GShard×1.5 的专家参数 2.83B, 激活 0.35B, 每 2K token 5.8T FLOPs, Pile loss 1.808, 与 DeepSeekMoE 相同; GShard×1.2 是 1.824. 也就是说, 在这个规模上, 两条结构改动带来的收益约等于把专家参数和专家计算都放大 1.5 倍. 下游任务互有胜负: RACE-middle 46.4 对 44.0, MBPP 2.6 对 2.2 是 GShard×1.5 高, ARC-easy 47.3 对 49.4, TriviaQA 15.7 对 16.6 是 DeepSeekMoE 高.
Dense×16 是作者设的上限: 16 个与标准 FFN 等大的共享专家, 每个 token 全过, 等于 FFN 放大 16 倍的稠密模型, 每 2K token 24.6T FLOPs, 约为 DeepSeekMoE 的 5.7 倍. 它是「同样的专家参数全都算」, 任何路由方式在同一份参数上都不会比它更有容量. DeepSeekMoE 与它的 Pile loss 是 1.808 对 1.806. 作者据此说 DeepSeekMoE「贴近 MoE 的理论上限」, 这个结论有两个前提: 一是只在 100B token 下成立, 训练更久时稠密上限与 MoE 的差距会不会拉开, 文中没有数据; 二是 Dense×16 的注意力与 FFN 比例刻意偏离了常规的 1:2, 它是一个专门搭的参照.
附录的 Table 10 把专家参数放到 13.3B, 与 15.9B 的 GShard×1.2 和 19.8B 的 GShard×1.5 比, 训练 token 仍是 100B. 这一档的层数和隐藏维度文中没有给出, 激活专家参数与总专家参数之比是 , 不是 2B 档的 , 所以它与 2B 档的结构比例不同. 表里没有 Pile loss, 10 个下游任务中 DeepSeekMoE 7 项最高, PIQA, ARC-challenge, MBPP 三项落后. 「在更大规模上明显超过 GShard×1.5」是对这 7 项的概括.
3.3. 消融: 两条改动各自贡献多少
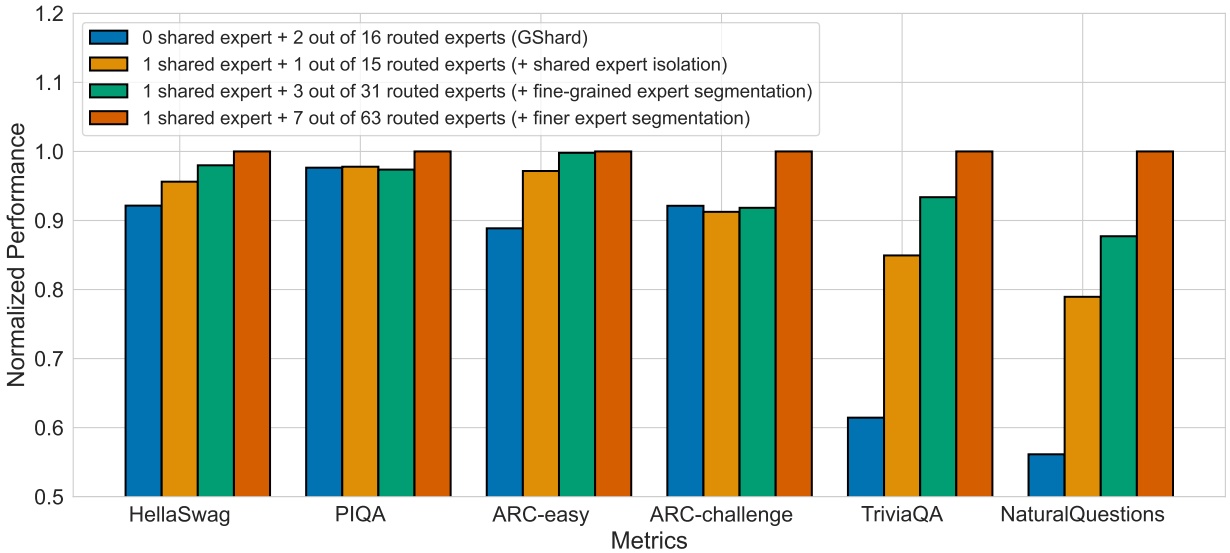
图 2: 2B 档的消融, 四组配置在六个基准上的归一化表现, 从 GShard (0 共享加 16 选 2) 依次加共享专家 (1 共享加 15 选 1), 切成 2 份 (1 共享加 31 选 3), 切成 4 份 (1 共享加 63 选 7), 原文 Figure 3.
图 2 解析: 纵轴是各基准分数除以四组中的最好值, 所以只能比相对高低, 不能读绝对分数; 末尾一组恒为 1.0. 从 GShard 到加共享专家, 提升主要在 TriviaQA (约 0.61 到 0.85) 和 NaturalQuestions (约 0.56 到 0.79), PIQA 和 ARC-challenge 基本不动, ARC-challenge 还略降. 再切成 2 份时 PIQA 和 ARC-challenge 仍几乎不动, 切成 4 份后六项才一起到顶. 图里没有画「只切细, 不加共享专家」这一组, 两条改动的贡献因此是按固定顺序叠加测的, 没有交换顺序的对照.
加共享专家这一步, 16 个专家里拿 1 个做共享, 路由部分变成 15 选 1. 也就是说, 这一组同时做了两件事: 引入常开专家, 以及把路由从 top-2 变成 top-1. 共享专家的贡献和「路由从 2 个变 1 个」的影响混在一起, 论文没有拆开. 切细的两组则只改粒度, 共享专家数固定为 1, 这部分的结论更干净: 粒度从 1 到 2 再到 4, 六项里五项随之上升或持平, 只有 PIQA 在切 2 份时略降 (约 0.978 到 0.973). 2B 档没有试 , 16B 档停在 , 145B 档用了 但没有 的对照, 所以粒度的收益在哪里饱和, 文中没有数据; Krajewski 等人 2024 年 2 月的 Scaling Laws for Fine-Grained MoE 把粒度当成 Scaling Laws 里的一个变量单独拟合过.
共享与路由的比例也做了一组: 64 个专家, 激活 8 个不变, 共享专家取 1, 2, 4 个, 对应 1 加 7, 2 加 6, 4 加 4, Pile loss 分别是 1.808, 1.806, 1.811. 作者选了 2 加 6, 即共享与激活路由之比 1:3, 并在 16B (2 加 6) 和 145B (4 加 12) 沿用. 三个数最大差 0.005, 比 Table 1 中 Switch 与 GShard 之差 (0.014) 还小, 文中也没给多次运行的方差, 作者自己的措辞是「marginally better」. 到 V3 共享专家又改回了 1 个 (1 加 8), 这个比例后来并没有被当成固定规则.
4. 专家可替换性: 三组冗余度实验
4.1. 屏蔽头部路由专家
论文第 4.5 节用三组实验论证「DeepSeekMoE 的专家更专精」. 三组都在 2B 档上做, 都用 Pile loss 作指标, 对照都是 GShard 系列. 它们测的是同一件事的不同侧面: 拿掉一部分专家, 剩下的专家能补回多少.
第一组的做法是: 对每个 token, 把路由概率最高的一定比例的路由专家屏蔽掉, 再从剩下的专家里照常选 top-K, 计算…2756 tokens truncated….3\approx41.2%$, 结论不变.
第三处是第 1.3 节提到的「145B 比 GShard 137B 大 6%」. 论文第 7.2 节把它全归因于专家中间维度对齐, 用上表可以拆开: 专家总参数之比 , 其中 来自多出的半个标准 FFN 的共享专家, 来自对齐. 两个因素各占一半左右.
5.3. 16B 与 145B 的结果
16B 的主对照是同一份 2T 语料训练的 DeepSeek 7B (Table 3). 按论文 FLOPs, 16B 是 7B 的 40.5%. 优势集中在语言建模和知识类: Pile BPB 0.74 对 0.75, HellaSwag 77.1 对 75.4, TriviaQA 64.8 对 59.7, NaturalQuestions 25.5 对 22.2. 落后集中在选择题: MMLU 45.0 对 48.2, CMMLU 42.5 对 47.2, CEval 40.6 对 45.0. 作者把选择题的差距归到注意力参数: 16B 的注意力约 0.5B (上表复算 0.470B), DeepSeek 7B 约 2.5B (B, 加嵌入后接近 2.5B, 文中没有说明这 2.5B 怎么数). 这个解释的依据是作者此前在 DeepSeek 7B MQA 上的观察, 本文没有做控制注意力参数的对照.
与 LLaMA2 7B 的对照 (Table 4) 训练 token 相同, 但语料不同, 16B 的代码, 数学和中文优势主要来自语料: HumanEval 26.8 对 14.6, GSM8K 18.8 对 15.5, CMMLU 42.5 对 32.6. 英文选择题仍略低, MMLU 45.0 对 45.8. Open LLM Leaderboard 上的对照见下图.
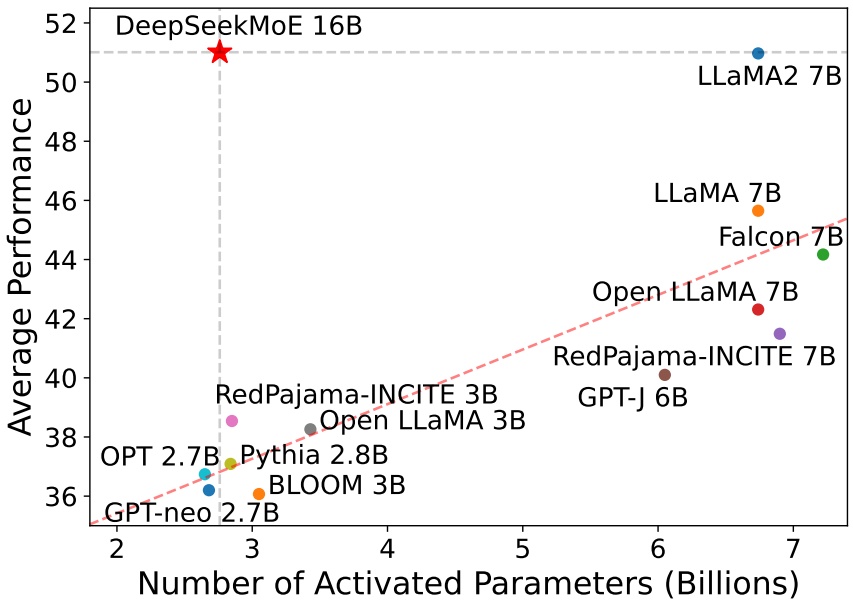
图 6: Open LLM Leaderboard 平均分与激活参数量, DeepSeekMoE 16B 与同期开源模型对比, 红色虚线为其他模型的线性拟合, 原文 Figure 1.
图 6 解析: 横轴是激活参数 (B), 纵轴是 Open LLM Leaderboard 的平均分. DeepSeekMoE 16B 在 2.8B 激活处约 51 分, 与 6.7B 的 LLaMA2 7B 相近, 明显高于拟合线. 这张图只说明「同激活参数下分数更高」, 横轴不反映总参数和显存占用: 16B 的全部权重仍要放进显存, 论文说的是能单卡放进 40GB 显存, 不量化. 推理速度「近 2.5 倍于 7B 稠密模型」需要「适当的算子优化」, 文中没有给出测试条件.
145B 是一次 245B token 的初步训练, 学习率预热后恒定, 没有衰减. Table 6 的四列都训练 245B token, MoE 三列从头训练, 超参数相同, 组间可比. DeepSeek 67B 那一列标的也是 245B token, 文中只说它与 MoE 模型用同一份语料, 训练细节指向 DeepSeek LLM 的报告, 没有说明它是正式训练过程中 245B token 处的检查点还是单独训练的版本. 结果上, DeepSeekMoE 145B 的 Pile loss 1.876 优于 GShard 137B 的 1.961 和 DeepSeek 67B (245B token) 的 1.905; MMLU 39.4 对 GShard 的 26.3 和 67B 的 45.1. GShard 137B 的 MMLU 26.3 和 CMMLU 25.4 接近四选一随机水平, 说明这一档 GShard 在 245B token 时选择题能力还没有出现, 两者在 MMLU 上 13 分的差距放大了架构差异.
计算量比例方面, 145B 是 67B 的 , 142B 半激活是 18.2%. 论文据此说 145B「与 DeepSeek 67B 相当」, 落到数字上, 语言建模和知识类追平或超过, 选择题仍差 5 到 6 分, 与 16B 档的模式一致. 文中承诺的 145B 完整版没有发布, 后续发布的是 DeepSeek-V2.
6. 到 V2, V3 的演进
6.1. DeepSeek-V2: 结构不变, 均衡加到三层
DeepSeek-V2 (2024 年 5 月) 的 FFN 直接沿用 DeepSeekMoE 结构, 改的是规模和均衡. 每个 MoE 层 2 个共享专家加 160 个路由专家, 激活 6 个路由专家, 专家中间维度 1536, 隐藏维度 5120, 60 层, 总参数 236B, 激活 21B. 共享与激活路由之比仍是 1:3, 粒度比 DeepSeekMoE 16B 更细. 详见 DeepSeek-V2 解析.
均衡这一块, V2 在专家级 () 和设备级 () 之外加了通信均衡损失 (), 并引入设备受限路由: 每个 token 的路由专家最多分布在 台设备上, 专家分布在 台设备上. DeepSeekMoE 不丢 token, V2 改为训练时按设备做容量因子 1.0 的 token 丢弃, 并保证约 10% 的训练序列不被丢弃, 推理时不丢. 这些改动都指向同一个问题: 145B 档只给出了设备级损失, 没有处理跨设备通信量, 到 236B 时 all-to-all 通信成了主要开销. DeepSeek-MoE 仓库 issue #29 里有人问过 16B 是否丢 token, 开源实现里没有容量限制, 与论文一致.
V2-Lite 的配置是 27 层, 隐藏维度 2048, 2 共享加 64 路由, 激活 6 个, 专家中间维度 1408, 总参数 15.7B, 激活 2.4B. 它的 MoE 层形状与 DeepSeekMoE 16B 完全相同, 区别在注意力换成了 MLA. ESFT 用的基座就是 V2-Lite, 见第 6.2 节.
6.2. DeepSeek-V3: Sigmoid 门控与无辅助损失均衡
DeepSeek-V3 (2024 年 12 月) 每个 MoE 层 1 个共享专家加 256 个路由专家, 激活 8 个, 专家中间维度 2048, 隐藏维度 7168, 61 层且前 3 层稠密, 总参数 671B, 激活 37B. 与 DeepSeekMoE 相比有三处结构变化: 共享专家从 1:3 改回 1 个; 门控从 Softmax 改成 Sigmoid, 并对选中的 top-K 分量归一化, DeepSeekMoE 16B 的 norm_topk_prob=false 不再适用; 节点受限路由, 每个 token 最多发往 4 个节点. 详见 DeepSeek-V3 解析.
均衡方式变化最大. V3 主要靠 Auxiliary-Loss-Free Load Balancing (arXiv 2408.15664): 给每个专家一个只参与 top-K 选择, 不参与门控加权的偏置, 按专家负载每步调 . 专家级辅助损失只保留一个序列级版本, 系数降到 , 用来防止单条序列内的极端不均. DeepSeekMoE 16B 的 seq_aux=True 已经是序列级统计, V3 保留了这一点, 但把它从主要手段降成兜底. V3 也不丢 token.
专家专精这一假说的直接延续是 ESFT (Expert-Specialized Fine-Tuning). ESFT 在 V2-Lite 上统计各任务的专家激活, 只微调与任务相关的少数路由专家, 其余冻结. 这个做法成立的前提正是 DeepSeekMoE 想达成的「路由专家各管各的」: 如果专家之间大量重复, 任务相关的专家就不会集中在少数几个上. ESFT 的结果可以看作第 4 节冗余度实验在下游任务上的一次检验.
6.3. 保留与改掉的部分: 细粒度切分和共享专家隔离这两条, 从 16B 到 V2, V3, V4 一直保留, 粒度越来越细: 16B 每个专家是 1408 维对 2048 维隐藏, V3 是 2048 对 7168, 路由专家从 64 个到 256 个, 激活从 6 个到 8 个. 首层稠密的做法也保留下来, V3 扩到前 3 层; DeepSeek-V4 的前几层改用 Hash 路由. 论文给首层稠密的理由是「首层负载均衡收敛特别慢」, 但没有给数据, 后续版本的做法说明这个问题一直存在.
改掉的主要是三处. 一是共享专家比例, 1:3 只在 16B, 145B, V2 用过, V3 回到 1 个共享专家, 这与第 3.3 节看到的「三种比例差 0.005」一致, 比例本身影响很小. 二是门控, Softmax 不归一化改为 Sigmoid 加 top-K 归一化, 第 4.2 节讨论的「路由专家门控和远小于 1」随之消失. 三是均衡, 从多项辅助损失逐步换成偏置调节, 论文第 3.3 节担心的「专家级约束过强会损害性能」在 V3 里用不进梯度的方式解决了.
7. 与 GShard 和 Dense 的公平比较
三种对齐方式. 等总参数比较容量, 等active参数/FLOPs比较每token计算, 等墙钟比较系统效率. 三种问题结论可能不同. DeepSeekMoE 2B与GShard 2.9B的比较强调更少专家参数与计算达到相近性能; 与Dense×16比较接近总参数上限; 16B与Dense 7B比较强调约40%计算. Dense同总参数往往是MoE质量上限参照, 因为每token激活全部容量, 计算也更高. MoE接近它说明稀疏路由利用了较多总参数知识. 这不是理论上不可超过的严格上限, 数据、优化或正则不同仍可能改变结果; 论文将其作为经验上界. 手算等计算. 设Dense FFN宽度, MoE共享加路由激活总宽度. 忽略router和通信, 等FFN计算条件为
总MoE宽度为, 容量倍数
大而固定时, 总容量显著增加. 共享专家增多会降低, 同时可能减少重复. 设计需要同时权衡容量倍数、专门化、共享和系统效率. 整模型等计算还要加attention和embedding. 令每tokendense公共计算, FFN计算, MoE激活FFN, 则比例
即便很小, 给出下限. 论文报告40.5%、28.5%等整模型口径, 不能用专家激活比例直接复算. 参数效率与数据效率. MoE总参数大, 每个专家看到的token只是路由子集. 若总训练token不增加, 单专家有效数据少. 细粒度后专家更多、更小, 每个参数获得的更新频率可能下降. 共享专家每token更新, routed专家按更新. 专家见到的token期望为量级, 其中为总token, 为选择频率. 低频专家可能欠训练. 均衡loss提高覆盖, 也可能把不相关token分给它. 模型扩大时常需要更多数据, 不能只增加总参数. 墙钟反例. 若专家GEMM太小, GPU利用率低; all-to-all跨节点, 通信超过计算; capacity padding浪费, 理论FLOPs减少仍可能比Dense慢. 反过来, 大batch和高带宽网络能把专家矩阵聚合, MoE吞吐优势显现.
公平系统比较需相同硬件、batch、序列、精度与优化实现, 同时报tokens/s和模型loss. DeepSeekMoE论文主要建立架构与能力证据, 具体部署应实测.
7.1. 通信与专家并行
dispatch/combine 数据路径. 本地router为每个token产生目标. dispatch把隐藏向量、路由权重和token索引发到专家设备; grouped GEMM计算专家; combine按原序聚合. 通信字节粗略为
前面的2代表发送与返回, 是元素字节数, 未计元数据. 细粒度目标会增加消息数, 总向量传输若每个小专家都收完整也随激活数增加. 实现可在同设备合并或优化布局. 节点内与节点间. NVLink带宽和延迟优于跨节点RDMA. 专家放置应让常见路由尽量节点内, 同时保持设备均衡. token可能选择多个节点的专家, 需要多目的all-to-all. batch越小, 每目的消息越碎, 延迟占比越高. 论文中的设备级均衡约束负载, 不直接最小化跨节点流量. 后续V2/V3在专家并行、节点限制路由和通信库上继续演进. 初版DeepSeekMoE的贡献应停留在当时公开机制. 计算通信重叠. dispatch完成部分token后即可启动专家GEMM, combine也可分块返回. 理想情况下
实际依赖kernel、stream和网络进度. 细粒度专家提供更多调度块, 也增加启动开销. active FLOPs不包含无法隐藏的tail. 故障与确定性. 专家分片使单设备故障影响一部分参数, 训练仍需全局恢复. all-to-all顺序和浮点归约变化可能导致非bitwise结果. checkpoint要保存所有专家、router与optimizer状态, 总参数决定存储而非active参数.
B、16B、145B的尺度外推: 2B实验回答机制. 2B规模允许多组GShard、Dense、细粒度、共享专家消融. 相同数据与训练设置下比较, 可把收益更可信地归给结构. 它回答「机制是否有效」, 不自动保证百B尺度的最优超参. 论文观察两条改动分别贡献收益, 组合最好. 若只细分、无共享, 组合灵活但冗余仍在; 只共享、专家较粗, 公共知识隔离但组合空间有限. 这与设计动机一致. 16B回答实用规模. 16.4B总参数模型训练2T中英token, 官方仓库说明可在40GB GPU以bf16附近条件部署, 不量化. 它用约40%计算达到Dense 7B或LLaMA2 7B可比结果. 比较仍包含数据和评测协议, DeepSeek 7B同语料对照更有归因价值. 模型最大上下文4096, Chat使用同一微调设置对比Dense模型. 后续长上下文与MLA不属于初版. README的finetune脚本是使用示例, 不能反推原始预训练全部配置. 145B验证扩展方向.
145B实验表明相对GShard优势在更大规模仍存在, 并以28.5%乃至18.2%计算接近DeepSeek 67B. 「18.2%」对应减少激活专家后的实验性结果, 需要与标准配置分开. 少激活仍追平支持专家冗余降低, 也可能受benchmark和训练程度影响. 145B被论文称为preliminary, 开放程度与16B不同. 不能把它当后续V2的同一个模型. V2在此思路上重新配置总参数、共享/路由专家和均衡策略. 尺度变化的可证伪条件. 若细粒度收益只在2B出现、16B等计算消失, 机制无法外推; 若专家相似度随规模上升重新变高, 专门化解释受挑战; 若通信让大规模墙钟劣于Dense, 计算优势只在FLOPs口径成立. 论文的多尺度结果提供正证据, 完整系统曲线仍可扩展.
从初版到 V2、V3 与 Coder-V2: V2继承的骨架. DeepSeek-V2继续使用细粒度routed专家与共享专家隔离, 规模扩到236B total、21B active, 注意力改为MLA, 数据与长上下文也变化. MoE骨架有明确继承, V2成绩不能全归初版架构. V2均衡加入专家、设备、通信等层次, 并限制路由设备范围以控制通信. 这些是后续扩展, 初版论文只有当时的辅助损失设计. 时间顺序要保留. V3改掉的门控均衡. V3保留DeepSeekMoE专家组织, router亲和度改用sigmoid并引入无辅助损失的bias调节做负载均衡, 避免辅助loss直接干扰主任务. sequence-wise辅助项仍用于极端平衡. 因而「细粒度+共享」被保留, 「靠较强辅助loss均衡」被改写. 无辅助均衡按近期负载调整专家bias, bias参与选择而非最终门控权重. 热门专家bias降低, 冷门提高. 它是控制系统式反馈, 与初版可微辅助项的梯度路径不同. V3结果不能倒推初版已经采用.
Coder-V2的关系. Coder-V2从DeepSeek-V2中间checkpoint继续训练6T代码数学语言数据, 因此继承V2版MoE/MLA, 不是从DeepSeekMoE 16B或第一代Coder直接续权重. 初版MoE是结构祖先, V2是直接底座. Coder-V2 Lite和236B的total/active参数体现稀疏容量, 代码专门化来自continue pretraining和对齐. 不能把代码能力归给专家结构单一变量. 等数据Dense/MoE消融才回答该问题. V3之后的边界. V3加入FP8、MTP、DualPipe等训练系统, MoE路由也演进. 它证明初版专家组织可作为长期骨架, 不意味着初版具有后续系统能力. 阅读谱系应列继承项与新增项, 不用后代成果包装早期论文.
7.2. 可证伪消融矩阵
细粒度切分. 固定总/active参数、共享专家、数据和FLOPs, 扫描. 测validation loss、任务、专家相似度、GEMM利用率与通信. 若增大能力先升后降, 说明组合收益与系统/数据稀释存在最优点. 只测loss会漏运行代价. 反例是随机组合空间变大却专家输出仍高度相似. 此时细分收益可能来自正则或优化, 「专门化」证据不足. 屏蔽与互信息应同步变化. 共享专家数量. 固定每tokenactive宽度, 扫描, 相应减少或宽度. 按通用/领域任务测. 如果共享专家增加让所有领域改善、routed冗余下降, 隔离解释成立; 若routed能力下降且总分不变, 只是计算重新分配. 将共享专家改为同样数量、但经router选择的专家, 可区分「常开」与「多一个专家」. 把共享专家输出门控缩放, 能观察依赖程度. 均衡系数.
扫描, 画主loss对最大设备负载的Pareto曲线. 系数零可能坍缩, 太大可能损伤专门化. 选择点应结合硬件吞吐, 不只看模型loss. 不同batch和序列重做, 因为负载方差随token数下降. 小实验的系数不能直接用于大batch. 设备数与专家放置变化也要重新调. 专门化干预. 按领域统计路由, 做专家屏蔽、交换、强制路由和输出相似度. 四种证据一致时, 才能说某些专家形成独特技能. 单个热图或案例容易误判. 使用变量改名、翻译、格式变化构造语义保持反例. 路由若随表面形式剧烈变化, 专门化更接近token模式; 若保持稳定, 语义证据更强. 等墙钟比较. Dense与MoE在同硬件训练相同小时, 允许各自选择最佳batch/kernel, 比最终loss. 这回答实际预算效率. 再做等FLOPs和等total参数, 三组结果共同描述架构.
如果MoE等FLOPs胜、等墙钟输, 瓶颈在系统; 优化通信后可能兑现. 若两者都输, 结构主张受挑战. 若等墙钟胜而等FLOPs相近, 优势可能来自硬件利用或数据吞吐.
反例与适用边界: 细粒度专家在大batch训练中可聚合, 单token低延迟推理可能因多个小GEMM变慢. 总参数带来知识容量, 本地部署仍要存储全部权重. active参数降低计算, 不降低checkpoint和网络加载到同一比例. 共享专家减少routed冗余, 也形成每token固定成本. 数据域很单一时, common knowledge与specialized knowledge界线模糊, 共享隔离收益可能减小. 高度多域模型更可能受益. 负载均衡提高吞吐, 可能把token送给语义次优专家. 专家专门化越强, 强制均匀的机会成本越大. V3改用bias均衡正反映这项张力, 初版辅助loss仍在当时设置下有效. 专家屏蔽影响小可能代表冗余, 也可能因为残差、共享专家或benchmark不敏感. 屏蔽影响大可能代表专门化, 也可能只是该专家流量高. 控制实验决定解释.
MoE接近Dense同总参数是强结果, Dense是否充分训练、数据token是否足够仍影响「上限」. MoE每专家见数据少, 更长训练可能改变差距. 不能把单一训练预算变成理论定理. 2B消融精细, 145B验证初步. 超参随规模变化, 小模型最优未必能搬到大模型. 多尺度一致趋势增加可信度, 不消除重新调参需要.
参考文献
- Damai Dai 等. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. arXiv 2401.06066, 2024. 对照译稿: deepseek-moe-bi.md.
- DeepSeek-AI. DeepSeek-MoE 代码仓库 与 deepseek-moe-16b-base 模型卡及
config.json. - 后续工作: DeepSeek-V2 解析, DeepSeek-V3 解析, Auxiliary-Loss-Free Load Balancing 解析, ESFT 解析.
- Jakub Krajewski 等. Scaling Laws for Fine-Grained Mixture of Experts. arXiv 2402.07871, 2024.
- 社区资料: 知乎: DeepSeekMoE 实现细节; Yudong Lee: DeepSeekMoE Explained; Luning Wang: DeepSeekMoE 笔记; Chris Hayduk: Understanding DeepSeek Part I; GitHub issue #17: AddAuxiliaryLoss.