来源: DeepSeek-V3 Technical Report (arXiv: 2412.19437v2, 2025-02-18). 仓库: https://github.com/deepseek-ai/DeepSeek-V3
本文大量引用了技术报告的表格和图片(受限于篇幅无法写进来)以及公式, 建议阅读的时候对照原技术报告观看。配套对照译稿见同目录的 bi 稿。
DeepSeek-V3 是一个 671B 总参, 每 token 激活 37B 的 MoE 语言模型, 在 14.8T token 上预训练, 全部训练用了 2.788M H800 GPU 小时. 注意力和 FFN 的主体沿用 V2 的 MLA 与 DeepSeekMoE, 新增无辅助损失的负载均衡 (auxiliary-loss-free load balancing)和 MTP 训练目标; 工程侧采用 FP8 混合精度, DualPipe 流水并行和自写的跨节点 all-to-all 内核; 后训练把 DeepSeek-R1 的长 CoT 蒸馏进一个不输出长思考的普通对话模型. 这些改动互相牵连: 路由限制决定通信能否被计算覆盖, 通信开销降下来后才有条件取消张量并行, FP8 节省的显存和带宽又为大规模专家并行留出空间.
1. 模型结构
1.1. 从 V2 到 V3: 哪些没变, 哪些变了
从模型架构上看, V3 有 61 层, 隐藏层宽度 7168, MLA 用 128 个头, 每个头 128 维, KV 压缩维度 , query 压缩维度 1536, 解耦 RoPE 每个头有 64 维. 除前三层保留稠密 FFN, 其余 58 层都是 MoE: 1 个共享专家加 256 个路由专家, 每个专家中间维 2048, 每 token 激活 8 个路由专家, 且最多发往 4 个节点. MTP 深度 D = 1. V2 是 60 层, 隐宽 5120, 2 个共享加 160 个路由专家, 激活 6 个. 层数几乎不变, 宽度和专家数都放大, 激活参数从 21B 涨到 37B, 总参数从 236B 涨到 671B, 激活率从 8.9% 降到约 5.5%.
37B 可以按这些宽度自己加出来. 每个专家是 SwiGLU 结构, 三个矩阵共 3×7168×2048 ≈ 44.0M 参数, 每个 MoE 层激活 9 个专家约 396M, 58 层约 23.0B. MLA 每层的 query 下投影, query 上投影(含 RoPE 部分), KV 下投影, K 与 V 上投影, 输出投影加起来约 187M, 61 层约 11.4B. 词嵌入和输出头各约 0.93B. 前三层稠密 FFN 的中间维报告正文没写, 公开权重的 config.json 里是 18432, 三层共 3×3×7168×18432 ≈ 1.19B. 四项合计约 37.4B, 与报告的 37B 对上. 总参同样可以加出来: 256 个路由专家乘 58 层约 654B, 加上共享专家, 注意力, 嵌入和稠密层, 约 671B. 报告的 671B 不含 MTP 模块; Hugging Face 上的权重合计 685B, 其中主模型 671B, MTP 模块 14B. MTP 模块由一个与主干同构的 MoE Transformer 块和一个 7168×14336 的投影组成, MoE 块约 11.6B, 权重文件里它还另存了一份嵌入和输出头, 约 1.9B, 合起来约 13.5B, 与 14B 相符.
1.2. MLA: 推理时每 token 只缓存 576 个数
MLA 的式 (1)–(11) 与 V2 完全一样: 键和值先由 压成 512 维的潜向量 , 再分别上投影成 128 个头的 K 和 V; 另有一个 64 维的解耦键 单独加 RoPE, 所有头共享. 推理时只需缓存这两个向量, 每 token 每层 576 个元素. 61 层合计 35,136 个元素, BF16 下约 70KB; 同样配置的标准 MHA 每层要存 2×128×128 = 32,768 个元素, MLA 只有它的约 1.76%. 按此计算, 一条 128K 的序列 KV cache 约 9.2GB. 这是 V3 能把上下文开到 128K 并在 decode 阶段用大 batch 的前提, 矩阵吸收与缓存推导见 MLA 低秩潜变量与矩阵吸收.
query 侧的低秩压缩(式 6–9)不影响推理缓存, 报告的说法是为了降低训练时的激活显存. 注意力打分的分母是 , 因为每个头的 query 和 key 都由 128 维内容部分和 64 维位置部分拼成. 报告还写了两处 V2 就有的细节: 压缩潜向量后面各加一个 RMSNorm, 在宽度瓶颈处乘额外的比例因子. 这两处都是为了训练稳定, 很可能也与第 2.2 节的 FP8 有关: 低秩瓶颈的激活值范围如果不受控, 量化误差会被上投影放大. 报告没有对 MLA 做新的消融, 它在 V3 里被当作 V2 已经验证过的组件直接沿用.
1.3. DeepSeekMoE: sigmoid 门控和节点受限路由
MoE 层的输出是残差, 共享专家输出, 各路由专家输出按门控加权之和(式 12). V3 相对 V2 有一处小改动: 亲和度 用 sigmoid 而不是 softmax 计算(式 15), 选出 top-8 以后, 再在这 8 个分数之间归一化得到门控值(式 13). 写成一步:
V2 每层 160 个路由专家, 每个 token 选 6 个; V3 是 256 个选 8 个。门控值是路由器给选中的每个专家的权重, 决定该专家的输出按多大比例混进这一路的结果。
softmax 和 sigmoid 的区别在权重怎么定。V2 用 softmax: 全体 160 个专家抢一块和为 1 的蛋糕, 单个分数在 160 个里分, 选中的 6 个加起来仍小于 1, 剩下那份谁也没拿到——路由这一路的输出幅度随路由集中程度浮动。V3 用 sigmoid: 每个专家独立打分, 各自落在 0 到 1, 再只在选中的 8 个内部归一化, 8 个权重相加恒等于 1——这一路幅度固定, 跟共享专家那一路的相对比例不再随 token 变化。Table 5 的两个基线都已采用 sigmoid 门控和 top-K 归一化, 因而没有分离出这项改动的贡献。
从路由上看, 专家被限制在少数节点上. 训练时每层的 256 个路由专家均匀分布在 8 个节点的 64 张卡上, 每卡 4 个. 每个 token 先按「每个节点上最高的 个亲和度之和」给 8 个节点排序, 选出前 4 个节点, 再只在这 4 个节点的专家里选 top-8. 这一步的目的是限制跨节点流量: 节点内 NVLink 约 160 GB/s, 跨节点 IB 约 50 GB/s, 相差约 3.2 倍. 报告据此算出, 每个 token 平均在每个目标节点上可以选 3.2 个专家而不增加 NVLink 开销, 4 个节点最多 13 个专家, 通信成本和现在选 8 个一样. 也就是说, 激活专家数还有余量, 通信预算不是当前配置的瓶颈. V3 训练和推理都不丢 token, 这依赖下一节的负载均衡和第 5.1 节的冗余专家部署. DeepSeekMoE 细粒度专家与共享专家的来由见 DeepSeek-MoE.
1.4. 无辅助损失的负载均衡
常规 MoE 在训练损失里加一项辅助损失, 惩罚负载不均; 系数太小管不住, 太大又会干扰主任务的梯度. V3 采用 Wang 等人 2024 年提出的 Loss-Free Balancing(式 16): 给每个专家一个偏置 ——一个由训练循环维护的标量, 初值全 0, 与梯度无关: 每个训练步结束, 这一步里超载的专家 减 , 欠载的加 ; 推理时冻结——把上式的选择条件换成
选 top-K 时用 排序, 但乘到专家输出上的门控仍用原始的 . 每个训练步结束时统计整个 batch 上各专家的负载, 超载的专家偏置减 , 欠载的加 . 偏置不参与反向传播, 也就没有辅助损失那样的干扰梯度; 它只改变「谁被选中」, 不改变「选中后权重多大」. Loss-Free Balancing 原文特别指出, 偏置要用之前 batch 的负载来更新, 如果用当前序列的负载, 路由就会泄露未来 token 的信息. V3 在步末更新, 下一步才生效, 符合这个约束.
超参数在 §4.2: 前 14.3T token 的 , 末尾 500B token 设为 0, 即偏置冻结. 按符号更新时, 偏置每步最多变 0.001, 而 sigmoid 分数在 0 到 1 之间, 要把一个专家的选中率明显压下去大概需要上百步的累积. 末尾 500B 冻结偏置, 恰好与学习率的最终两段恒定期重合, 路由在收尾阶段不再变动. 另外保留了一个极小的序列级均衡损失(式 17–20), , 报告的说法是只为防止单条序列内极端不均. 这条损失里, 是专家 在这条序列上实际被选中的频率(乘 后以 1 为均值), 是它的平均门控权重, 两者乘积对所有专家求和再乘 ——又热门又权重大的专家把乘积顶上去, 损失负责把它压下去:
形式和 V2 的专家级损失相同, 是一条序列的 token 数, 所以约束的是序列内部. 两处和 V2 不同. 一是 里先把 256 个 sigmoid 分数除以它们的和: sigmoid 分数之和不是 1, 不归一的话 随路由器输出整体漂移, 损失的尺度就不固定. 二是 的指示函数按原始 的 Top-K 计数, 不含偏置 , 而实际路由用的是 ; 偏置一旦把某个专家挤出或挤进 Top-8, 这一项看到的负载和真实负载就不一致. 报告没讨论这点, 取得这么小, 影响大概有限. 这个系数比 V2 专家级均衡损失的 0.003 小 30 倍, 基本只在出现塌缩时起作用.
Table 5 在两个规模上比较纯辅助损失和无辅助损失. 小档 15.7B 总参, 2.4B 激活, 训 1.33T token; 大档 228.7B 总参, 20.9B 激活, 训 578B token. 大档的 HumanEval 从 40.2 升到 46.3, GSM8K 从 70.7 升到 74.5, MATH 从 37.2 升到 39.6, Pile-test BPB 从 0.656 降到 0.652. 但并非全部上升: 大档 MMLU 从 68.3 降到 67.2, 小档 MBPP 从 36.6 降到 35.8. 两个基线的辅助损失强度分别沿用 V2-Lite 和 V2 的设置, 没有针对新配置调参, 所以这组对比比较的是「V2 的做法」和「新做法」, 不是「最优辅助损失」和「新做法」.
§4.5.3 追问了优势从哪来. 无辅助损失和序列级辅助损失的根本区别在均衡的范围: 一个在整个 batch 上均衡, 一个要求每条序列内部均衡. batch 级约束更宽松, 允许一条代码序列集中用擅长代码的专家. Figure 9 和附录 C 在 Pile 的三个领域上画出 16B 模型的专家相对负载, 无辅助损失模型的专家特化更明显(读图). 他们又设计了一个 batch 级辅助损失作对照: 1B 模型上, 序列级辅助损失验证损失 2.258, 无辅助损失 2.253, batch 级辅助损失也是 2.253; 3B 模型上分别是 2.085, 2.080, 2.080. 结论是关键在均衡范围, 而不在是否用损失函数. batch 级均衡的代价是小 batch 或单条序列内可能严重不均, 以及推理时领域变化带来的不均; 前者靠大规模专家并行和数据并行保证每个 micro-batch 足够大, 后者靠部署时的冗余专家.
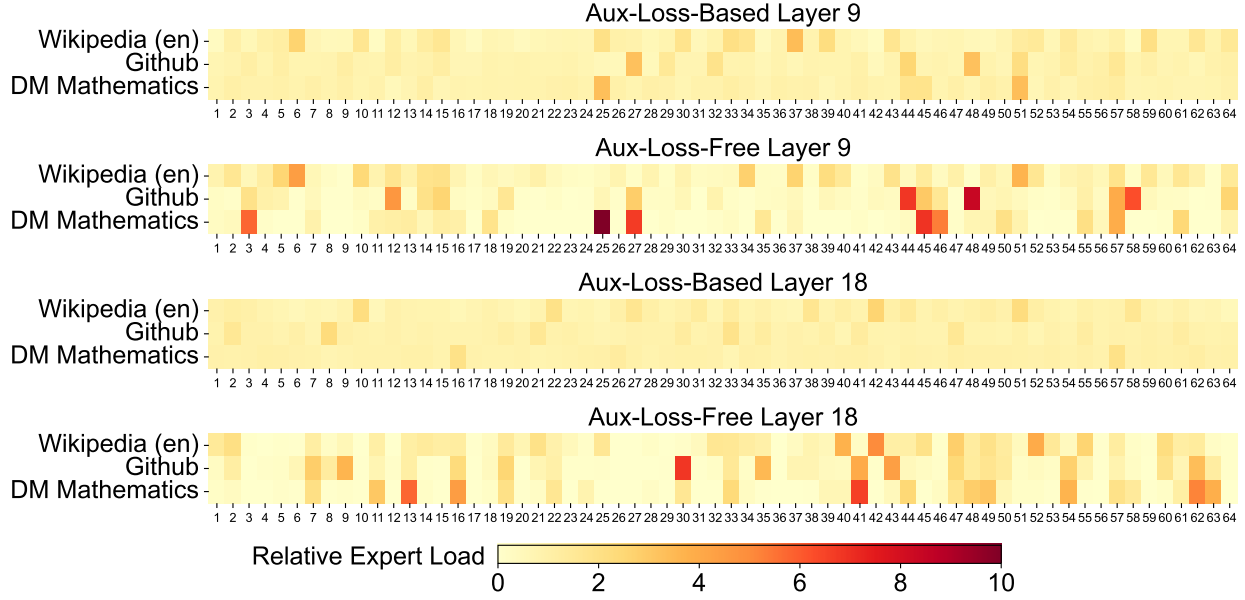
图注: 报告 Figure 9: Pile 三个领域上 16B 模型的专家相对负载, 无辅助损失模型的专家特化更明显。 报告 Figure 9: Pile 三个领域上 16B 模型的专家相对负载, 无辅助损失模型的专家特化更明显
1.5. MTP: 训练时多预测一个 token
MTP: 训练时让每个位置不只预测下一个 token, 再多预测一个。思路来自 Gloeckle 等人 2024 年的工作, 但实现不同: 他们用 D 个独立输出头并行预测后面 D 个; 而 V3 直接就是串行——D 个模块一层层往后推, 每层保留完整的因果链(Figure 3)。
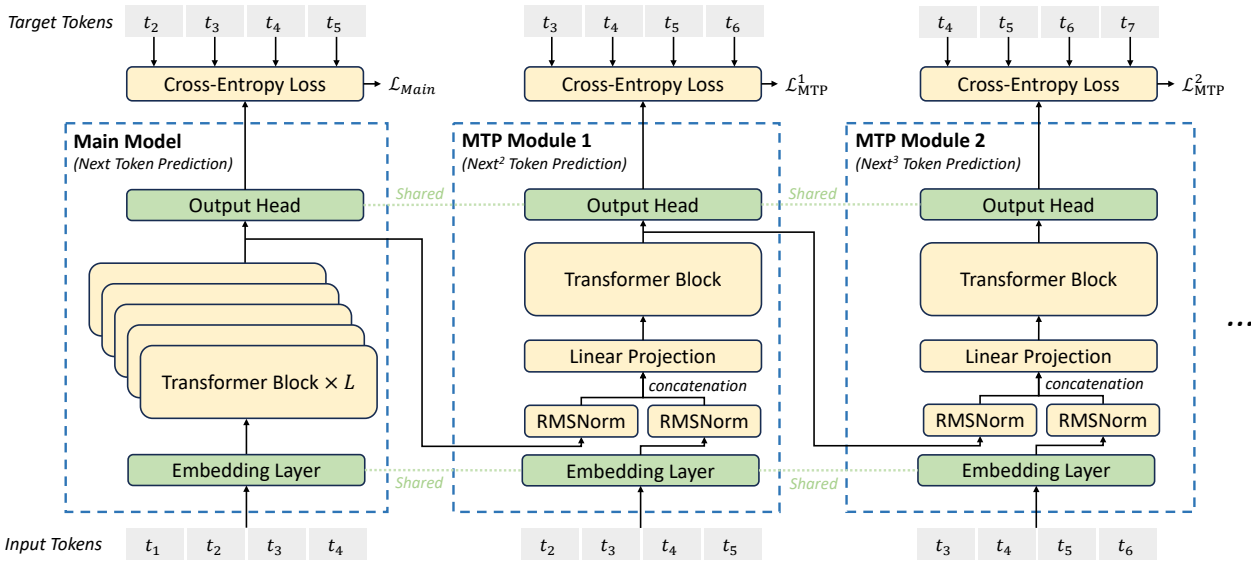
图注: 报告 Figure 3: MTP 模块结构——每深度一个模块, 串行往后推, 嵌入层与输出头与主模型共享。 报告 Figure 3: MTP 模块结构——每深度一个模块, 串行往后推, 嵌入层与输出头与主模型共享
拿 V3 实际用的 D = 1 走一遍. 主模型在「爱」这个位置算出一个 hidden state——由「我」「爱」两个 token 算出。MTP 模块收到两样输入: 这个 hidden state, 和「北」的嵌入——嵌入就是输入层那张查表矩阵, 把 token 查成向量, 宽度和 hidden state 一样是 7168:
全模型只有一个宽度 d, embedding、hidden state、注意力内部都共用。预测「京」既需要「我爱」的上下文, 也需要紧跟其前的「北」; 而「爱」的 hidden state 里还没有「北」, 所以「北」的嵌入要单独喂进来。两样各做 RMSNorm 统一尺度, 首尾拼接成一个 14336 维的长向量(式子里的 ), 乘投影矩阵 (7168×14336)压回 7168 维, 过一个小 Transformer 块, 最终用主模型共享的输出头预测「京」。嵌入层和输出头都与主模型共享, 模块自己要训的只有投影矩阵和那个小 Transformer 块。这是训练时的辅助任务, 推理时模块整个摘掉(也可以改作投机解码的草稿头, 见下文)。写成三步(式 21–23):
时 就是主模型末尾一层在位置 的表示. 第 个模块在位置 手里有两样东西: 上一深度对前缀 的理解, 和真实的第 个 token 的嵌入, 要预测的是第 个. 这就是「保持因果链」的含义: 它不像 Gloeckle 的并行头那样从同一个 猜两步之后, 而是先把中间那个真实 token 喂进去再猜下一个. 因为要用到 , 第 个模块只能处理前 个位置, 所以式 22 切片到 . 两处 RMSNorm 让主模型表示和词嵌入在拼接前尺度一致, 把 维拼接压回 维, 也就是上一节说的那个 7168×14336 投影. 总损失是主模型的 next-token 交叉熵加 , 前 10T token 取 0.3, 剩余 4.8T 取 0.1. MTP 的梯度经 回到主干, 另外还经共享的嵌入层和输出头回流; 推理时丢掉模块, 留下的就是被这几路梯度塑形过的主模型. 报告给的动机有两条: 训练信号更密, 可能提高数据效率; 模型可能会提前为未来 token 规划表示. 两条都是动机不是理论——没有分析证明 MTP 必然有效, 证据就是 Table 4 的消融; 「可能」出现了两次, 报告自己也没把话说死. 这类先有效、后补理论的设计在深度学习里是常态, 按实验行为对待即可. MTP 的一般机制见 多 Token 预测 MTP.
Table 4 的消融在推理时丢掉 MTP 模块, 两边推理成本完全相同, 比的只是训练目标. 小档 15.7B 训 1.33T token, 大档 228.7B 训 540B token. 大档 HumanEval 从 44.5 升到 53.7, 小档从 20.7 升到 26.8; 小档 GSM8K 从 25.4 升到 31.4, MMLU 从 50.0 升到 53.3. 反例同样存在: 大档 MMLU 从 67.5 降到 66.6, 小档 NaturalQuestions 从 22.7 降到 22.3. Pile-test BPB 几乎不变(0.729 对 0.729, 0.658 对 0.657), 说明 MTP 没有让下一个 token 的预测变好多少, 提升集中在代码和数学这类需要多步规划的生成任务上. 两组消融的大档训练量不同(MTP 540B, 均衡 578B), 基线也不是同一个, 所以不能把两张表的提升直接相加当作 V3 相对 V2 的增益.
推理时 MTP 模块可以丢掉, 也可以改作投机解码的草稿头。接受的含义: MTP 猜出第二个 token, 主模型的下一个前向顺手验证。判据是标准的接受采样。 是投机解码头自己的 softmax——它前向一遍, 输出头在词表上给出对猜测 token 的信心, 比如 ; 是主模型验证前向的 softmax——主模型把草稿 token 当输入, 做它本来就要做的那个前向, 输出头给出权威判分, 比如 。两者是同一个东西(词表上的 softmax), 只是一个出自解码头、一个出自主模型。
这个公式的意义是校正: 草稿的 proposal 来自 , 长期看输出会偏向 ; 让每个 proposal 以 的概率存活, 存活频率恰好抵消 的偏移, 净效果等于主模型自己采样——所以投机解码只加速、不换分布, 这是它能无脑上线的原因。 封顶在 1, 因为概率不能超过 100%。草稿夸大了()必收; 越心虚( 小)按比值打折; 自信地猜错最容易被拒。
被拒时从残余分布 归一化后重采样——把草稿多算的那部分扣掉再补样, 分布依旧与主模型严格一致。
走一遍完整的。已生成「我爱北京」, 第 6 个 token 待定:
- 主模型前向, 采出第 5 个 token「天」(常规步骤, 没有投机)。
- 草稿头拿到「京」的 hidden state(上下文摘要, 即训练时说的深度 0 输出, 主模型这步前向顺手就有)和「天」的嵌入(预测目标前一位的 token), 猜第 6 个是「安」, 给出 :{安: 0.7, 门: 0.15, …}。
- 主模型把「天」接进输入做验证前向, 给出第 6 个位置的 :{安: 0.4, 门: 0.3, …}。
- 只对草稿猜的那个词「安」做判定: , , 接受概率 。接受, 这一步吐「天 安」两个 token; 拒绝, 从残余分布重采样(比如「门」), 输出「天 门」。
判定是抽签不是过线: 从 抽均匀随机数 , 小于接受概率就过——同一句草稿每次跑结果都可能不同。且必须随机: 只有按 的概率随机接受, 长期频率才精确抵消 的偏移, 任何确定性阈值都保不住分布不变。判定全程只用两个数——草稿分布和主模型分布在同一词上的概率, 与任何训练超参无关。
§5.4.3 报告第二个 token 的接受率在 85% 到 90% 之间(接受次数÷草稿次数, 各类生成主题上的统计), 解码速度达到 1.8 倍 TPS。按 D = 1, 每步期望产出 个 token, 取 0.85 到 0.9 时为 1.85 到 1.9, 实测 1.8 倍, 差额应是草稿模块和验证的额外开销。报告没有给出按任…7 tokens truncated…高精度, 其中 AdamW 的一阶, 二阶矩改用 BF16, 报告说没有观察到效果下降; 这些高精度部分的显存开销由数据并行分片摊掉. 混合精度的一般做法见 FP8 混合精度训练详解.
FP8 的难点是动态范围小, 常规做法按整个张量的最大绝对值定比例因子, 一个离群值就会把其他元素压到下溢. V3 改用细粒度量化: 激活按 1×128 的 tile(每个 token 每 128 个通道)分组, 权重按 128×128 的 block 分组, 每组各有比例因子, 并在线计算每组的最大绝对值, 不用延迟量化那样依赖历史最大值. 分组小了以后, 组内元素相当于共享指数位, 所以 V3 所有张量都用 E4M3 格式(4 位指数, 3 位尾数), 而不像以往在反向用范围更大, 精度更低的 E5M2. 这套做法与 microscaling 格式思路一致, Blackwell 的 Tensor Core 已宣布原生支持更小粒度的 microscaling.
另一个问题是累加精度. 报告实测 H800 的 FP8 GEMM 在 Tensor Core 里只保留约 14 位进行累加: 32 个尾数乘积按最大指数右移对齐后, 只取最高 14 位相加. 两个 K = 4096 的随机矩阵相乘, 最大相对误差接近 2%. V3 的办法是每累加 个元素(相当于 4 条 WGMMA 指令), 就把部分和拷到 CUDA Core 的 FP32 寄存器里做全精度累加, 顺便乘上沿 K 维分组的比例因子完成反量化. 这会降低单个 warpgroup 的 WGMMA 发射率, 但 H800 上通常有两个 warpgroup 并发, 一个做提升累加时另一个做矩阵乘, Tensor Core 利用率仍然较高. 后来开源的 DeepGEMM 把这一过程描述为 FP8 GEMM 先得到每 128 个元素的部分和, 再在 FP32 中累加.
存储和通信也压到低精度(§3.3.3). 注意力之后那个线性层的输入同时被注意力的反向用到, 对精度敏感, 用定制的 E5M6 格式; 它在反向要从 1×128 tile 转成 128×1 tile, 比例因子取 2 的整数次幂, 避免转换时引入额外量化误差. MoE 中 SwiGLU 的输入按 FP8 缓存, 反向时重算输出. dispatch 前的激活量化成 FP8 再发送, down-projection 前的激活梯度同样处理; 前向和反向的 combine 保持 BF16. 附录 B.1 在约 16B(训 1.33T token)和约 230B(训约 0.9T token)两个规模上对比 BF16, 相对损失误差始终低于 0.25%. 附录 B.2 是一个反例: 把 Dgrad 相关张量都按 128×128 block 量化, 16B 模型训到约 300B token 时发散. 报告的解释是激活梯度在 token 之间极不均衡, 存在与 token 相关的离群值, block 量化无法按 token 隔离它们, 这也说明了激活为什么要按 1×128 的 token 方向分组.
3. 预训练
3.1. 预训练数据, 分词器与日程
数据上, 数学和代码样本的比例相比于 V2 提高了, 并把多语覆盖扩展到中英文以外(§4.1), 处理流程在减少冗余的同时保持多样性. 具体配比, 各语言占比, 去重规则, 报告都没有给. 文档打包沿用 Ding 等人的做法保证数据完整性, 但训练时不做跨样本注意力掩码, 同一条 4K 序列里的不同文档可以互相看到. FIM 按文档级 0.1 的比例施加, 格式是 Prefix-Suffix-Middle, 与 DeepSeekCoder-V2 一致; 报告称它不损害 next-token prediction, 又让模型学会根据前后文补中间. 分词器是 128K 词表的 byte-level BPE, 预分词器和训练数据为多语压缩率做了调整.
分词器有一处值得注意的副作用. 新的预分词器引入了标点与换行合并的 token, 当多行提示最终没有换行时, 模型看到的 token 边界与训练中常见的不同, 这就是 token boundary bias, few-shot 评测的提示最容易触发. V3 的处理是训练时随机拆开一部分这类合并 token, 让模型见过更多边界情形. 拆开的比例报告没有给. 这一细节会影响第 3.3 节的 Base 评测: few-shot 提示的格式稍有变化, 分数就可能漂移, 而报告只说所有模型用同一套内部框架评测.
训练超参: AdamW, , , weight decay 0.1, 梯度裁剪 1.0, 序列长度 4K. 学习率前 2K 步线性升到 2.2e-4, 恒定到 10T token, 再在 4.3T token 内按余弦降到 2.2e-5; 末尾 500B token 中, 前 333B 保持 2.2e-5, 后 167B 降到 7.3e-6. batch 在前 469B token 内从 3072 条升到 15360 条, 之后保持. 满 batch 每步约 62.9M token, 剩余约 14.3T token 约需 22.8 万步, 加上 batch 爬升期约 1.2 万步, 总共约 24 万步. MTP 权重在 10T 处从 0.3 降到 0.1, 与学习率开始衰减是同一时刻; 偏置更新速度在 14.3T 处归零, 与末尾 500B 的恒定学习率同步. 整个日程由三个切换点组成: 10T, 14.3T 和 14.633T.
预训练用了 2664K GPU 小时, 每万亿 token 约 180K GPU 小时, 在 2048 卡上约 3.7 天(§1). 按每 token 6 倍激活参数的前向加反向计算量, 14.8T token 约需 3.3e24 FLOPs; 2664K GPU 小时按 H800 稠密 BF16 峰值约 989 TFLOPS 算, 可用算力约 9.5e24 FLOPs, 折合 BF16 口径的算力利用率约 35%, 若按 FP8 峰值算则约 17%(未计注意力打分和 MTP 模块的计算量). 报告说全程没有出现不可恢复的损失尖峰, 也没有回滚; 这一点对成本很重要, 因为 Table 1 的小时数假设每一步都只跑一次. Scaling 的一般讨论见 Scaling Law.
3.2. 长上下文: YaRN 两阶段到 128K
长上下文扩展沿用 V2 的做法(§4.3): 预训练后用 YaRN, 分两个阶段各训 1000 步, 从 4K 扩到 32K, 再到 128K. YaRN 只作用于解耦的共享键 , 因为只有这 64 维带 RoPE. 两阶段超参相同: 扩展倍数 , , , 注意力温度因子 . 第一阶段序列 32K, batch 1920; 第二阶段序列 128K, batch 480; 学习率都是 7.3e-6, 与预训练末段相同. YaRN 的频率插值机制见 长度外推: 从 PI 到 YaRN.
V3 与 V2 报告给出的 YaRN 系数不一致. V3 称配置「与 V2 一致」, 但 V2 写的是 , V3 写的是 0.1. 时, 前者约 1.26, 后者约 1.37. 0.1 是 YaRN 原论文的推荐值, 0.0707 是 V2 的取值; 现有信息无法区分这是配置变更还是报告笔误. 训练量方面, 两阶段每步 token 数相同, 各约 1000×1920×32K ≈ 63B token, 合计约 126B. 上下文扩展用了 119K GPU 小时, 每 B token 约 0.94K GPU 小时, 是预训练的约 5 倍, 主要因为注意力计算量随序列长度平方增长.
长上下文的评测只有两类. Figure 8 是 SFT 之后的大海捞针测试, 在 128K 以内全部通过(读图); Chat 评测里有 FRAMES(需要在约 100K token 上下文里问答), LongBench v2 和 DROP. V3 在 LongBench v2 上得 48.7, 略高于 GPT-4o 的 48.1; FRAMES 73.3, 低于 GPT-4o 的 80.5. 大海捞针只测检索, 不测长文推理, 图 8 测的也是 SFT 后模型; 报告没有给出 Base 模型的长上下文结果.
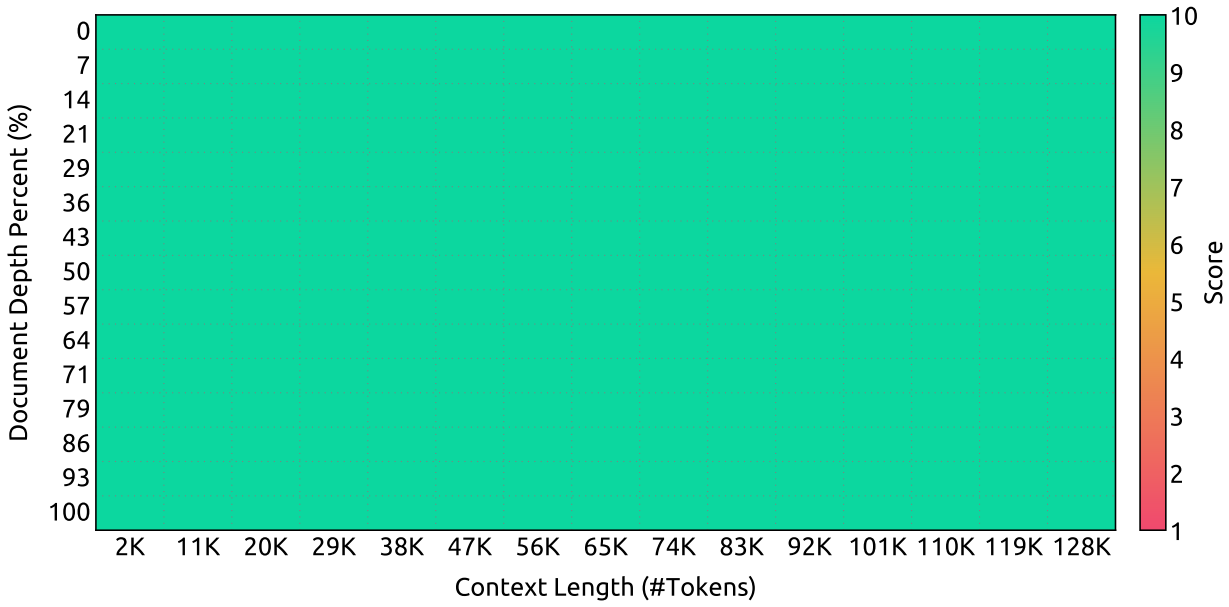
图注: 报告 Figure 8: SFT 后的大海捞针, 128K 内全部命中; 只测检索, 不测长文推理。 报告 Figure 8: SFT 后的大海捞针, 128K 内全部命中; 只测检索, 不测长文推理
3.3. Base 模型评测
Base 评测用内部框架, 所有对比模型用同一套设置, 分差不超过 0.3 视为同一水平(Table 3). 评测协议分三类: HellaSwag, PIQA, WinoGrande, RACE, MMLU 系列, ARC, C-Eval, CMMLU, C3, CCPM 按困惑度打分, 即比较各选项的似然; TriviaQA, NaturalQuestions, DROP, 数学, 代码, BBH, AGIEval, CLUEWSC, CMRC, CMath 按生成打分; Pile-test 用 bits-per-byte, 以消除不同分词器的影响. 报告也承认内部框架近几个月有改动, V2-Base 的分数与之前公布的略有不同.
V3-Base 的优势集中在数学, 代码和多科选择题. MATH 61.6(Qwen2.5 72B 54.4, LLaMA-3.1 405B 49.0), HumanEval 65.2(53.0, 54.9), BBH 87.5, MMLU-Pro 64.4, CMath 90.7, MMMLU 非英语部分 79.4. 它输给 LLaMA-3.1 405B 的项目也不少: Pile-test BPB 0.548 对 0.542, HellaSwag 88.9 对 89.2, PIQA 84.7 对 85.9, WinoGrande 84.9 对 85.2, RACE-Middle 67.1 对 74.2, RACE-High 51.3 对 56.8, NaturalQuestions 40.0 对 41.5. 在 RACE 两项和 WinoGrande 上它甚至低于自家的 V2-Base. 中文方面 CMMLU 88.8 低于 Qwen2.5 的 89.5, CCPM 92.0 低于 V2 的 93.0.
这组输赢与第 3.1 节的数据改动对得上. 数学和代码比例提高, 相应的生成类评测大幅领先; 阅读理解和常识类题目几乎没有进步, 部分还倒退, 说明数据配比向数学代码倾斜, 挤占了一部分通用文本(报告没有给配比无法核实). Pile-test BPB 是最接近纯语言建模能力的指标, V3 用 37B 激活参数略输 405B 稠密模型, 这符合激活参数少 11 倍的预期. 报告「激活参数只有十一分之一却在多数项上更好」的说法成立, 但要加一句: 更好的主要是数学, 代码, 多科选择和多语, 语言建模和阅读理解并没有更好.
4. 后训练
4.1. 后训练数据: 从 R1 蒸馏推理能力
SFT 数据约 1.5M 条, 按领域用不同方法构造(§5.1). 推理类(数学, 竞赛编程, 逻辑题)用内部的 DeepSeek-R1 生成. R1 的输出准确率高, 但有过度思考, 格式差, 过长的问题, 目标是在 R1 的准确率与普通推理数据的简洁之间取平衡. 做法分三步. 先针对代码, 数学或通用推理某一领域, 用 SFT 加 RL 训一个专家模型. 专家模型的 SFT 阶段, 每道题生成两种样本: 一种是「问题, 原始回答」, 另一种是「系统提示, 问题, R1 回答」, 系统提示专门引导模型写出反思和验证. 专家模型的 RL 阶段用高温采样, 即使没有系统提示, 模型也会把 R1 的模式和原始回答的模式融合起来; 经过几百步 RL, 中间模型学会了 R1 的模式. 最终用专家模型做拒绝采样, 为 V3 筛出最终的 SFT 数据.
非推理类(创意写作, 角色扮演, 简单问答)用 DeepSeek-V2.5 生成回答, 再由人工核验准确性. SFT 训 2 个 epoch, 学习率按余弦从 5e-6 降到 1e-6; 多个样本打包进一条序列, 但用样本掩码让它们互相不可见. 这与预训练的做法相反, 预训练打包时不做跨样本掩码. 各领域的样本数量, 专家模型的规模, 拒绝采样的判据, 报告都没有给. SFT 的一般做法见 SFT.
§5.4.1 用 V2.5 做了蒸馏消融(Table 9): 基线用短 CoT 数据训练, 对照组用上述专家模型生成的数据. LiveCodeBench-CoT 的 Pass@1 从 31.1 升到 37.4, 平均长度从 718 到 783, 只多约 9%; MATH-500 从 74.6 升到 83.2, 平均长度从 769 到 1510, 几乎翻倍. 数学的提升是用长度换来的, 代码的提升却几乎不增加长度, 说明两个领域从 R1 学到的东西不同: 数学学到的是多写验证步骤, 代码学到的更可能是解题思路本身. 报告说为 V3 「仔细选择了蒸馏的最优设置」来平衡准确率与长度, 但具体设置和 V3 最终的平均输出长度没有公布. 这组消融的对象是 V2.5 而不是 V3, 数学和代码以外领域的蒸馏效果也没有测. 蒸馏的一般讨论见 知识蒸馏.
4.2. RL: 两类奖励和 GRPO
奖励分两类(§5.2.1).
- 规则奖励用于能按规则验证的题: 数学题要求把最终答案写在指定格式里(如方框中)再比对, LeetCode 题用编译器跑测试用例. 报告强调规则奖励不容易被模型利用漏洞, 所以能用就用.
- 模型奖励用于其余情况: 有自由形式标准答案的题, 由奖励模型判断回答是否与标准答案一致; 没有标准答案的题(如创意写作), 奖励模型根据问题和回答给出反馈. 奖励模型从 V3 的 SFT checkpoint 训练而来, 偏好数据除了最终奖励, 还包含得出奖励的 CoT, 报告说这能降低特定任务上的 reward hacking.
策略优化用 GRPO(式 26–28), 与 V2 相同. 每道题从旧策略采样一组 G 个回答, 用组内奖励的均值和标准差把每个回答的奖励标准化成优势, 省掉与策略同规模的 critic 模型. 目标函数是 PPO 式的截断比率项减去 KL 惩罚, 式 26 里的比率写成整个回答的概率比 , 是序列级写法; KL 用式 27 的无偏估计 . 组大小 G, 截断系数 , KL 系数 , RL 步数和提示集规模都没有给. 后训练总共只用了 5K GPU 小时, 与预训练的 2664K 相比几乎可以忽略, 说明这一轮 RL 的规模很小, 和随后 R1 的大规模 RL 不是一个量级. GRPO 的推导见 GRPO.
§5.4.2 描述了自奖励: 在难以写硬规则的通用场景, 用 constitutional AI 的思路, 以 V3 自己投票评判的结果作为反馈. Table 8 在 RewardBench 上评了 V3 的判断能力: 平均 87.0, 用 6 次投票(maj@6)后 89.6; Claude-3.5-Sonnet-1022 是 88.7, GPT-4o-0806 是 86.7. 报告说单次判断与最好的 GPT-4o 和 Claude 版本「相当」, 按表 V3 单次比 Claude-1022 低 1.7, 投票后才反超. 自奖励让主观评测明显提升, 但没有给出提升多少的对比数字; 用模型自己当裁判, 也有把自身偏好放大的风险, 报告没有讨论.
4.3. Chat 模型评测
评测设置(§5.3.1): 所有模型输出上限 8192 token; 样本少于 1000 条的评测集用不同温度多次评测取平均; AIME 2024 和 CNMO 2024 用温度 0.7 跑 16 次取平均, MATH-500 用贪心解码; MMLU, DROP, GPQA, SimpleQA 用 simple-evals 的提示; SWE-Bench Verified 用 agentless 框架; LiveCodeBench 取 2024 年 8 月到 11 月的题. 对比模型包括 Qwen2.5 72B Instruct, LLaMA-3.1 405B Instruct, Claude-3.5-Sonnet-1022, GPT-4o-0513, 闭源模型通过 API 评测.
Table 6 的主要数字: MMLU 88.5, MMLU-Pro 75.9, GPQA-Diamond 59.1, DROP 91.6, MATH-500 90.2, AIME 2024 39.2, CNMO 2024 43.2, LiveCodeBench-CoT 40.5, Codeforces 百分位 51.6, C-SimpleQA 64.8. AIME 只有 30 道题, 39.2% 相当于平均答对约 11.8 道, 16 次平均能降低方差, 但单次差一两道题就是几个百分点. 数学三项比第二名 Qwen2.5 72B 高约 10 个百分点, 报告归功于 R1 蒸馏, 这与第 4.1 节的消融一致. 落后的项目也写在表里: SWE Verified 42.0 低于 Claude 的 50.8, GPQA 59.1 低于 Claude 的 65.0, SimpleQA 24.9 低于 GPT-4o 的 38.2, FRAMES 低于 GPT-4o. SimpleQA 的落后报告归因于把更多训练 token 用在中文知识上, C-SimpleQA 比 Qwen2.5 高 16.4 分, 两者对得上.
开放式评测(Table 7)用 GPT-4-Turbo-1106 当裁判: Arena-Hard 85.5, AlpacaEval 2.0 长度控制胜率 70.0, 比 V2.5 的 50.5 高 19.5, Claude-3.5-Sonnet 是 85.2 和 52.0. AlpacaEval 用了长度控制, 但 70.0 与其他模型 50 上下的差距仍然很大, 裁判模型对写作风格的偏好可能影响结果. LiveCodeBench 的题目来自 2024 年 8 到 11 月, 报告却没有给出预训练数据截止日期, 因而无法判断这些题是否进入训练语料. LongBench v2 在 V3 发布前几周才公开, 污染风险相对较低.
5. 部署, 成本与谱系
5.1. 部署和对硬件的建议
推理把 prefill 和 decode 分开部署(§3.4). prefill 的最小单元是 4 节点 32 卡: 注意力用 4 路张量并行加序列并行, 配 8 路数据并行; MoE 用 32 路专家并行, 让每个专家拿到足够大的 batch. 为了均衡负载, 按在线统计复制高负载专家, 设 32 个冗余专家, 每卡在原有 8 个专家外多放 1 个, 冗余集合定期调整(如每 10 分钟). 同时处理两个计算量相近的 micro-batch, 一个做注意力和 MoE 计算时, 另一个做 dispatch 和 combine. 报告还在试验动态冗余: 每卡放 16 个专家, 每步只激活 9 个, 每层 all-to-all 之前实时算出全局最优路由.
decode 的最小单元是 40 节点 320 卡. 注意力仍是 4 路张量并行加序列并行, 配 80 路数据并行; MoE 用 320 路专家并行, 每卡只放 1 个专家, 其中 64 张卡放冗余专家和共享专家, 256 + 64 = 320 正好对上. decode 时把共享专家当成一个必选的路由专家, 每个 token 相当于选 9 个专家. 每个专家的 batch 通常不超过 256 个 token, 瓶颈是访存而不是计算, 所以 MoE 部分只分少量 SM, 把算力留给注意力. dispatch 和 combine 走 IB 点对点传输, 用 IBGDA 降低延迟. 结论节承认推荐部署单元偏大, 对小团队是负担, 端到端生成速度比 V2 快两倍多, 但仍有提升空间.
§3.5 的硬件建议是把 V3 在软件里绕过的限制列出来. 通信方面: 用 SM 做通信会占掉 132 个中的 20 个, 而且这些 SM 上的 Tensor Core 完全闲置; 希望把 IB 与 NVLink 之间的转发, RDMA 缓冲区搬运, combine 的归约交给协处理器, 并把 IB 和 NVLink 统一成计算单元可直接调用的读, 写, 组播, 归约原语. 计算方面: 提高 Tensor Core 的 FP8 累加精度; 原生支持 tile 和 block 级量化, 让部分和的累加与反量化在 Tensor Core 内完成; 把 FP8 转换和 TMA 访存融合, 在数据从全局内存搬到共享内存的途中完成量化, 报告估计近存计算方案可减少约 50% 的片外访存; 支持从共享内存直接转置读取, 省掉反向时反量化, 转置, 再量化的往返.
5.2. 成本, 局限和谱系位置
Table 1 按 H800 每小时 2 美元租价计算: 预训练 2664K GPU 小时, 上下文扩展 119K, 后训练 5K, 合计 2788K, 约 557.6 万美元. 报告明确说这只包括 V3 的正式训练, 不包括此前在架构, 算法, 数据上的研究和消融. 第 1.4, 1.5 节的消融模型(15.7B 训 1.33T token, 228.7B 训 540B 或 578B token)和附录 B 的 FP8 对比实验本身就要花不少算力, 都不在这个数字里. 部署侧 decode 最少 320 卡, 训练便宜并不意味着服务便宜.
从方法看, V3 的每项改动都有消融或实测支撑: 无辅助损失均衡有 Table 5 和 batch 级对照, MTP 有 Table 4 和接受率, FP8 有附录 B, 蒸馏有 Table 9. 缺的是它们之间的组合效应和规模外推: 消融最大只做到 228.7B 总参, 不到 V3 的三分之一, 训练量不到 V3 的二十分之一. sigmoid 门控, 节点受限路由, 分词器改动, 数据配比变化都没有单独消融. 报告的结论节列出了后续方向: 改进架构以支持无限长上下文并尝试突破 Transformer, 扩大数据的规模和信号来源, 加长推理的长度和深度, 以及建立不易被针对性优化的评测.
谱系上, V3 继承 V2 的 MLA 和 DeepSeekMoE, 把均衡方式换成无辅助损失, 加上 MTP, 用 FP8 和 DualPipe 训完 14.8T token. 后训练阶段它是 R1 的学生: SFT 数据里的推理部分来自 R1 系列专家模型. 反过来, V3-Base 又是 R1 的起点, R1 在它之上做大规模 RL. 之后的 V3.1, V3.2 继续沿用这个 671B 的 MoE 底座, 在注意力稀疏化和混合推理模式上改进. 推理与思考能力的整体脉络见 推理与思考能力.