材料是 CodeI/O: Condensing Reasoning Patterns via Code Input-Output Prediction (arXiv 2502.07316, 2025-02 首发, 收录本为 2025-05 的 v4, 19 页, ICML 2025 口头报告). 作者来自 DeepSeek-AI, 上海交通大学和香港科技大学, 第一作者 Junlong Li 的工作在 DeepSeek 实习期间完成, 通讯作者是港科大的 Junxian He. 代码与数据见 hkust-nlp/CodeIO; 因合作方合规要求, 只公开了 PyEdu-R 子集的 CodeI/O(++) 数据和 LeetCode-O 评测集, 内部 CodeMix 部分和评测框架都没有公开.
论文要解决的问题是: 数学和代码生成有大量结构化训练数据, 逻辑演绎, 科学推断, 符号推理这些领域的监督信号却又少又散. CodeI/O 的回答是从真实代码里取材, 但不让模型写代码, 而是让它读懂一个函数后, 用自然语言推出「给定输入时输出是什么」或「要得到这个输出, 输入可以是什么」. 答案可以靠执行代码自动判对错, 数据量可以靠随机生成输入放大. 数据构造、CoT 生成与执行验证共同决定监督信号的质量, 主实验和消融则分别检验迁移收益及其来源.
1. 从原始代码到可执行的预测题
为什么改写成输入输出预测: 用代码提升推理并不新鲜. DeepSeekMath 在 1.3B 上做过消融, 先训 400B 代码再训数学, 比先训通用语料再训数学的数学成绩更好, 于是从 DeepSeek-Coder-Base-v1.5 起步. 但把原始代码直接当语料继续预训练, 推理信号是隐式的, 和注释, IO, 绘图这些噪声缠在一起. Table 1 给了直接证据: 在 7.7M 个 Python-Edu 文件上用语言模型损失训第一阶段, Qwen 2.5 Coder 7B 的平均分是 54.8, 与只做第二阶段的基线 54.8 完全相同; LLaMA 3.1 8B 上是 49.0, 比基线 49.3 还低. 另一条路是训练文本到代码的生成, 但输出受代码语法约束. Table 3 末行就是这种设置 (prompt 是「please write a piece of python code to solve this problem: {query}」, 响应只有参考代码, 见 GitHub issue #7), 平均 54.9, 同样约等于基线.
CodeI/O 的改写保留了代码里的逻辑, 去掉了「必须写出代码」这一要求. 同一个函数派生两类题. 输出预测给定输入, 要求模型在脑中跑一遍程序, 对应前向执行, 答案唯一. 输入预测给定输出, 要求模型找一个能产生该输出的输入, 对应逆向搜索: 答案通常不唯一, 也没有通用的逆函数, 只能靠假设, 试算和回溯. 论文 §2.3 说两类实例各占约 50%. 两类题都要求最终答案写成 JSON ({"output": ...} 或 {"input": {...}}), 推理过程完全是自然语言. 这样设计的代价是, 推理过程本身无法自动检查, 能检查的只有最终那个 JSON.
1.1. 统一格式的五个部件
原始文件先交给 DeepSeek-V2.5 改写. 官方仓库 codeio_utils.py 里的 build_testcases_prompt_advanced 是这一步的完整提示词, 要求输出四段: 主函数, 输入输出说明, 输入生成器, 问题描述. 论文 §2.2 把它拆成五个部件. 清洗后的参考代码只保留核心逻辑, 删掉 print, 绘图和读写文件. 主入口函数固定命名为 main_solution, 必须有非空参数, 输入输出都必须能 JSON 序列化; 原代码里用到 set, tuple, numpy 数组或自定义对象的, 要在函数开头和结尾做转换. 输入输出说明写清类型, 取值范围, 字典的键. 输入生成器 input_generator 不带参数, 每次调用返回一组带随机性的合法输入, 用字典表示, 供 main_solution(**kwargs) 调用. 问题描述要写成一个非编程的 wh 问句, 提示词明确禁止出现「implement a function」「write a function」这类说法, 但要点出输入变量名.
附录 G 的 Table 10 是一个例子: 原始文件是一段描述「由竖直加速度积分出速度和位移」的伪代码, 改写后的 main_solution(acceleration, time, initial_speed, initial_displacement) 用梯形公式逐步累加, 返回 {"speeds": [...], "displacements": [...]}; 生成器产生 10 个 内均匀分布的加速度, 时间步长 0.1, 初速度和初始位移取 内的随机数. 这一步的损耗不小: 810.5K 个原始文件最终只剩 454.9K 个进入数据集, 约 56%. 仓库自带的 1000 个示例文件 (作者在 issue #4 中说明是用 gpt-4o-mini 处理的) 解析成功 464 个, 比例相近.
采样输入输出对与复杂度约束: parse_gen_ios.py 把改写结果拼成一段脚本, 在子进程里最多调用 1000 次 input_generator, 收集至多 10 个互不相同, 且输入输出都通过尺寸检查的样例, 整段脚本限时 60 秒; 少于 2 个样例的函数直接丢弃. 尺寸检查 strict_check_size 就是附录 A 印出的那段递归函数: 对象总大小小于 1024 字节 (用 pympler.asizeof 计), 列表, 元组, 集合和字典的长度小于 20, 字符串短于 100 个字符, 其他类型小于 128 字节, 逐层检查所有子对象. 这些阈值的用意是让答案能被一般 LLM 一次写出, 例如一个 50 项的浮点列表, 模型即使推理正确也很难一字不差地写完.
论文 §2.3 说, 为保证输出确定, 含随机性的函数会被跳过. 附录 G Figure 8 的两只水壶题在参考代码开头导入了 random, 函数体却没有调用它; 验证脚本的前缀 solution_prefix 也默认导入 random. 现有材料更符合「过滤函数体内的随机调用」这一实现, 但论文没有公开具体判据. 采样之后, 每个函数按来源取不同数量的样例 (附录 C.2):
| 来源 | 原始文件 | 保留函数 | 每函数上限 | 平均输入/输出实例 | 实例总数 |
|---|---|---|---|---|---|
| CodeMix | 427K | 300K | 3 对 | 2.78 / 2.80 | 1,674,345 |
| PyEdu-R | 369K | 141K | 6 对 | 5.77 / 5.79 | 1,630,716 |
| 其他来源 | 14.5K | 13.9K | 10 对 | 7.70 / 7.87 | 216,159 |
每个来源的实例数等于函数数乘以两类实例的平均数之和, 输入预测和输出预测分开计 (作者在 issue #3 中确认):
代入 CodeMix 得 , PyEdu-R 得 , 三项合计 3,521,220, 就是正文的 3.5M (Table 2 写作 3.52M). 表里也能看出取材策略: CodeMix 函数多但每个只取 3 对, PyEdu-R 函数少一半但每个取 6 对, 两者贡献的实例数几乎相等; 来自算法仓库, Project Euler, LeetCode 等平台的「其他来源」只占 6%, 每个函数取得最多. CodeMix 的筛选办法也值得写出来: 用 DeepSeek-Coder-V2-Lite-Inst 对每个文件派生的函数补全任务求成功率, 只留成功率在 10% 到 90% 之间的文件, 太容易和太难的都去掉. PyEdu-R 则是从 7.7M 个 Python-Edu 文件里用 DeepSeek-Coder-V2-Lite-Inst 和 DeepSeek-V2.5 分类, 去掉「算法」和「非推理」两类, 避免和以算法为主的 CodeMix 重复.
CoT 的生成, 验证与一轮修订.
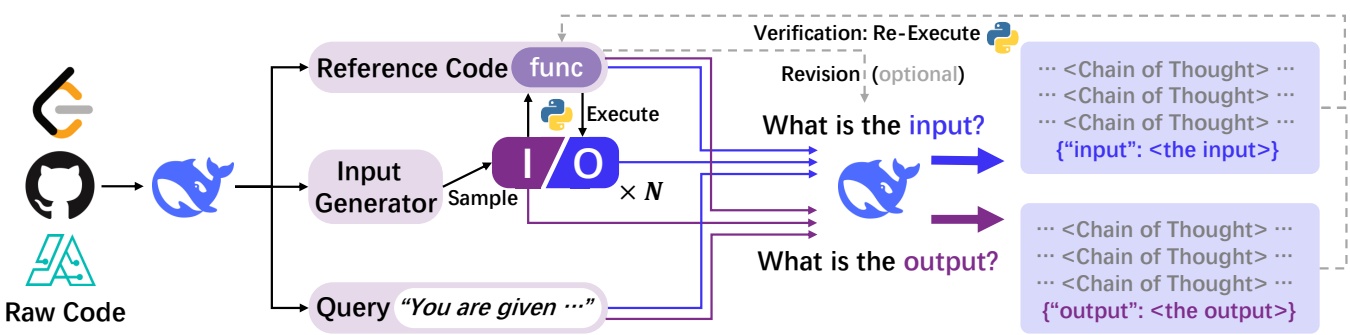
图注: 左边三个来源图标代表原始代码, 经 DeepSeek 模型改写成参考代码, 输入生成器和查询三路; 输入生成器采样输入, 执行参考代码得到输出, 「」表示每个函数重复多次. 中间第二个 DeepSeek 图标是写 CoT 的 DeepSeek-V2.5, 它同时收到三路信息, 回答「输入是什么」或「输出是什么」. 图 1 解析: 左边三个来源图标代表原始代码, 经 DeepSeek 模型改写成参考代码, 输入生成器和查询三路; 输入生成器采样输入, 执行参考代码得到输出, 「」表示每个函数重复多次. 中间第二个 DeepSeek 图标是写 CoT 的 DeepSeek-V2.5, 它同时收到三路信息, 回答「输入是什么」或「输出是什么」. 右上的虚线箭头是可选的验证与修订回路, 对应 CodeI/O++. 图里没有画出过滤环节 (不可执行, 超时, 超尺寸), 也没有画第二阶段的指令微调.
1.2. prompt 模板与直接提示
训练和数据收集用的是同一个 prompt, 模板在 codeio_utils.py 里: 先是「You are given a question that requires some input and output variables as follows:」加查询, 再是输入输出说明, 然后是「Given the following input:」或「Given the following output:」加具体数值, 最终要求「without writing any code」推理并给出 JSON. 参考代码作为提示附在最终, 前面一句是「You can refer to this code to guide your reasoning but not copy spans of code directly」. 所以模型其实看得到完整代码, 要做的是按代码手工执行或手工反推, 但必须用自然语言写出来. 图 2 的硬币找零题是一个输出预测的样例: 给定 amt=25, coins=[1,4,7], CoT 依次枚举用 3, 2, 1, 0 枚 7 的组合, 得到最少 4 枚; 同一题的输入预测样例给定输出 4, 模型试了 凑 8, 凑 6 和凑 8 都不满足, 最终给出 amt=13, coins=[1,2,5], 即 .
为什么不直接用代码执行轨迹当监督? §2.4 给了两个理由. 第一, 输入预测需要逆函数, 一般程序没有确定的逆; 第二, 按模板自动生成的轨迹表达力有限, 迁移不到自由文本推理. 因此全部 CoT 都由 DeepSeek-V2.5 生成, 论文给出的理由是它性能处于第一梯队, 调用成本远低于同级模型. 这个选择的直接后果是 CoT 质量受教师模型限制: 附录 D 的 Figure 7 显示, 首轮输入预测正确 50.0%, 输出预测正确 51.8%, 一半左右的训练样本答案是错的. CodeI/O 主实验把对错样本全部保留, 第 4.1 节会看到这样做为什么比只留对的好.
执行器怎么判对错: 验证分两种, 实现在 check_io_pred_acc_mp.py. 先用 extract_last_complete_json 从响应里抽末个完整 JSON (优先找 json 代码块, 找不到就用括号栈找末个顶层花括号, 还会把 Python 的 True/False/None 换成 JSON 写法, 甚至兜底解析 \boxed{}); 抽不到, 或者缺 output/input 字段, 状态记为 no answer. 输出预测直接把预测值和缓存的真实输出比较, 比较函数 is_close 对字典要求键集合相同并逐键比较, 对列表要求长度相同并逐项比较, 对数值的判据是:
是预测值, 是真实值, 是 Python 的向零截断. 只要有一个是浮点数就走这条; NaN 和无穷一律判错; 两个都是整数时要求严格相等. 第二个条件防止 很大时相对误差放过整数部分不同的答案. 这条判据也有边界: 时右边的容差为 0, 浮点预测必须精确为 0; 布尔值在 Python 里是整数的子类, True 和 1 会被判为相等.
输入预测不能和缓存的输入比, 因为可行输入不唯一. 验证脚本把参考代码和预测输入拼成一段程序, 在子进程里执行 main_solution(**pred_input), 把结果先按 JSON 字符串比较, 不相等再用 is_close 比较, 都不满足就抛出 AssertionError, 消息是「[Mismatch] Your input is not feasible! Given the output ..., your predicted input is ..., which actually gets a wrong output as ...」. 执行限时 5 秒, 超时记为 timeout, 其他运行错误记为 exception 并截取异常类型和消息. 这几类状态正好对应 Figure 7 的 Correct, Wrong, Exception, No Answer, Timeout. 输出预测不用执行代码, 所以只有 Correct, Wrong, No Answer 三类.
一轮修订与拼接方式: CodeI/O++ 对首轮判错的响应追加一轮对话. build_codeio_rev_msg.py 把首轮响应作为 assistant 消息, 再把验证消息作为 user 消息追加, 末尾加一句「Please redo it, and your prediction should no longer be any of the wrong ones you have made before!」. 反馈内容按任务类型不同: 输出预测只告诉模型答案错了 (消息里给出输入和它的错误预测, 不给正确答案); 输入预测额外给出用错误输入实际跑出的输出; 执行失败的给出异常信息. 第二轮生成后再验证一次. 训练样本把四段拼成一条: 第一轮响应, 第一轮反馈, 第二轮响应, 第二轮反馈, 首轮就对的样本反馈只有「Success」, 没有后两段. 作者在 issue #1 中说明, 拼接时插入了过渡用的模板串, 也就是 Table 11 里「Let me check if I did it correctly ..... Oops! Something went wrong」「Well ..... I apologize for the oversight」「Yes, that's correct! I made it!」这些句子; 开源的 assemble_codeio_demo.py 只输出四个字段, 不含这些模板串, 复现时需要自己补.
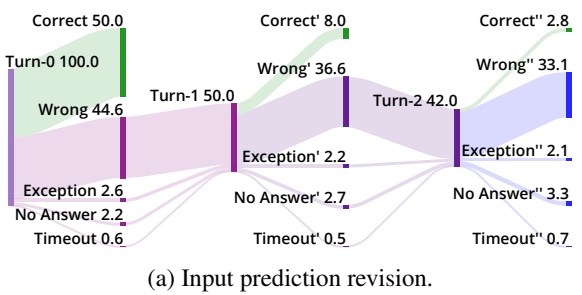
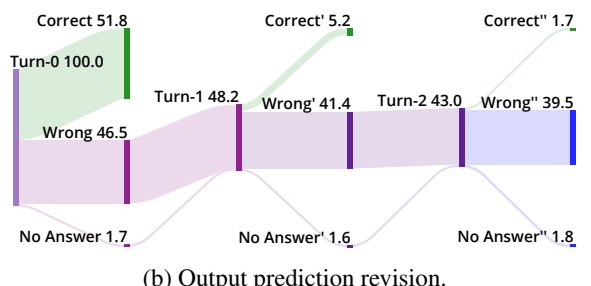
图注: 两张桑基图分别是输入预测 (上) 和输出预测 (下), 从左到右是首轮, 第一轮修订, 第二轮修订, 数字是占全体实例的百分比. 输入预测首轮 Correct 50.0, 进入第一轮修订的 50.0 中改对 8.0, 修正率 16%; 第二轮修订 42.0 中只改对 2.8, 修正率 6.7%. 图 7 解析: 两张桑基图分别是输入预测 (上) 和输出预测 (下), 从左到右是首轮, 第一轮修订, 第二轮修订, 数字是占全体实例的百分比. 输入预测首轮 Correct 50.0, 进入第一轮修订的 50.0 中改对 8.0, 修正率 16%; 第二轮修订 42.0 中只改对 2.8, 修正率 6.7%. 输出预测首轮 Correct 51.8, 第一轮修订 48.2 中改对 5.2, 修正率 10.8%; 第二轮 43.0 中改对 1.7, 修正率 4.0%. 图里看不出修订改对的样本 CoT 质量如何, 也看不出 Exception 和 Timeout 在修订后是否转成了 Wrong.
按图 7 算, 修订一轮之后输入预测累计正确 58.0%, 输出预测 57.0%, CodeI/O++ 里仍有四成多的最终答案是错的. 正文 §2.4 写「错误响应中 10% 能在第二轮修正」, 只对应输出预测一侧. Table 11 的完整样例还暴露出一个问题: 题目是「和至少为 target 的最短连续子数组长度为 4」, 首轮给出 target=10, numbers=[1,2,3,4,5], 执行反馈说实际输出是 3 (子数组 和为 12); 第二轮 CoT 先试 , 中途说「再加一个 2, 的和仍是 8」, 这段推理并没有朝答案推进, 最终给出 才碰对. 验证只看最终 JSON, 这样一段推理过程在训练数据里被标成「Yes, that's correct!」.
2. 两阶段训练与主结果
训练配置与两阶段的理由: 四个基座是 Qwen 2.5 Coder 7B, DeepSeek Coder V2 Lite (16B 总参数的 MoE, 见 DeepSeek-Coder-V2 解析), LLaMA 3.1 8B 和 Gemma 2 27B, 两个代码模型, 两个通用模型. 第一阶段在 CodeI/O(++) 上训 1 个 epoch, 恒定学习率, 三个小模型 1e-5, Gemma 4e-6; 第二阶段在约 1.18M 条内部指令数据上训 700 步, 学习率 3e-5 (Gemma 1e-5), 余弦衰减到 1e-6 (Gemma 3e-7). 两阶段的 batch size 都是 1024, 都不用 warmup, 最大长度 4096 (附录 E). 训练是普通 SFT, 损失只算在响应上, CodeI/O++ 的多轮内容拼成一条长响应, 所以也是单轮 SFT.
附录 E 说第二阶段 700 步「约相当于指令数据的 3 个 epoch」, 按样本数算对不上: 条序列只有 1.18M 的 0.61 个 epoch, 3 个 epoch 需要约 3.54M 条. 文中没有给出 batch 的计量单位, 如果训练时把多条样本拼接 (packing) 进 4096 长度的序列, 平均每条序列装约 4.9 条样本才对得上, 这只是从已知数字推出的说法, 没有数据验证. 为什么要分两阶段, §3.1 的理由是规模悬殊: CodeI/O 有 3.5M 条, 指令数据只有 1.18M 条, 直接混合会让指令数据学不充分. Table 4 用 Qwen 和 LLaMA 检验了这一点.
| 第一阶段 | 第二阶段 | Qwen | LLaMA |
|---|---|---|---|
| 无 | IT | 54.8 | 49.3 |
| 无 | CodeI/O(10%)+IT | 56.6 | 50.5 |
| CodeI/O+IT | 无 | 55.9 | 49.7 |
| CodeI/O | IT | 57.2 | 51.2 |
| CodeI/O+IT | IT | 56.8 | 51.5 |
| CodeI/O | CodeI/O(10%)+IT | 57.0 | 52.7 |
表中 IT 指指令微调数据. 把全部 CodeI/O 与指令数据一次混训 (第三行) 只比基线高 1.1 和 0.4, 是所有用到 CodeI/O 的设置里最差的, 支持「数据量悬殊时混训会稀释指令数据」的说法. 只混 10% 的 CodeI/O 做单阶段 (第二行) 已经能拿到 56.6, 离两阶段的 57.2 只差 0.6. 两阶段内部的混合方式在两个模型上结论相反: Qwen 最好的是完全分开 (57.2), LLaMA 最好的是第二阶段再混入 10% CodeI/O (52.7, 比完全分开高 1.5). 论文最终取完全分开, 理由只是方法简单.
2.1. 评测集与基线的口径
评测有 14 列: WinoGrande, DROP, GSM8K, MATH, GPQA, MMLU-STEM, LeetCode-O, CRUXEval-I, CRUXEval-O, BBH-EN, BBH-ZH, ZebraLogic, KorBench, LiveBench. 除 BBH 用 3-shot, 其余都是 zero-shot 贪心解码. 有几个口径需要记住. LiveBench 用 2406-2407 划分, 去掉了代码生成和指令遵循子项. BBH-ZH 是作者把 BBH 的 9 个子任务译成中文. LeetCode-O 是作者自建的输出预测集, 900 题, 简单/中等/困难各 300, 只给题面不给代码, 一道题的所有用例在中英两个版本下都对才得 1 分, 这让 LLaMA 的分数只有 4.1. 测试集规模 (Table 7) 差别很大, GPQA 只有 448 题, LiveBench 672 题, ZebraLogic 1000 题, DROP 有 9536 题; GPQA 上 1 道题就是 0.22 分, 3 分的差距只是 13 道题.
基线分两类. 第一类是只做第二阶段 (2nd Stage Only), 检验多一个阶段有没有用. 第二类是把第一阶段的数据换成别的数据集: WebInstruct (从网页挖掘, LLM 精修, 全量 11.6M), OpenMathInstruct-2 (LLaMA 3.1 405B 在 GSM8K 和 MATH 上扩增, 全量 14M), OpenCoder-SFT-Stage-1 (4.2M 条代码问答), Python-Edu (7.7M 个原始文件, 用语言模型损失训). WebInstruct 和 OpenMathInstruct-2 默认取 3.5M 子集与 CodeI/O 对齐, 只在 Qwen 上报告了全量. 评测里没有 HumanEval, MBPP 这类代码生成基准, 所以 CodeI/O 对代码生成能力的影响, 论文没有给出答案.
Table 1 的提升落在哪里: 先看平均分. 下表把 Table 1 每个基座的基线, 最强对照数据集, CodeI/O 和 CodeI/O++ 放在一起, 括号里是相对基线的差.
| 基座 | 只做第二阶段 | 最强对照数据集 | CodeI/O | CodeI/O++ |
|---|---|---|---|---|
| Qwen 2.5 Coder 7B | 54.8 | 55.2 (OMI2) | 57.2 (+2.4) | 57.7 (+2.9) |
| LLaMA 3.1 8B | 49.…6323 tokens truncated…096 长度的序列, 平均每条序列装约 4.9 条样本, 两个数才能对上. 同理, 第一阶段 3.52M 条样本在 batch 1024 下若不拼接约为 3,438 步, 文中也没有给出第一阶段的步数. |
The Effect of Using Other Instruction-Tuning Data · 换用其他指令微调数据的影响: 除内部指令微调数据外, 我们还用另一个强公开指令微调数据集 Tulu-3 (Lambert et al., 2024) 做了实验. Table 9 给出了在 Qwen 2.5 Coder 7B 上训练的基准表现. 第二阶段换成这个新数据集后, 相对单阶段基线仍有显著提升, 说明 CODEI/O 的稳健性. 但与主实验相反, CODEI/O++ 比 CODEI/O 略差. 一个可能的原因是, Tulu-3 覆盖的指令类型不如我们的内部数据集多, 这可能限制了模型在训练后充分发挥其推理能力.
Examples Mentioned in the Main Text · 正文提到的示例: 本节给出正文提到的示例. Table 10 展示了如何把一个原始代码文件转换成我们设计的统一格式. Figure 8 给出了响应收集和训练中使用的确切 prompt 示例. Table 11 展示了 CODEI/O++ 中一条完整的训练样本: 首轮响应是错的, 但在加入反馈并重新生成后, DeepSeek-V2.5 在第二轮成功把它修正为正确的预测.
与 Coder 路线的准确关系: pass@1、采样与执行器
对每道题生成一个候选并执行测试, pass@1 是通过全部测试的题目比例. 若每题采样 个候选、其中 个通过, 常见 pass@ 无偏估计为
接近用户只接受一次答案的成功率. greedy 解码是确定性候选, sampling 的 pass@1 还要对随机种子取平均. 温度、top-p、最大长度、停止 token、prompt 和代码抽取都会改变 . 报告 Table 3 使用 greedy, 和采用多样采样的外部榜单不能直接横比.
执行器定义「正确」. 测试覆盖不足时, 硬编码样例也能通过; 超时和内存上限过严会杀掉语义正确但低效的代码; 环境缺少依赖时会产生假失败. HumanEval 测自包含 Python 函数, DS-1000 依赖数据科学库版本, LeetCode 需要编译与大量隐藏测试. 分数是模型与 harness 的联合结果.
题目数决定不确定性. 对 道二元题、观测正确率 , 近似标准误
HumanEval 的 164 题在 附近标准误约 3.9 个百分点. 小于数个百分点的差距可能受题目样本影响, 多语言平均还混合各语言题数. 报告没有给 bootstrap 区间, 所以 0.5 个点的 FIM 模型差距更适合读成接近.
exact match、edit similarity 与语义正确: 单行补全 exact match 要求输出与参考字符串完全一致. x += 1 与 x = x + 1 语义相同也会判错, 格式化、引号和变量名差异同样失败. edit similarity 根据字符编辑距离给部分分, 对接近参考的输出更友好, 仍无法确认编译与行为.
令预测 、参考 , Levenshtein 距离为 , 一种归一化相似度为
具体 benchmark 可能采用不同归一化, 复现要看官方脚本. 相似度高的变量替换仍可能语义错, 相似度低的等价重构可能完全正确. IDE 补全关注用户接受率, 离线 exact match 只是代理指标.
FIM 的 HumanEval-FIM 遮住参考解答一行, 上下文与目标都来自 canonical solution. 真实编辑器中前后代码可能未完成、有错误或存在多种设计. 该测试清楚衡量协议是否学会, 对复杂修复的外推有限. 多行 infill、类型检查与仓库测试能补足这块证据.
短函数、真实库与跨文件任务: HumanEval、MBPP 的函数通常在单个 prompt 内自洽, 强调算法与基本 Python. MultiPL-E 把 HumanEval 翻译到多种语言, 可比较语法迁移, 题目语义仍沿用同一集合. 高分说明函数级生成强, 不代表能读 build system、修改多文件和理解大型 API 生命周期.
DS-1000 加入 NumPy、Pandas、SciPy、PyTorch 等库调用, 错误更多来自 API 名称、shape、dtype 与版本语义. 它比纯算法题接近数据科学工作, 仍是相对局部的补全. 库版本必须固定; API 更新后, 同一代码可能从通过变成失败. 报告中的 40.2% 应绑定当时 harness.
CrossCodeEval 显式加入仓库检索. 端到端概率可粗分为
两项并非严格独立乘积, 但能说明错误来源. BM25 没召回定义时, 模型只能猜; 召回后仍错, 才主要是条件生成. 官方只给端到端消融, 没报告 oracle retrieval 上限, 因而不能精确计算仓库训练对生成器的净增益.
PAL 与竞赛题的特殊口径: PAL 让模型把自然语言问题转为程序, 执行器完成精确计算. 成功链条包含题意解析、算法选择、代码生成、运行和答案抽取. 它可以绕开语言模型不稳定的手算, 也会在代码错误或不可形式化题目上失败. PAL 分数与纯 CoT 分数测量不同系统, 不能并排当成模型内部数学能力.
LeetCode Contest 每题大量测试比 HumanEval 更难投机, 题目又较新, 适合检查时间外泛化. 难度随比赛月份和题目级别变化, 月均分不能只解释成污染. 若七八月题目更简单, 两个模型同时偏高很正常; 若训练数据含提前题解, 也会偏高. 需要按难度、标签、发布时间和语义近邻做回归分析.
CoT 对 33B 从 27.8 到 28.9 的变化较小. 它可能帮助规划, 也可能消耗上下文、生成不可执行文字或被代码解析器截断. 提示方法的收益依赖 harness 是否正确抽取末尾代码. 只给 CoT 标签不足以判断内部推理变强.
污染、重复与可证伪归因: 直接匹配没有覆盖的路径
连续 10-gram 能抓到大段原文复制, 代码中的变量重命名、格式化和注释翻译会快速破坏匹配. AST 结构、控制流和输入输出语义可能保持不变. 题解网站还会只保留算法核心, 测试 prompt 则换成新叙述. 因此字符串去污染只能给出下界.
更强流程可分四层. 文本层做 n-gram 与 MinHash; 语法层规范化变量、常量和格式后比较 AST; 语义层用代码 embedding 或执行轨迹找近邻; 时间层只选数据截止后新题. 每层都有误报: 常见二分查找本来就相似, 不能因结构相同全部删除. 报告公开的是文本和时间证据, 未声称完成四层审计.
污染还可能通过自然语言进入. StackExchange 或 Markdown 中出现题目与答案, 即使源码集合已清理, 代码相关文本仍能泄漏. 同一 benchmark 的解释、翻译和测试样例都应检索 10% 文本域. 官方描述对 HumanEval、MBPP、GSM8K、MATH 做了去污染, 具体跨域召回率没有公开.
重复对梯度权重的影响: 若代码片段 出现 次, 经验 loss 中它的权重与 成正比:
FIM、AR与模型分流: Lite为什么保留FIM
第一代Coder通过PSM把前缀、中段、后缀重排为, 学习. Coder-V2 Lite保留FIM, 面向低激活成本的代码补全; 大模型训练只用next-token目标, 更偏复杂生成和指令任务. 两条训练线分别优化补洞协议与复杂生成接口.
混合目标可写为
\mathcal L_q=(1-q)\mathbb E\mathcal L_{AR}(X)+q\mathbb E\mathcal L_{AR}(T_{PSM}(X)).
\mathcal L_{AR}=-\sum_t\log p_\theta(x_t|x_{<t}).
FIM也不等于bug fixing. 给定正确前后文恢复缺口, 与在错误仓库中定位缺陷、修改多处并回归测试差异很大. RepoBench/HumanEval-FIM测补全, Defects4J/SWE-Bench测修复链路. 表格必须分开读.
目标分流的反例: 大模型只做AR仍可能从自然文本提示完成中间代码, 因为prompt可描述缺口; 它缺少官方FIM协议的专门训练. Lite保留FIM也不保证复杂多文件patch, 因为单缺口目标不处理多个编辑位置. 两类模型能力存在交叉, 产品接口的可靠性不同.
可做四格实验: Lite和236B分别用普通续写、自然语言补洞、官方FIM token、multi-file patch. 若236B在FIM token下退化而自然语言补洞强, 差异来自协议; Lite在单行强、patch弱, 说明目标覆盖边界. 论文没有完整四格, 已公开表支持部分判断.
K上下文的训练与验证: YaRN的尺度变换
RoPE对位置按频率旋转Q、K. 原训练长度外直接增加会让相位进入未见区域. YaRN对不同频率分段缩放并调整attention幅度, 目标是在保留短距模式的同时扩展长距. Coder-V2通过两个阶段把上下文推到128K, 不能把config中的最大长度当作所有距离同质量.
长上下文attention计算主项为
C_{attn}\approx4bT^2d
位置容量与有效检索: 模型能接收128K表示位置编码和内存路径支持, 有效利用还受干扰、数据覆盖和任务影响. needle测试可把关键定义放在1K到128K不同位置, 加同名干扰文件, 测调用是否正确. perplexity稳定也不保证仓库修复, 因为后者还需定位和执行.
长代码输入尤其需要选择. 一个大型仓库远超128K, 全量拼接会稀释相关信息. 检索器、符号图和目录导航先选片段, 长窗口承载更多候选与测试日志. 窗口与检索是互补资源, 不能互相替代.
两阶段长度训练的归因: 长度扩展阶段同时继续消费数据, 性能上涨含额外token与位置适配. 对照应从同一checkpoint分出保持短窗口和扩展窗口两组, 固定token/FLOPs或分别报告. 只比较扩展前后无法确定代码分数来自长度还是继续训练.
短上下文也可能回归. 频率缩放改变位置表示, 若短距任务下降, 需要插值策略或混合长度训练. 完整曲线应覆盖4K、16K、64K、128K并同时测短函数、远距检索和长仓修复. 报告给128K规格与若干长任务, 没覆盖所有位置分布.
激活参数、计算与通信: active params不是部署显存
Lite每token激活约2.4B参数, 权重总量16B; 大模型激活21B, 权重总量236B. 单token GEMM成本与active部分相关, 权重服务需要加载总参数或在专家并行设备间分片. batch中不同token选择不同专家, 一个batch可能触及大量总权重.
若专家数, 每token选, 单个token激活比例约加共享专家. 对batch , 被触及专家期望随路由分布增加. cache与通信决定小batch、低延迟场景能否兑现理论优势. 因此2.4B active不能直接等同Dense 2.4B的延迟或内存.
专家并行通信: 路由后token表示要dispatch到专家所在设备, 计算后combine回原序. 通信量近似随增长, 跨节点带宽和消息粒度影响延迟. 代码token路由若偏向少数专家, 热点会造成尾部等待. 理论FLOPs降低, all-to-all可能成为瓶颈.
端到端时间可粗写为
T_{layer}=T_{route}+T_{dispatch}+T_{expert}+T_{combine}+T_{dense}, $$
其中部分可以重叠. active params主要描述的算量, 不覆盖所有项. 模型论文分数无法替代系统benchmark.
Dense与MoE公平比较: 比较第一代33B Dense与Lite 16B/2.4B active, 至少要同时报告总参数、激活参数、训练token、真实FLOPs、显存、tokens/s和任务分数. Lite使用V2初始化、6T新数据和更长上下文, 不是单纯把33B换成MoE. 其高数据效率属于整套配方.
可证伪的MoE实验应在同数据、同token、近似训练FLOPs下训练Dense与MoE, 控制上下文和目标. 若MoE loss/能力更好且墙钟相近, 稀疏容量解释成立; 若通信让成本更高, active参数优势需重新限定.
SFT、奖励模型与GRPO: SFT先建立响应分布
指令数据混合代码、数学与通用任务. 对prompt和回答, SFT损失为
从执行筛选到强化学习反馈: CodeI/O 用执行器筛选数据,但训练仍是监督学习;Coder-V2 后续把编译与测试反馈接入奖励模型和 GRPO。两者共享可执行验证器,却使用不同的优化目标。下面的比较用于界定这种变化。
对齐阶段把可验证反馈转成训练信号: SFT 混合代码, 数学和通用指令
SFT 数据包括约 20k 代码指令, 30k 数学指令, 以及从 DeepSeek-V2 指令集中采样的通用数据, 总量约 300M token. 训练使用 cosine 调度, warm-up 100 步, 初始学习率 , batch 约 1M token, 模型总计接触约 1B token. 指令条数与训练 token 暴露量口径不同, 后者包含重复 epoch 或采样.
16B 在 SFT 阶段继续保留 FIM 数据, 避免自然语言指令微调完全覆盖中间补全格式. 这项安排使同一个 Lite-Instruct 模型既能回答代码问题, 又能使用前后缀补中间. 报告没有给出 SFT 前后 FIM 的单独消融, Table 6 展示的是 Lite-Base, 因而只能确认训练方案保留该目标, 不能量化对齐后 FIM 能力保留了多少.
编译器 0/1 信号先用于训练奖励模型: 数学任务可以用 ground-truth 判定答案. 代码任务也能用编译和测试给出 0/1 反馈, 但有限测试用例无法覆盖所有行为: 一个错误程序可能碰巧通过, 一个输出格式差异也可能被判失败. 直接把该二值结果作为强化学习奖励, 梯度信号离散且带有测试覆盖噪声.
团队先用编译器与测试产生的数据训练代码奖励模型, 再由奖励模型给强化学习提供连续信号. Figure 3 在内部 LeetCode 与 LeetCode-zh 测试上显示, 奖励模型信号优于原始编译器信号. 奖励模型可以从大量已标注样本中学习跨题型特征, 但它不会自动获得测试未覆盖的真实正确性. 其误差可能被策略模型利用, 所以结果支持信号更有效, 不表示奖励已经等价于程序验证.
GRPO 省去 critic, 仍依赖组内比较质量: 强化学习阶段使用 Group Relative Policy Optimization(GRPO), 代码 prompt 过滤后约 40k, 每条配有测试用例. GRPO 对同一 prompt 采样一组回答, 通过组内奖励的相对关系构造优势, 无需像 PPO 那样额外维护 critic 模型. 对 236B 总参数的 MoE, 少一个 critic 能显著减少训练权重与前向计算负担.
省去 critic 不会消除奖励偏差. 如果同组样本整体质量都低, 或奖励模型在某类代码上系统误判, 相对优势仍会把策略推向错误方向. 报告用内部数据比较奖励信号, 但没有公开奖励模型结构, 训练集规模, 组大小与 KL 设置. 因此可以复述 GRPO 的成本优势和信号来源, 无法从报告完整复现 RL 配方.
代码评测要按生成, 补全和修复分开读: 函数级生成、代码补全和软件修复是三种不同能力, 不能用一个 HumanEval 分数代替.
函数生成与竞赛题衡量不同难度: Table 3 在 greedy 解码下给出 236B/21B Instruct 的 Python HumanEval 90.2%, 多语言平均 75.3%, MBPP+ 76.2%. 表内 GPT-4o 的多语言平均为 76.4%, GPT-4-Turbo-0409 为 72.3%. Lite 的多语言平均为 65.6%, 高于上一代 DeepSeek-Coder-Instruct 33B 的 61.9%. 这些数字显示 MoE 续训在函数级生成上取得较高参数效率, 但 HumanEval 的短函数不能代替软件修复结果.
LiveCodeBench 只取 2023 年 12 月至 2024 年 6 月子集, 因为预训练代码截止在 2023 年 11 月以前. 236B 总分 43.4%, 与表内 GPT-4o 相同, 低于 GPT-4-Turbo-0409 的 45.7%. USACO 为 12.1%. LiveCodeBench 的持续新增题降低直接污染风险; USACO 的复杂算法题和高质量测试则显示标准函数生成成绩无法等比例转化为竞赛能力.
CRUXEval 包含 800 个 Python 函数及输入输出, I 任务由输入预测输出, O 任务由输出反推输入. 236B 的 I-COT 为 70.0%, O-COT 为 75.1%. 报告把与更大闭源模型的差距部分归因于仅激活 21B 参数, 这是作者解释, 不是控制变量实验. 架构, 训练数据与对齐方法也同时不同.
Lite 的补全成绩对应低激活成本场景: RepoBench v1.1 来自 2023 年 10 月 6 日至 12 月 31 日创建的 Python 与 Java 仓库. 为避开 11 月前的训练数据, 报告只使用 2023 年 12 月子集. Lite-Base 的 Python 平均为 38.9%, 接近上一代 33B Base 的 39.1%; Java 平均为 43.3%. 它每个 token 激活 2.4B 参数, 但部署速度仍取决于专家并行和硬件通信, 不能只按激活参数线性推算.
单行 FIM 的 Table 6 中, Lite-Base 在 Python 为 80.0%, Java 为 89.1%, JavaScript 为 87.2%, 均值 86.4%. 结果与 0.5 FIM 训练目标一致, 也说明大模型没有参与这条产品定位的竞争. Exact match 对格式敏感, 一行完全一致适合评价自动补全接受概率, 不能度量语义等价的多行修复.
软件修复暴露长上下文之外的瓶颈: Table 7 同时报告 Defects4J, SWE-Bench 与 Aider. 236B Instruct 分别为 21.0%, 12.7%, 73.7%. SWE-Bench 要求根据 GitHub issue 修改真实仓库并通过测试, 它把问题理解, 文件定位, patch 生成与验证串在一起. 12.7% 是报告中首个超过 10% 的开源成绩, 但也意味着大多数问题仍未修复. Lite-Instruct 在 SWE-Bench 为 0.0%, 表明 128K 窗口本身不能弥补模型容量, 检索和复杂指令执行的不足.
Aider 的 73.7% 高于表内 GPT-4o 的 72.9%, Defects4J 21.0% 则低于 GPT-4o 的 26.1%, SWE-Bench 12.7% 也低于 26.7%. 三个基准的输入形式, patch 范围与评分程序不同, 不能取一个最高数字概括所有修复能力. 更稳妥的结论是 V2 已能在部分代码编辑协议中接近闭源模型, 对开放式真实 issue 仍有明显缺口.
数学和通用能力显示了配比的收益与代价: 数学成绩受益于数据与可验证对齐
Table 9 使用 greedy 且不调用外部工具. 236B Instruct 在 GSM8K 为 94.9%, MATH 为 75.7%, 后者接近表内 GPT-4o 的 76.6%. AIME 2024 为 4/30, maj@64 为 5/30, Math Odyssey 为 53.7%. AIME 分母很小, 单题变化就会明显改变比例, 所以报告保留答对题数比换算百分比更合适.
数学提升同时来自 221B 数学预训练语料, 30k SFT 数学指令和 ground-truth 奖励, 报告没有逐项消融三者贡献. 可验证答案让强化学习信号比开放式文本稳定, 但 GSM8K 与 MATH 成绩不能直接归因于 GRPO. 1B 语料消融只报告 HumanEval 与 MBPP, 没有给出数学语料的对应小模型对照.
通用能力没有因 30% 自然语言完全保真.