DSpark 来自 DeepSeek-AI 与北京大学 2026 年 7 月发布的论文 DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation (arXiv 2607.05147), 训练与离线评测代码开源在 deepseek-ai/DeepSpec, V4-Flash 与 V4-Pro 的草稿权重随 DeepSeek-V4 一起发布在 Hugging Face. 它做了两件事: 在并行草稿主干上接一个低秩的顺序头, 让块内后面的 token 能看到前面实际采样出的 token; 再给每个草稿位置配一个置信度, 由调度器结合当前 batch 负载决定每个请求送多少个 token 去验证. 中英对照全文见 DSpark 对照译稿. 拒绝采样的无损性, DFlash 的 KV 注入与 Markov head 的公式推导, 在 DSpark 原理解析 和 DSpark 原理推导 里已经写过, 这里直接引用结论, 把篇幅放在数字核对, 口径辨析和论文与代码的出入上.
1. 并行 drafter 的接受率为什么会衰减
接受长度是一个前缀存活过程: 投机解码每轮的收益由式 (1) 决定: 每 token 延迟 , 是一轮里被接受的 token 数加上目标模型额外给出的 bonus token. 验证按前缀进行, 第 个草稿 token 被接受的前提是前 个都已被接受, 所以期望接受长度可以写成存活概率之和: , 其中 是在前缀全部通过的条件下位置 的接受概率. 单步最优接受概率由式 (8) 给出, , 也就是草稿分布与目标分布全变差距离的补数.
这个乘积结构决定了各位置的权重不对称. 位置 1 的 乘进后面每一项, 它下降 0.05, 后面所有存活项都按同一比例缩小; 位置 7 的 只影响末项. 因此论文在 4.3.1 节特意引入「逐位置条件接受率」: 分母只计前缀已全部通过的样本, 这样每个位置的数字不受更早错误的拖累, 可以直接代入上面的乘积. 想比较两个 drafter 的整体表现, 看接受长度; 想知道差距出在哪一段, 看条件接受率曲线.
1.1. 图 2 里的两种失效
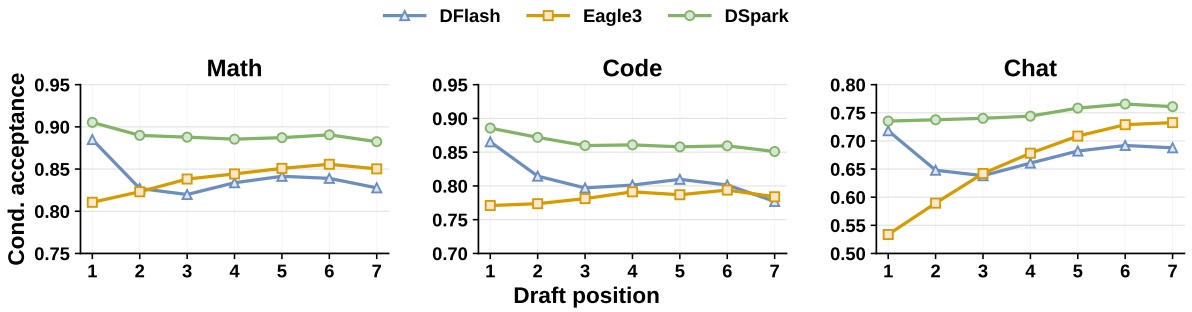
图注: 横轴是草稿位置 1 到 7, 纵轴是条件接受率, 三个子图分别是数学, 代码, 对话, 目标模型为 Qwen3-4B. Eagle3 在位置 1 起点最低 (数学 0.81, 对话 0.53), 之后单调上升, 对话到位置 7 升到 0.74; DFlash 起点高 (数学 0.88, 对话 0.72), 之后下滑, 代码从 0.87 降到 0.78, 对话从 0.72 降到 0.63; DSpark 起点最高 (数学 0.93), 曲线在块内基本持平. 图 2 解析: 横轴是草稿位置 1 到 7, 纵轴是条件接受率, 三个子图分别是数学, 代码, 对话, 目标模型为 Qwen3-4B. Eagle3 在位置 1 起点最低 (数学 0.81, 对话 0.53), 之后单调上升, 对话到位置 7 升到 0.74; DFlash 起点高 (数学 0.88, 对话 0.72), 之后下滑, 代码从 0.87 降到 0.78, 对话从 0.72 降到 0.63; DSpark 起点最高 (数学 0.93), 曲线在块内基本持平.
两种曲线对应两种失效. Eagle3 每个位置跑一次草稿前向, 草稿成本是 , 只能用 1 层, 位置 1 的预测能力受限; 但它每一步都以真实采样出的上一个 token 为条件, 前缀一旦确定, 后续更好猜, 条件接受率上升. DFlash 一次前向给出整块, 能用 5 层, 位置 1 强; 可块内各位置互相看不到对方的采样结果, 位置 的分布是对前 个 token 所有可能取值的边缘化. 前缀越长, 可能的前缀越多, 边缘分布越平, 和目标模型以真实前缀为条件的分布差得越远. 论文沿用非自回归翻译文献的说法, 把这称为多模态碰撞: 位置 3 押注了路径甲的词, 位置 4 押注了路径乙的词, 拼起来的后缀哪条路径都对不上.
容量解释的边界: 论文用「位置 1 的容量差」解释为什么并行 drafter 整体胜过自回归 drafter. 这个解释在 Qwen3 三个规模上成立: 表 1 的 9 个基准平均接受长度, Qwen3-4B 上 Eagle3, DFlash, DSpark 分别是 3.611, 4.064, 4.727, DSpark 相对两者的提升 30.9% 与 16.3% 正是这三个均值之比. 8B 上是 3.798, 4.067, 4.813, 14B 上是 3.676, 4.039, 4.779, 与正文的 26.7%/18.4% 和 30.0%/18.3% 一致. Gemma4-12B 一行给出了反例. 这一行 Eagle3 均值 4.376, 高于 DFlash 的 4.018, DSpark 为 4.663, 相对 Eagle3 只高 6.6%, 相对 DFlash 高 16.1%. 正文只说增益「跨模型家族成立」, 没有给出 Gemma 的百分比, 也没有讨论为什么在这个目标模型上 1 层的 Eagle3 能胜过 5 层的 DFlash. 如果位置 1 的容量差是主因, 这一行应当和 Qwen3 同向. 一个可能的解释是 Gemma 的输出分布更集中, 后缀衰减对 DFlash 的伤害更大, 但文中没有给出 Gemma 的逐位置曲线, 这个解释无法从论文数据验证.
半自回归怎样补回 token 间的依赖: 一次重前向加一个低秩顺序头
DSpark 保留 DFlash 的并行主干: 目标模型若干层的隐状态经 KV 注入送进草稿模型 (式 2 与式 3), 块内双向注意力, 一次前向得到每个位置的隐状态 . 它改的是输出端. 式 (4) 把块内联合分布拆成 , 其中 并行算出, 对 的依赖交给一个轻量顺序头. 默认的 Markov head 只看上一个 token: logits 为 , 偏置 , 是 的嵌入表, 是 的投影, 秩 (式 5). 采样时每一步做一次查表和一次 的矩阵乘, 再从修正后的分布采样, 采样结果作为下一步的 .
这个设计有两个工程上的好处. 逐 token 概率仍是一个精确的 softmax, 拒绝采样需要的 可以直接读出; 相关工作一节举的 CRF-NAT 和 CTC-drafter 都因为全局归一化或对齐路径边缘化拿不到这个值. 顺序部分的计算量与草稿主干深度无关, 主干可以继续加层而串行成本不变. RNN head (式 6) 用一个 GRU 式的状态累积全部前缀, 表达力更强, 但图 4 里它相对 Markov head 只在长提议长度上有边际增益, 部署时默认 Markov head.
从 DeepSpec 的 markov_head.py 能看到两处论文没有写明的细节. 一是 sample_block_tokens 从 anchor 起步, 位置 1 也加了 , 顺序头并不只作用于位置 2 以后. 二是仓库里还有一个 GatedMarkovHead, 用 对低秩嵌入逐维加门控后再投影到词表, 论文正文与附录都没有提到它. 仓库里 Qwen3 三个规模和 Gemma4-12B 的发布配置都写的是 markov_head_type="vanilla", 即式 (5) 的无门控版本.
1.2. 接口改动: anchor 当第一个预测槽
DFlash 的输入块是 anchor 加 个 mask, anchor 所在槽不出预测. DSpark 在 3.1 节把 anchor 本身当成第一个预测槽, 个输入 (anchor 加 个 mask) 产出 个 logits. DeepSpec 里的对应写法是 label_offsets = arange(1, block_size+1): 槽 预测 anchor 之后第 个 token. Qwen3 配置的 block_size=7, 一次前向得到 7 个草稿 token, 加上 anchor 送去验证的是 8 个 token. 这个约定决定了怎么读 4.3.2 节. 那里的「草稿长度 ( 加一个 anchor) 取 {4, 8, 12, 16}」数的是验证宽度, 对应 ; 正文举的 与 正是第二档和第四档. 接受长度含 bonus token, 上限是 . 这个约定在社区实现里造成过实际问题. vLLM speculators 项目训练的 DSpark 检查点沿用 DFlash 的槽位约定, 槽 预测 anchor 之后第 个 token, 槽 0 不监督; 按 DeepSpec 约定去服务, 每个槽位都读早一位, 接受长度掉到 1.1 左右, 平移一位后回到 4.05 (speculators issue #753). 同一个「block size」在两种约定下分别对应 与 个草稿, 读接受长度数字之前要先确认是哪一种.
深度, 长度与延迟.
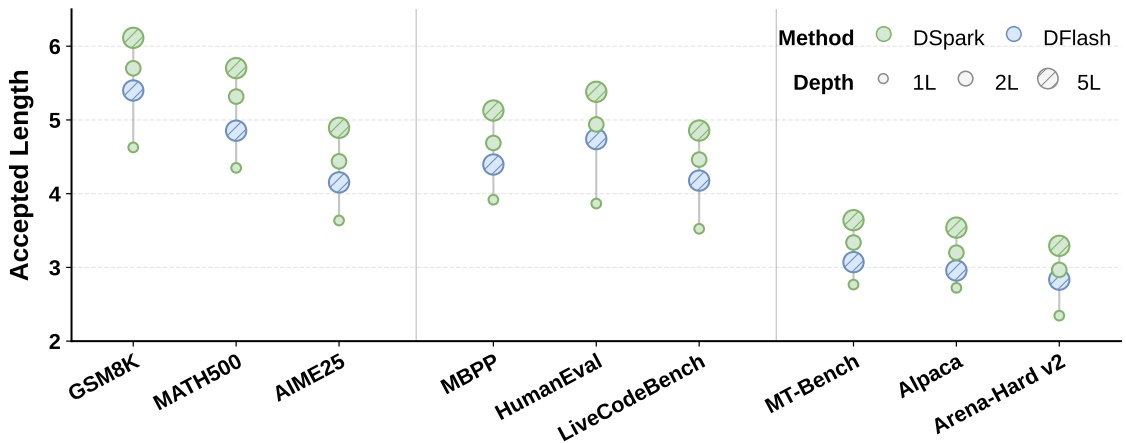
图注: 块大小固定为 7, DSpark 层数从 1 加到 5, 灰色虚线是 5 层 DFlash. 三个领域的接受长度都随层数单调上升, 1 层到 2 层的增量最大; 2 层 DSpark 已经在三个领域都高于 5 层 DFlash. 图 3 解析: 块大小固定为 7, DSpark 层数从 1 加到 5, 灰色虚线是 5 层 DFlash. 三个领域的接受长度都随层数单调上升, 1 层到 2 层的增量最大; 2 层 DSpark 已经在三个领域都高于 5 层 DFlash.
这张图说明顺序头带来的收益和加深主干的收益可以叠加, 并且前者更便宜: 从 DFlash 5 层换到 DSpark 2 层, 主干少了 3 层, 只多了一个秩 256 的偏置表, 接受长度反而更高. 它同时说明 DSpark 位置 1 的优势不能全部归到容量上. 图 2 中 DSpark 与 DFlash 都是 5 层, 位置 1 却差了 0.05 (数学 0.93 对 0.88); 结合 2.1 节, 位置 1 也受顺序头影响, 而且训练目标也不同 (见 2.4 节). 论文没有做「只加顺序头, 其余与 DFlash 完全一致」的消融, 这 0.05 的来源文中没有拆分.
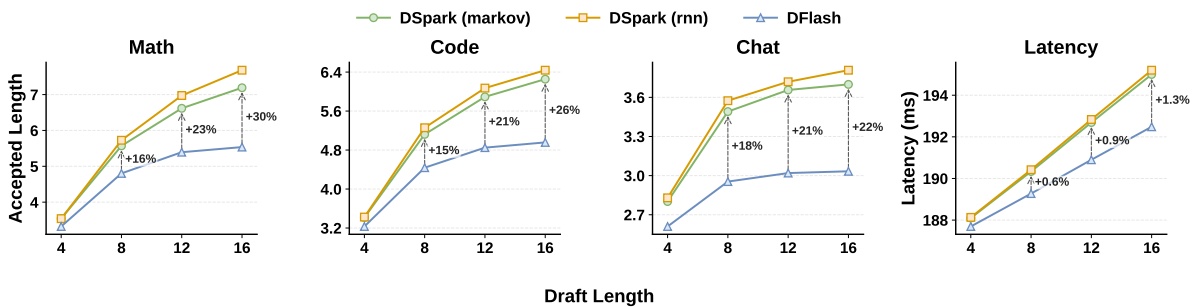
图注: 前三个子图是数学, 代码, 对话在草稿长度 4, 8, 12, 16 下的接受长度, 比较 DFlash, DSpark (Markov head) 与 DSpark (RNN head); 最右子图是 batch 128 下每轮引擎延迟. DSpark 与 DFlash 的差距随长度拉开, 时三个领域分别高 16%, 15%, 18%, 时扩大到 30%, 26%, 22%; 整轮延迟比 DFlash 只多 0.2% 到 1.3%. 图 4 解析: 前三个子图是数学, 代码, 对话在草稿长度 4, 8, 12, 16 下的接受长度, 比较 DFlash, DSpark (Markov head) 与 DSpark (RNN head); 最右子图是 batch 128 下每轮引擎延迟. DSpark 与 DFlash 的差距随长度拉开, 时三个领域分别高 16%, 15%, 18%, 时扩大到 30%, 26%, 22%; 整轮延迟比 DFlash 只多 0.2% 到 1.3%.
的三个百分比可以用表 1 复核. Qwen3-4B 在数学, 代码, 对话三组基准上的 DSpark/DFlash 均值比为 1.160, 1.154, 1.182, 与 16%, 15%, 18% 对得上, 说明图 4 与表 1 用的是同一套评测. 延迟只在 batch 128 下测量, 数值是 512 到 4096 四种上下文长度的算术平均. 此时目标模型的验证前向占主导, 顺序头的 次小矩阵乘被摊薄. 小 batch、低延迟场景中的目标前向更短, 串行采样占比会提高, 但文中没有给出这一区间的数据.
训练目标与代码出入: 训练损失由三项组成: 交叉熵 , 全变差 和置信度头的二元交叉熵 , DeepSpec 配置里的权重是 0.1, 0.9, 1.0. 全变差项直接优化式 (8) 的 , 也就是逐位置接受概率, 交叉熵只占很小权重. 顺序头训练时用 teacher forcing: 前驱 token 取 anchor 加真实目标序列错一位, 与推理时用草稿自己采样的前缀不同. 推理时只有前缀全部被接受的样本才会走到位置 , 这些前缀与目标模型的输出高度重合, 训练与推理的条件差距因此被收窄, 但文中没有给出这部分差距的度量.
位置权重是论文与代码对不上的地方. 3.3 节写 , 衰减常数取块长; DeepSpec 的 Qwen3-4B 配置 block_size=7, 但 loss_decay_gamma=4.0, loss.py 按 加权. 位置 7 的权重因此是 , 按正文写法应为 , 相差近一倍. 发布配置更重视靠前位置, 这与 1.1 节的乘积结构一致, 但论文报告的数字到底用哪个衰减常数训练, 文中没有说明. 其余训练超参与配置文件一致: 每条序列采 512 个 anchor, 5 层草稿, 从目标模型第 1, 9, 17, 25, 33 层取隐状态, 学习率 , 全局 batch 512, 10 个 epoch, 最大长度 4096.
置信度调度怎样给每个请求定验证长度.
1.3. pre-token 置信度与 STS 校准
置信度头的公式是 (式 7). 它的输入是位置 的主干隐状态和上一个 token 的低秩嵌入, 不含 本身, 所以 估计的是「在已知前缀下, 位置 将要采样出的 token 被接受的概率」, 论文称为 pre-token 置信度. 训练标签取式 (8) 的 , 也就是用目标分布与草稿分布的全变差算出的解析接受概率, 不用一次采样的 0/1 结果, 方差更低. 存活概率 是调度器真正用到的量.
只看排序时, 置信度头的区分能力够用: 图 6 里 ROC-AUC 在 0.81 到 0.90. 调度器要的是乘积 的绝对值, 原始输出过度自信, ECE 在 3% 到 8%, 连乘 6 次以后误差会累积. 论文的 STS (顺序温度缩放) 从位置 1 开始逐位置做一维网格搜索, 为每个位置选一个温度, 使累积乘积的 ECE 最小, 位置 的温度在前 个固定后再定. 温度缩放是单调变换, 不改变同一位置上的排序. 校准后平均 ECE 降到约 1%.
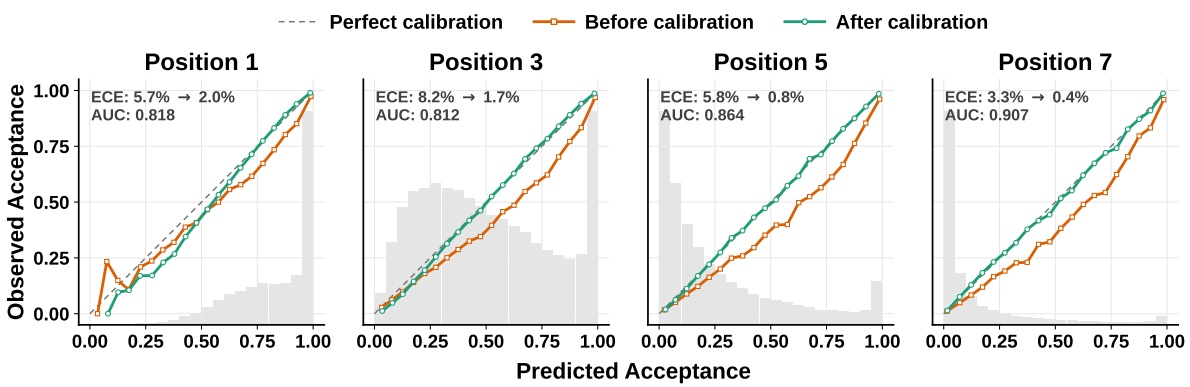
图注: 这是 Alpaca 数据上的可靠性图, 横轴是预测的存活概率分箱, 纵轴是实际存活频率. 原始曲线落在对角线下方, 预测值系统性偏高; STS 之后曲线贴近对角线.
图 6 解析: 这是 Alpaca 数据上的可靠性图, 横轴是预测的存活概率分箱, 纵轴是实际存活频率. 原始曲线落在对角线下方, 预测值系统性偏高; STS 之后曲线贴近对角线. 图中同时标出各位置的 AUC 与 ECE. DeepSpec 仓库的评测部分只有 ECE 与 AUC 的计算, 以及一个静态阈值的早停函数 _confident_prefix_length, 没有 STS 和第 5 节调度器的代码. 也就是说, 离线部分能复现图 5 和图 6 的原始曲线, 校准和线上调度只能按论文描述自行实现.
静态阈值只能做诊断.
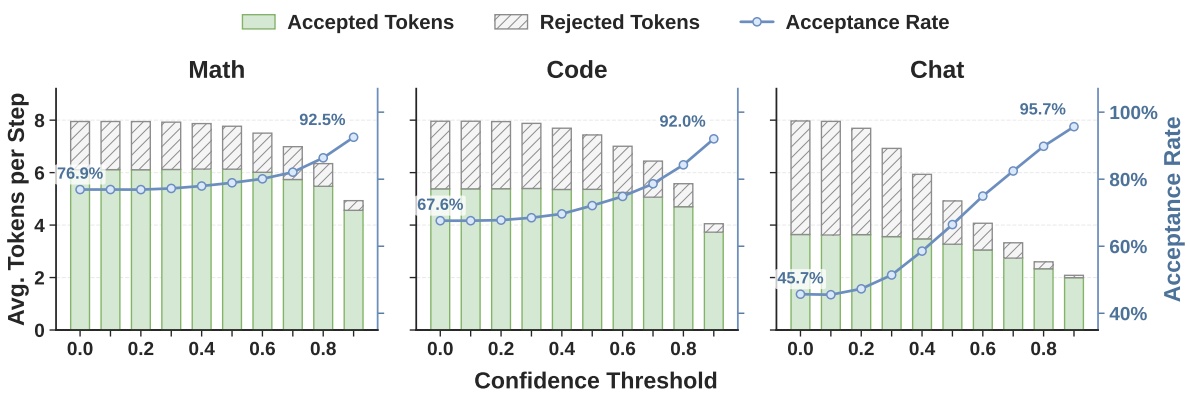
图注: 对 Qwen3-4B 扫置信度阈值, 柱子是每步平均验证 token 数, 斜线部分是其中被拒的, 折线是整体接受率. 阈值从 0 往上调, 对话的接受率从 45.7% 升到 95.7%, 数学从 76.9% 升到 92.5%, 代码从 67.6% 升到 92.0%, 被剪掉的主要是最终会被拒的 token. 图 5 解析: 对 Qwen3-4B 扫置信度阈值, 柱子是每步平均验证 token 数, 斜线部分是其中被拒的, 折线是整体接受率. 阈值从 0 往上调, 对话的接受率从 45.7% 升到 95.7%, 数学从 76.9% 升到 92.5%, 代码从 67.6% 升到 92.0%, 被剪掉的主要是最终会被拒的 token.
这张图验证了置信度头能挑出低价值后缀, 但它也显示静态阈值的问题. 同一个阈值在对话上剪掉大半草稿, 在数学上只剪一小部分; 而该不该剪, 还取决于此刻 GPU 有没有余量. 低并发时多验证几个低置信度 token 几乎不花钱, 剪掉反而损失接受长度; 高并发时同样的 token 会挤占其他请求的 batch 位置. 一个固定阈值无法同时适应这两个区间, 这是 Algorithm 1 引入负载项的原因.
Algorithm 1 的准入门槛: Algorithm 1 把所有请求的候选 按 全局降序排好, 依次尝试接纳. 当前 batch 的验证 token 总数 , 期望接受数 , 系统吞吐 , 其中 是离线测得的「batch 为 时每秒能跑几步」. 接纳一个候选后若 不再上升, 立即 break. 同一请求内 随 单调不增, 全局排序自动保证每个请求接纳的是一个前缀. 把 break 条件展开, 就得到每个 token 的准入门槛. 接纳前为 , 接纳后为 , 继续的条件 等价于
轻负载时 在 附近几乎是平的, 右边接近 0, 几乎所有草稿都进; 进入计算受限区后若 , 右边变成 , 即当前 batch 里平均每个验证 token 换来的期望接受数. 这条式子是论文里没有写出的推导, 只用到 Algorithm 1 的两行更新式, 它把「负载越高, 门槛越高」写成了显式关系: 一个草稿 token 被送去验证, 当且仅当它的存活概率高于 batch 当前的平均产出率. 每个请求的验证长度 因此由全局决定, 它取决于其他请求的置信度和 batch 总大小.
早停, 无损性与生产版改造: break 不只是省计算. 附录 A 的反例说明, 去掉 break 做全局搜索会破坏无损性: 依赖 , 依赖 , 于是 是否被接纳取决于 自己的取值. 在两词表的例子里, 目标分布 (0.7, 0.3), 草稿分布 (0.5, 0.5), 调度器只在 时接纳, 输出分布变成 (0.85, 0.15). 早停版本在 时就停下, 不会看到 .
同一个反例也显示了 break 的代价. 序列 为 1.0, 0.9, 1.134, 先降后升, 早停拿不到情形 1 下 1.134 的解, 吞吐差约 12%. 真实 GPU 的 在 kernel tile 边界处阶梯式下降, 这种先降后升的情况很常见. 5.2 节的生产版做了两处改造: 调度器异步运行, 用两步之前的置信度算出容量上限 , 当前步按最新的 取 top-; 容量搜索去掉 break, 做全局搜索. 因为 只依赖两步之前的信息, 与当前块的 token 无关, 而同一请求里依赖 的后续候选满足 , 排不到 前面, 无法影响自己是否入选. 唯一的缝隙是并列值: 时 , 需要约定位置靠前者优先, 文中没有写明并列的处理.
5.2 节还有一处措辞与内容不符. 原文说去掉 break 是为了防止调度器被锯齿状 SPS 困在「local minima」, 而调度器在最大化 , 被困住的是局部最大值. 另外, 两步延迟让 与当前真实最优容量之间存在偏差, 论文称之为「轻微的时间偏移」, 没有给出这部分偏差造成的吞吐损失.
2. 与 batch 容量, 吞吐的关系
为什么线上吞吐与单用户速度同向: 投机解码通常被看作用算力换延迟: 每次验证 个 token, 被拒的那部分算力白花, 换来单请求更快. 这个取舍在 batch 打满 GPU 算力…6868 tokens truncated…修正模块共享输入、并行输出,训练目标为二分类式损失(对每个位置预测「存活/死亡」),损失函数取交叉熵:
其中 是「该草稿 token 最终是否被 target 验证接受」的标签(可从训练数据中真实跑一遍投机解码获得)。
5. 线上数字的口径与对比基准
尽管 DSpark 在长草稿块上保持高接受率, 验证整个提议仍然低效 (Hu et al., 2026b; Huang et al., 2024). 由于 4.2 节指出的领域差异, 开放式对话的尾部 token 仍面临高拒绝风险, 盲目验证会浪费目标算力. 为评估置信度头能否有效剪掉这些没希望的后缀, 我们用 Qwen3-4B 做离线阈值扫描. 这里单独验证估计器本身, 硬件感知前缀调度器 (3.2.2 节) 留到第 5 节的线上生产评估.
诊断: 静态阈值扫描. 图 5 画出不同置信度阈值下每步平均 token 数 (柱) 与整体接受率 (线). 阈值升高, 接受率稳步上升, 因为估计器滤掉了最终会被拒绝的 token (斜线柱). 这说明置信度头能识别低价值的后缀 token, 这种剪枝在对话负载上最明显: 对话的 token 分布熵更高, 限制了定长验证的效率. 对话子图中, 提高阈值明显减少被拒 token, 接受率从 45.7% 升到 95.7%. 相比之下, 结构化任务 (数学与代码) 剪枝更温和, 保留更多草稿 token, 接受率分别从 76.9% 升到 92.5%, 从 67.6% 升到 92.0%.
从静态阈值到校准调度. 静态阈值适合做诊断, 但在动态服务环境里次优, 因为它忽略系统负载: 低并发下验证低置信度 token 的机会成本很小, 高并发下却浪费关键的 batch 容量. 这种负载依赖促成了硬件感知前缀调度器. 如 3.2 节所述, 最大化系统级吞吐要求置信度模型同时具备强区分能力和精确校准, 才能准确估计累积存活概率. 可靠性图 (图 6) 显示, 原始模型区分能力强 (ROC-AUC (Hanley and McNeil, 1982) 在 0.81 到 0.90 之间), 但过度自信 (ECE 3%-8%). 施加事后 STS (3.2.1 节) 缓解了过度自信, 平均 ECE 降到约 1%, 存活估计变得可靠.
投机解码算法. 投机解码把 token 提议与验证解耦, 加速自回归生成. 在早期分块方法 (Ge et al., 2022; Stern et al., 2018; Sun et al., 2021; Xia et al., 2023) 之上, 现代方法采用拒绝采样精确保持目标模型分布 (Chen et al., 2023; Leviathan et al., 2023). 推理加速直接取决于 drafter 的效率和准确率, 大量研究集中在优化它的架构. 除使用独立的小语言模型 (Chen et al., 2023; Leviathan et al., 2023) 外, 后续工作把多 token 头或特征外推器直接集成进目标模型 (Ankner et al., 2024; Cai et al., 2024, 2025; DeepSeek-AI, 2024; Eldenk et al., 2026; Gloeckle et al., 2024; Li et al., 2024b,c, 2026b; Zhang et al., 2025). 其他策略包括基于提前退出的自投机 (Elhoushi et al., 2024; Liu et al., 2024a; Xia et al., 2025; Zhang et al., 2024), 动态词表压缩 (Williams et al., 2026; Zhao et al., 2025b), prompt lookup (Saxena, 2023; Somasundaram et al., 2025), 后缀自动机 (Hu et al., 2025) 和检索 (He et al., 2023; Shen et al., 2026). 为消除起草本身的串行瓶颈, 一条研究线提出并行或分块生成, 包括 Medusa (Cai et al., 2024), P-EAGLE (Hui et al., 2026), PARD (An et al., 2026a,b), DART (Liu et al., 2026a) 和 DFlash (Chen et al., 2026). DDTree, TAPS 和 JetSpec 又把草稿链扩展成可验证的树 (Hu et al., 2026a; Ringel and Romano, 2026; Wang et al., 2026a). 同期工作包括: Domino (Huang et al., 2026a) 引入的 CausalEncoder 在概念上与我们的 RNN Head 相近; DFlare (Zhang et al., 2026a) 通过逐层融合处理条件化瓶颈.
面向系统的投机解码调度. 在 drafter 架构之外, 另一条研究线关注每轮应生成或验证多少个投机 token. 为此, 多种方法用置信度启发式 (Du et al., 2024; Li et al., 2024b; Liu et al., 2026c; Mamou et al., 2024; Wen and Feng, 2026), 学习的接受预测器 (Huang et al., 2024; Zacks917, 2026) 或 bandit 式策略 (Liu et al., 2026b) 在线调整草稿长度. 进一步地, 一些近期工作认识到投机解码本质上是系统级调度问题, 依据实时系统负载和请求优先级调整投机预算, 优化整体 goodput 与延迟 (AngelSlim Team, 2026; Hu et al., 2026b; Huang et al., 2026b; Li et al., 2026a; Liu et al., 2024c; Miao et al., 2024; Sadhukhan et al., 2025; Wu et al., 2025).
并行生成. 并行生成 token 的模型解码延迟几乎与输出长度无关, 是自回归解码的有吸引力的替代. 非自回归 Transformer (NAT, Gu et al., 2018) 开创了这一方向, 在一次前向里独立预测所有位置. 但这迫使模型对所有合理模式取平均, 输出常常混合来自不同合法序列的片段. 为解决这一局限, 出现了两条大的研究线. 一条保留单次前向架构, 改变模型看到的内容或训练方式: 引入潜变量作为条件输入, 把所有位置引向一致的输出 (Gu et al., 2018; Kaiser et al., 2018; Ma et al., 2019); 或放宽训练目标, 让模型专注产出单个连贯输出, 不去建模所有合法候选上的完整分布 (Du et al., 2021; Qian et al., 2021; Shao et al., 2021, 2023). 另一条通过迭代重预测 (Austin et al., 2021a; Ghazvininejad et al., 2019; Li et al., 2022), 块级自回归 (Arriola et al., 2025; Wang et al., 2018), 或 CRF (Sun et al., 2019), CTC (Libovický and Helcl, 2018; Saharia et al., 2020), HMM (Huang et al., 2022b), PCFG (Gui et al., 2023) 等结构化输出层, 重新引入有限的顺序依赖.
投机解码还提出一个额外要求: drafter 必须为拒绝采样规则提供精确的逐 token 概率. 上述大多数技术由于迭代精修, 潜变量边缘化或全局归一化, 难以直接提供这样的概率. 例如, 与我们设计最接近的 CRF-NAT (Sun et al., 2019) 同样在并行隐状态上加了一个顺序模块, 但它的全局归一化配分函数使精确的逐 token 概率无法计算. 类似地, CTC-drafter (Wen et al., 2024) 把 CTC 输出层用于并行投机解码时, 因对齐路径的潜变量边缘化只能做贪心验证. DSpark 让顺序修正保持局部, 逐 token 概率仍是精确的 softmax 值, 绕开了这些限制.
本文提出 DSpark, 一个面向高并发生产环境, 克服大语言模型推理结构性瓶颈与系统级瓶颈的投机解码框架. 算法上, DSpark 引入半自回归生成范式: 把计算繁重的并行主干与轻量顺序头耦合, 缓解独立并行 drafter 的快速后缀衰减. 系统上, 我们把验证长度选择表述为全局吞吐最大化问题, 用一个硬件感知前缀调度器, 依据校准后的存活概率和实时引擎负载, 动态定制目标模型的验证预算. 大量离线评估表明, DSpark 在多个领域明显超过最先进的自回归与并行基线. 此外, 它在 DeepSeek-V4 内的真实部署验证了其生产服务价值: 通过合理管理验证开销, DSpark 在重负载下维持稳健的并发, 稳定提高单用户生成速度, 把 LLM 服务的 Pareto 前沿向外推.
5.1. Counterexample: Selection Bias Without Early-Stopping · 反例: 没有早停时的选择偏差
我们给出一个简单反例, 说明离线全局搜索 (即 Algorithm 1 去掉 break 条件后的运行方式) 如何破坏无损投机解码所需的非预见性. 形式上, 第 个草稿 token 的接纳事件 必须由 token 采样之前调度器可见的信息决定, 不能依赖 本身的取值. 考虑单个请求 (), 最大草稿长度 的情形. 设第一个位置的 pre-token 置信度为 , 实测容量曲线为
验证 0 个和 1 个草稿 token 的期望吞吐为
没有早停时, 调度器在提交任何接纳决定之前继续评估 . Markov 置信度头使用上一个采样出的 token, 下一个置信度分数 显式依赖 的取值. 因此第二个前缀的存活概率
同样依赖 . 考虑 的两种取值: • 情形 1 ( 给出高 ): 设 使 , 则
长度 2 的期望吞吐为
是 {1.0, 0.9, 1.134} 中的全局最大值, 调度器返回 , 第一个 token 被接纳进验证前缀. > 再算: 这组数里 , 带 break 的 Algorithm 1 在这里会错过什么?
答: 带 break 时, 接纳 后 , 算法立刻停, 返回 ; 情形 1 下 的期望吞吐 1.134 因此拿不到, 损失约 12%. 反例里的 序列先降后升, 不是单峰的, 这正是 5.2 节说的锯齿 SPS 曲线会让早停卡住的情形. 也就是说, 附录 A 同时给出了两件事: break 保住无损, 也带来吞吐损失, 5.2 节用「两步之前的信息定 」把这两件事分开处理. • 情形 2 ( 给出低 ): 设 使 , 则
长度 2 的期望吞吐为
此时全局最大值仍是 , 调度器返回 , 第一个 token 没有被接纳进验证前缀. 于是, 第一个草稿 token 是否被接纳, 动态地依赖这个草稿 token 本身的取值. 这种回溯依赖引入选择偏差: 调度器偏好那些引出高置信度后续的 token, 而 的接纳决定本应在观察 之前做出. 下面把分布偏差写明. 设词表为 , 第一个位置的目标分布与草稿分布为
第一个位置的标准投机接受概率为
与假设值 一致. 设回溯式调度器的行为如上: 给出高后续置信度, 因而 ; 给出低后续置信度, 因而 . 第一个输出 token 的分布如下. 若 , 草稿 token 被接纳, 接受概率为
所以输出 token 是 . 若 , 草稿 token 不被接纳, 目标模型直接从 重新生成一个 token. 因此
从而
这个输出分布 (0.85, 0.15) 与目标分布 (0.7, 0.3) 不同, 证明回溯式调度器不是无损的. 在因果贪心调度器里, 早停机制避免了这个问题. 由于 , 调度器在评估 这类依赖后续的量之前就立即停止并返回 . 第一个位置的接纳决定因此只依赖 pre-token 信息, 不会被 的取值带偏. 这恢复了标准无损性论证所需的非预见性.
线上数字的口径与对比基准: DSpark 在 DeepSeek 推理路线中的位置
DeepSeek 早期的推理加速路线以 MTP 为代表:主模型在训练时增加多个预测头,让一次隐藏状态同时预测未来若干 token。它的优势是预测头与主模型联合训练,隐藏表示天然服务于多 token 预测;代价是要改动主模型训练,而且并行头之间仍缺少真实采样前缀。EAGLE 系列把草稿器独立出来,利用目标模型特征自回归生成候选,条件依赖完整,却让草稿成本随长度增长。DFlash 再把草稿改成并行块,利用更深的草稿网络换取一次前向,随后暴露出块内多模态碰撞。DSpark 接在这条线上:主干继续并行,只把最便宜的一阶 token 依赖恢复到输出头,再用置信度决定验证前缀。
这条演进不能简单理解成后一种方法全面替代前一种。MTP 适合在预训练阶段已经布置多 token 目标的模型;独立 drafter 适合给既有目标模型追加加速器;自回归 drafter 在小 batch 和短候选下可能更有优势;并行 drafter 的收益依赖验证前向能够有效摊薄草稿和采样开销。DSpark 的论文数据支持的是一组特定目标模型、GPU 和服务负载下的组合优势,并没有证明 Markov head 对所有语言模型分布都足够。
5.2. 怎样把组件收益拆开
DSpark 的最终吞吐同时受到四个变量影响:草稿主干深度、顺序头、置信度校准和动态调度。接受长度的提升主要检验前两项,固定 batch 下的平均验证宽度检验后两项,线上吞吐还混入内核实现、请求长度分布与批处理策略。若只比较完整系统,无法判断某个数字来自算法还是部署条件。
最小消融应保持目标模型、训练 token、草稿深度和候选上限不变,依次比较 DFlash、仅加 Markov head、再加置信度头、最终启用调度器。顺序头需要报告逐位置条件接受率;置信度头需要报告 AUC、ECE 和存活概率误差;调度器需要同时报告接受 token、验证 token、目标前向耗时和调度空闲槽。这样才能把“候选更准”和“少验证低价值位置”分开。
论文已经给出其中多数切面,但训练目标也发生了变化,发布配置里的位置衰减常数又与正文公式不同。因此图 2 中位置一的增益不能全部归因于块内依赖,图 7 的线上增益也不能全部归因于调度算法。可靠的结论应落在可直接复核的层面:低秩 Markov 偏置提高了长块的条件接受率,校准后的置信度能把有限验证槽优先分给高存活概率前缀,两者在公开实验的高并发设置中共同降低了单位输出 token 的延迟。
图 7 上的三种比较.
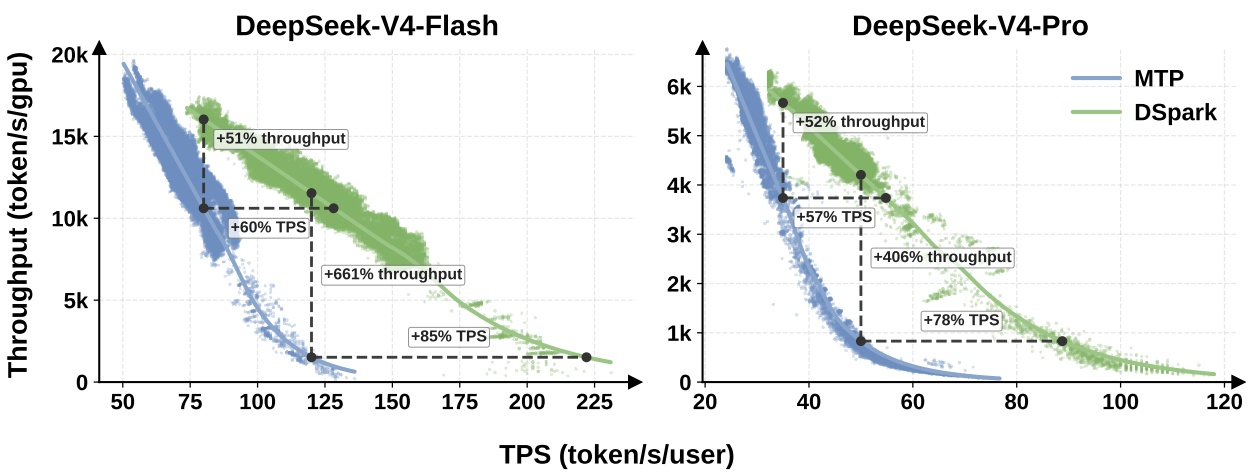
图注: 横轴是单用户生成速度 (tok/s/user), 纵轴是总输出吞吐, 散点是线上遥测, 实线是拟合的前沿. V4-Flash 在 80 tok/s/user 的 SLA 下 DSpark 吞吐高 51%, 在 120 下名义上高 661%; V4-Pro 在 35 下高 52%, 在 50 下名义上高 406%. 图 7 解析: 横轴是单用户生成速度 (tok/s/user), 纵轴是总输出吞吐, 散点是线上遥测, 实线是拟合的前沿. V4-Flash 在 80 tok/s/user 的 SLA 下 DSpark 吞吐高 51%, 在 120 下名义上高 661%; V4-Pro 在 35 下高 52%, 在 50 下名义上高 406%. 在相同总吞吐下, DSpark 的单用户速度在 V4-Flash 上快 60% 到 85%, 在 V4-Pro 上快 57% 到 78%.
这几组数字是在同一张图上沿不同方向切出来的. 51% 与 661% 是画竖线, 固定单用户速度比总吞吐; 60% 到 85% 是画横线, 固定总吞吐比单用户速度. 在 120 tok/s/user 这条竖线上, MTP-1 的前沿已经贴近横轴, 分母很小, 比值才到 7.6 倍. 论文自己也把 661% 与 406% 定性为「扩展了可行前沿」的证据, 不当作代表性倍数; 能用来估算收益的是中等 SLA 下的 51%/52% 和相同吞吐下的速度提升.
比较对象与可分离性: 线上对比只有 MTP-1 一个基线. 这组对比同时换了两样东西: 草稿模型从单层 MTP 变成 3 层 MoE 的半自回归 drafter, 验证长度从固定 1 变成调度器动态决定. 论文没有给出「DSpark 草稿加固定长度」或「MTP 加调度器」的线上点, 51% 里有多少来自草稿质量, 有多少来自调度, 无法从图 7 拆开. 散点来自真实流量, 不同时间段的请求分布不同, 拟合前沿也并非同流量的 A/B 测试, 文中没有给出拟合方法和误差带.
社区的数字可以部分补上草稿质量这一项. vLLM PR #46995 在 V4-Pro 上 (thinking 开, temperature 1) 按草稿长度对比 DSpark 与 MTP 的平均接受长度: 草稿长度 1 时 1.82 对 1.86, MTP 略好; 长度 3 时 2.86 对 2.55; 长度 6 时 3.42 对 2.60. 同一 PR 里有人在 2 张 H100 上跑 V4-Flash-DSpark () 的真实流量, 平均接受长度 3.86, 各位置无条件接受率 82%, 67%, 55%, 45%, 37%. 由此算出的条件接受率依次约为 0.82, 0.82, 0.82, 0.82, 0.82, 块内基本持平, 与图 2 中 DSpark 曲线的形状一致; , 与报告的接受长度对得上. 这说明在长度 1 时 DSpark 草稿并不比 MTP 强, 收益来自长块上不衰减, 而长块能否用上, 又取决于调度器.
和 MTP, EAGLE, Medusa 比较的依据: 离线对比的基准是 Eagle3 与 DFlash, 依据是表 1 的接受长度. 这里的 Eagle3 只有 1 层, DFlash 与 DSpark 都是 5 层, 比较的是「各自的典型配置」, 不是等参数或等草稿 FLOPs. 论文的论点本来就是自回归 drafter 受 串行成本所限用不了深网络, 所以这个设置符合它要论证的东西, 但读者不能把 30% 的差距理解成同等算力下的架构差. EAGLE 系列与 DFlash 的机制见 EAGLE 系列深度解析 与 DFlash 原理解析.
Medusa 只出现在相关工作里, 没有实验对比. 按结构看, Medusa 的多个头各自独立预测, 属于 DFlash 一侧的纯并行方案, 而且没有 KV 注入的深主干, 按 1.2 节的分析, 它同时面对位置 1 容量不足和后缀衰减两个问题, 但文中没有给出数字. MTP 的对比只在线上做, 且只对 MTP-1; MTP-3/5 被排除的理由是高并发下吞吐下降, 论文没有给出 MTP-3/5 配合同一调度器的结果. 离线评测全部关闭调度器, 用固定长度块, 结论只针对草稿质量; 调度器的收益只有线上数据支撑.
存疑之处汇总: 按论文章节整理, 以下几处结论的证据不足或与代码不一致.
- 3.3 节: 位置权重写作 , DeepSpec 发布配置用 , 块长为 7, 文中没有说明报告数字用的是哪个.
- 4.3.1 节: 「位置 1 容量差」的解释在 Gemma4-12B 上不成立 (Eagle3 4.376 高于 DFlash 4.018), DSpark 与 DFlash 同为 5 层而位置 1 差 0.05, 来源没有消融.
- 4.3.2 节: 延迟开销只在 batch 128 下测量并对四个上下文长度取平均, 小 batch 区间没有数字; Eagle3 1 层对 5 层, 不是等算力比较.
- 5.2 节: 「local minima」应为局部最大; 两步延迟带来的容量偏差没有量化; top- 因果性论证没有处理并列值.
- 5.4 节: 线上只对比 MTP-1, 草稿与调度的贡献无法分离; 661%/406% 是前沿贴近横轴时的名义比值; 前沿为拟合曲线, 没有方差或置信区间.
这些问题不影响论文的主线结论: 半自回归顺序头以很小的串行成本缓解了并行草稿的后缀衰减, 负载感知的验证长度让长草稿块在高并发服务里变得可用. 它们影响的是数字的可迁移性, 在别的目标模型, 别的并发区间, 别的基线下复现时, 上面几项都要单独测.