材料是论文 Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures (arXiv 2505.09343, 2025-05, ISCA 2025 工业论文, 15 页), 作者为 DeepSeek-AI 的 Chenggang Zhao, Wenfeng Liang 等 15 人. 论文没有新模型, 讲的是 DeepSeek-V3 在 2048 张 H800 上训练与部署时碰到的硬件约束, 以及模型和集群为此做的协同设计. 文中提到的代码都已开源: EP 通信库 DeepEP, FP8 GEMM 库 DeepGEMM, MLA decode kernel FlashMLA, 存储网络上的文件系统 3FS. 逐段对照见 对照译稿.
论文把硬件建议落在一组可复核的数字上: MLA 每 token 的 KV cache 是 70.272 KB, 一次 EP 往返是 120.96 μs, H800 的 Tensor Core 累加只保留 13 位尾数, NVLink 对 IB 是 4:1, 训练时 132 个 SM 里有 20 个在搬数据. 这些数字的成立条件来自 V3 技术报告公开的模型参数: 61 层, 隐藏维 7168, 128 个注意力头, MLA 潜变量 512 维加 64 维 RoPE, 每层 1 个共享专家和 256 个路由专家, 每个专家中间维 2048, 每 token 激活 8 个路由专家. 硬件或模型配置变化后, 对应的字节数、通信时间与瓶颈判断也要重新计算.
1. 内存与算力: 每 token 要搬多少字节, 算多少 FLOPs
1.1. KV cache 表: 576 个数乘 61 层
表 1 的三个数都能从模型配置直接乘出来, 单位里的 KB 取 1000 字节. V3 的 MLA 每层每 token 只缓存 512 维的压缩潜变量和 64 维的解耦 RoPE key, 共 576 个数, BF16 存放是 1152 字节, 乘 61 层得 70,272 字节. Qwen2.5-72B 是 GQA, 8 个 KV 头, 头维 128, 80 层, K 与 V 各一份: 字节. LLaMA-3.1-405B 同样 8 个 KV 头, 126 层, 得 516,096 字节. 表里的倍数 4.66 和 7.28 就是这三个数之比.
| 模型 | 注意力 | 每层每 token 缓存的数 | 层数 | 每 token 字节 (BF16) | 128K 上下文合计 |
|---|---|---|---|---|---|
| DeepSeek-V3 | MLA | 576 | 61 | 70,272 | 9.2 GB |
| Qwen2.5-72B | GQA, 8 KV 头 | 2048 | 80 | 327,680 | 42.9 GB |
| LLaMA-3.1-405B | GQA, 8 KV 头 | 2048 | 126 | 516,096 | 67.6 GB |
| V3 结构改用 MHA | 128 头 | 32,768 | 61 | 3,997,696 | 524 GB |
末尾一行是表 1 没有的对照: 如果 V3 保持 128 个头, 每头 128 维, 却用标准 MHA 缓存 K 和 V, 每 token 要约 4.0 MB, 是 MLA 的 56.9 倍. 这才是 MLA 相对「同等头数」的压缩比. 表 1 拿两个 GQA 模型比, 4.66 倍里混着层数的差别 (80 层对 61 层), 按每层算, Qwen2.5-72B 是 V3 的 倍. 另一个口径差在精度上: 论文按 BF16 算, 而 FlashMLA 的 FP8 KV 布局每层每 token 是 656 字节 (512 维 FP8 潜变量, 4 个 FP32 缩放因子, 64 维 BF16 的 RoPE 部分), 61 层合计约 40 KB. 实际部署的 KV 体积比表 1 再小约 43%. KV 容量的一般算法见 KV 缓存: 容量计算, 调度与压缩边界.
1.2. decode 的访存瓶颈: MLA 改变的是算术强度
2.1.2 节说 KV cache 让 decode 的计算从 GEMM 变成 GEMV, 计算访存比太低, 带宽成了瓶颈. 这句话对 GQA 成立, 对 MLA 只成立一半, 论文没有展开这一层. 拿每个缓存 token 在一层里引发的 FLOPs 除以它的字节数, 就是注意力部分的算术强度. Qwen2.5-72B 有 64 个 query 头共享 8 个 KV 头, 一个缓存 token 的 K 和 V 各被 8 个 query 头用一次, 打分与加权各 2 FLOPs 每元素, 合计 FLOPs, 对应 4096 字节, 强度是 8 FLOP/字节. LLaMA-3.1-405B 有 128 个 query 头, 强度是 16.
MLA 在推理时用矩阵吸收, 把 128 个头的 query 都投到 576 维潜变量空间里直接和缓存打分, 再在 512 维上加权. 一个缓存 token 每层引发 FLOPs, 字节是 1152, 强度约 242 FLOP/字节. H800 的稠密 BF16 峰值约 989 TFLOPS, HBM 带宽 3.35 TB/s, 屋顶线拐点约 295 FLOP/字节. 也就是说, MLA 的 decode 注意力已经接近计算受限, GQA 模型还差 20 到 40 倍. 这个差别解释了 FlashMLA 为什么要做 FP8 KV 和计算访存的流水重叠: 字节数下来以后, kernel 的瓶颈从 HBM 移到了 Tensor Core, 优化重点随之改变. 以上强度是按模型结构推出的, 论文只给了 KV 字节数, 没有给出强度.
1.3. 表 2 的 FLOPs 口径与「少一个数量级」
表 2 的单位写成 GFLOPS/Token, 实际含义是训练一个 token 的前向加反向运算量 (GFLOP), 与「每秒」无关. 口径可以用表 4 反推: MPFT 一列每天 272.80B token, 合每秒约 token; 2048 张卡每卡 385 TFLOPS (causal 口径), 两数相除得每 token 约 249.7 GFLOP, 正好是表 2 的 250. 从结构正算也能得到这个数: 线性层的前向加反向是 GFLOP; MLA 在 4K 序列下的打分与加权按下三角计, 每 token 每层前向约 FLOPs, 乘 3 (前向加反向) 再乘 61 层约 30.7 GFLOP; 合计约 253. V2 一行同样算: , 加注意力约 30, 得约 156, 表中是 155.
两个稠密模型那两行的口径不完全一致. LLaMA-3.1-405B 光线性层就有 GFLOP, 加上注意力约 2448, 合理. Qwen2.5-72B 的非嵌入参数约 70B, 线性层 GFLOP, 已经高于表中的 394, 这一行用了什么参数量论文没有交代. 于是 2.2.1 节「少一个数量级的计算资源」只对 405B 那一行成立 (2448 对 250, 约 9.8 倍); 对 72B 那一行, V3 每 token 的训练计算只少约 37%, 按 420 算也只少约 40%. MoE 的收益在这里要分开看: 和 72B 稠密模型相比, V3 用相近的每 token 计算换来近 10 倍的总参数; 和 405B 相比, 才是同等规模下省一个数量级.
2. EP 通信与 decode 速度的上限
2.1. 120.96 μs 是哪几个数乘出来的
2.3.2 节的推算设定每张卡放一个专家, 一次处理 32 个 token, 每个 token 要发给 8 个路由专家和 1 个共享专家. dispatch 用 FP8 (1 字节), combine 用 BF16 (2 字节), 隐藏维取 7K, 网卡带宽取 400Gbps 即 50 GB/s:
只有把 7K 取成 7000 才得到 120.96; 取 V3 真实的 7168, 一轮是 123.86 μs. FP8 dispatch 实际还要带每 128 个元素一个 4 字节的缩放因子, DeepEP 的 low-latency 消息每 token 7408 字节, 比 7168 多 3.3%. 按 4.3 节自己用的 40 GB/s 有效带宽, 一轮是 154.8 μs. 公式里的 已经把 dispatch 和 combine 两趟都算进去了, 后面「每层 」里的 2 来自双 micro-batch: 两个 micro-batch 各要做一轮 dispatch 加 combine, 计算被假设完全藏在通信下面, 一层的墙钟时间就是两轮通信之和. 61 层合计 14.76 ms, 约 67.8 token/s.
这个数可以和 DeepEP 公开的 low-latency 实测对照. DeepEP 文档给的 EP64 一行是每卡 128 个 token, 8 个路由专家, dispatch 173 μs, 由此换算的带宽约 43.9 GB/s. 把 token 数缩到 32, 按同样的有效带宽, dispatch 约 43 μs (每副本 7408 字节), combine 约 84 μs (每副本 14336 字节), 合计约 127 μs. 论文的 120.96 μs 用 9 个副本, 50 GB/s 线速; 实测口径是 8 个副本, 43.9 GB/s. 两个口径的误差互相抵消了一部分, 结果只差约 5%, 说明这个理论上限离实测并不远. MoE 的 all-to-all 字节数一般推导见 MoE 专家并行与 All-to-All 通信.
2.2. 换成 NVL72 以后: 0.82 ms 省略了什么
把带宽从 50 GB/s 换成 GB200 NVL72 的 900 GB/s, 通信时间按比例缩到 6.72 μs ( 正好等于 ), TPOT 变成 0.82 ms, 约 1220 token/s. 论文自己提醒这个数没有考虑小 batch 下 GPU 效率的下降. 还有两处它没有提. 第一, NVL72 只有 72 张 GPU, V3 每层有 257 个专家, 「每卡一个专家」放不下. 每卡放约 4 个专家时, 如果每个专家仍处理 32 个 token, 每卡收发的字节约为原来的 4 倍, 一轮约 27 μs, TPOT 约 3.3 ms; 如果每卡总共仍是 32 个 token, 每个专家只分到约 8 个 token, 专家 GEMM 更加访存受限.
第二, 通信缩短以后, 读专家权重的时间会冒出来. V3 一个路由专家的参数是 M, FP8 存放 44 MB. 每一层每个 micro-batch 都要把这 44 MB 从 HBM 读一遍, 在 H800 的 3.35 TB/s 下是 13.1 μs, 在 8 TB/s 的 HBM3e 上是 5.5 μs. 50 GB/s 网络下, 13.1 μs 远小于 120.96 μs, 通信确实是瓶颈; 900 GB/s 网络下, 6.72 μs 已经和读权重的时间相当. 双 micro-batch 各读一遍权重, 只算专家部分, 61 层在 H800 级 HBM 上就要约 1.6 ms, 在 8 TB/s 上约 0.67 ms, 和 0.82 ms 同一量级, 还没算 MLA 读 KV 的时间. 所以 1200 token/s 是网络单项的上限, 换成 NVL72 以后, 系统的上限由 HBM 带宽和每卡专家数共同决定. 这组数是按 V3 公开配置和 HBM 规格推出的, 论文没有给出.
2.3. 本地部署: 20 TPS 对应多少内存带宽
2.2.2 节说装 AI SoC 的 PC 跑 V2 能接近 20 TPS, KTransformers 在一台约 1 万美元, 配消费级 GPU 的服务器上跑完整的 V3 也接近 20 TPS. 单用户 decode 时 batch 为 1, 每生成一个 token 都要把激活的权重读一遍, 速度上限近似为「内存带宽 / 每 token 读的字节」. V2 每 token 激活 21B 参数, 20 TPS 在 8 位量化下要 420 GB/s, 在 4 位下要 210 GB/s. 论文没有给出量化精度和具体芯片, 但这个带宽要求说明 20 TPS 对应的是 4 位左右的量化, 以及 200 GB/s 以上的统一内存带宽.
V3 在 KTransformers 上的情形可以拆开算. KTransformers 把注意力, 共享专家和稠密层放在 GPU 上, 路由专家放在 CPU 内存里由 CPU 计算. 每 token 要读的路由专家权重是 8 个专家乘 58 个 MoE 层乘 44.0M, 约 20.4B 参数; 4 位量化时每 token 约 10.2 GB, 20 TPS 要求 CPU 内存带宽约 204 GB/s. 这落在双路服务器 DDR5 的能力范围里 (双路 24 通道 DDR5-4800 的理论值约 920 GB/s, 实际可用约一半到三分之二). 稠密模型就没有这条路: 70B 稠密模型 4 位量化每 token 要读 35 GB, 同样的 200 GB/s 只有约 6 TPS, 与论文「个位数 TPS」的说法一致. 本地部署的瓶颈是内存带宽, 不是算力, MoE 的激活参数比直接决定了 TPS.
2.4. MTP 的 1.8 倍
2.3.3 节给出的线上数据是: 一个 MTP 模块预测第二个 token 的接受率在 80% 到 90%, 生成 TPS 提高到 1.8 倍. 只用一个 MTP 模块时, 每个解码步产出 个 token, 是接受率, 期望值在 1.8 到 1.9 之间. 1.8 倍落在这个区间的下沿, 说明验证带来的额外开销 (多一层 MTP 前向, batch 变大后 EP 通信和计算的增量) 不大. V3 技术报告给的接受率是 85% 到 90%, 也是 1.8 倍 TPS; 这里把下限放宽到 80%, 原因论文没有给出.
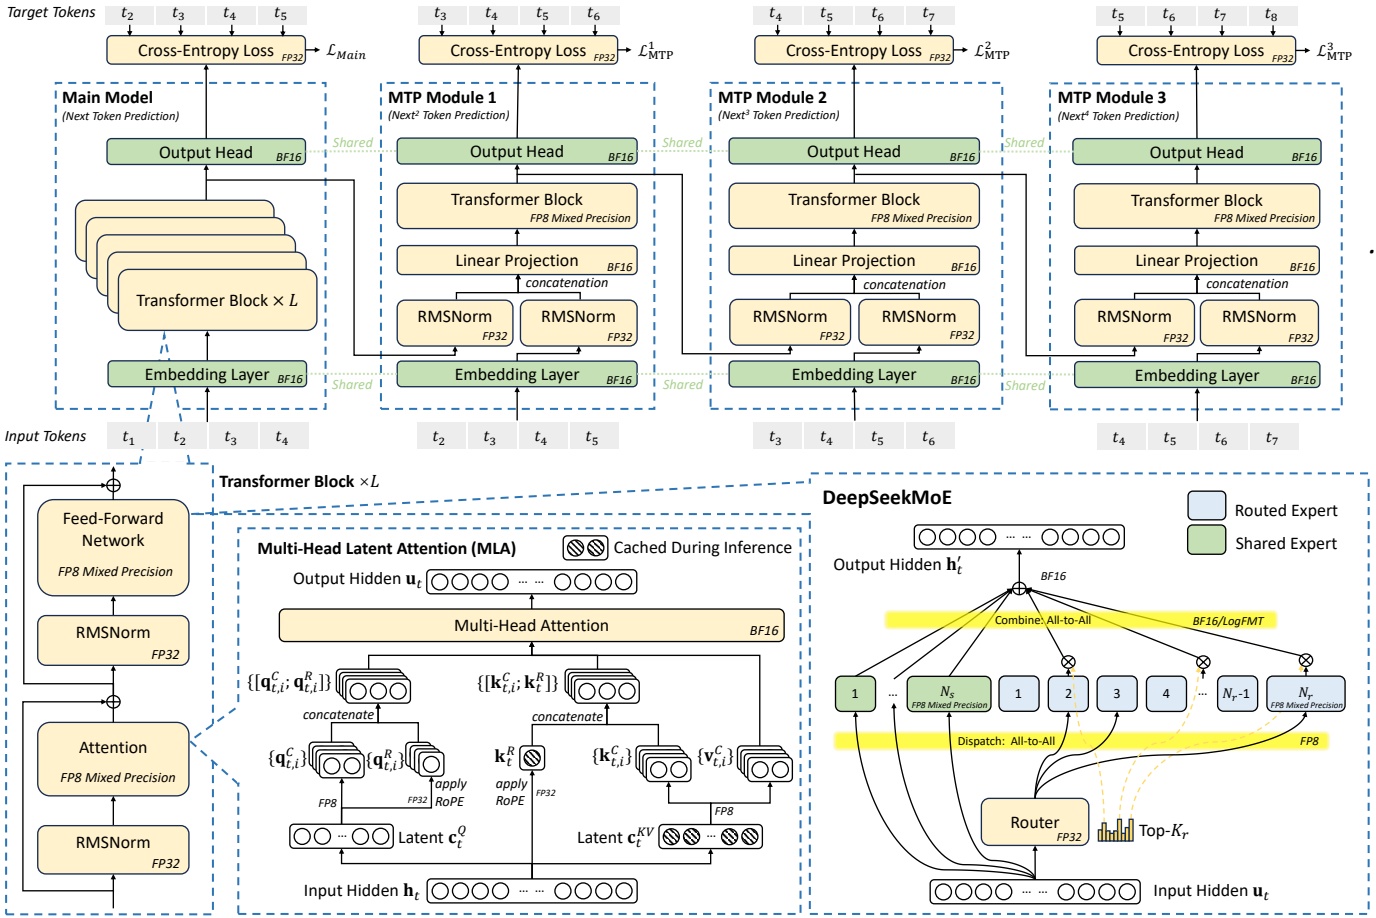
图 1: DeepSeek-V3 的整体结构, 上半是主模型与 MTP 模块的串接, 下半是 MLA 与 DeepSeekMoE 的内部, 并标出路由打分, dispatch, combine 各段的数值精度, 原文 Figure 1.
图 1 解析: 图的上半部分画了主模型加 3 个 MTP 模块, 但 V3 训练和部署都只用 1 个 MTP 模块 (技术报告的 ), 图是把技术报告的整体架构图和 MTP 示意图拼在一起的. 右下的 DeepSeekMoE 部分标了各段精度: 路由打分用 FP32, dispatch 用 FP8, combine 标成「BF16/LogFMT」, 而 3.2.1 节明确说 LogFMT 最终没有采用. 读这张图时, 精度标注要以正文为准. MTP 第二个作用是增大 decode 的有效 batch: 每步多验证一个 token, 每个专家收到的 token 数近似翻倍, 前面分析的专家 GEMM 访存受限会因此缓解一些.
3. 低精度: FP8 训练的两处硬件短板与 LogFMT
3.1. FP22 累加器: 13 位尾数在长 K 上丢多少
V3 线性层的三个 GEMM (前向, 对输入求梯度, 对权重求梯度) 都以 FP8 E4M3 为输入, 训练框架的细节见 V3 解析 第 2.2 节, 一般做法见 FP8 混合精度训练详解. 3.1.1 节把 Hopper 的第一个问题落在累加器上. 一条 FP8 WGMMA 沿 K 方向处理 32 个元素: Tensor Core 先算出 32 个尾数乘积, 按其中最大的指数把其余乘积右移对齐, 只保留最高 13 个小数位相加, 超出的位直接截断, 结果累加进 1 位符号, 8 位指数, 13 位尾数的寄存器, 论文沿用被引工作 (SageAttention2) 的叫法记为 FP22. V3 技术报告写的是「约 14 位」, 差在是否计入规格化数的隐含位, 两份材料描述的是同一个硬件行为, 代码侧的对应见 DeepGEMM 解析 第 2.1 节.
13 位截断对长 K 的影响可以粗算. 截断总是朝零的方向, 误差不会正负抵消; 每往累加器里加一批乘积, 相对误差最多 . 时一共累加 次, 最坏累积到 , 与 V3 技术报告实测的「最大相对误差接近 2%」同一量级. 文中没有给出误差模型, 这个数是按截断误差线性累积推出的上界. V3 的办法是每 128 个 K 元素 (4 条 WGMMA) 就把部分和取到 CUDA Core 的 FP32 寄存器里, Tensor Core 内部最多连续累加 4 次, 每段的截断误差上界降到 , 段与段之间在 FP32 里相加. 2.4 节报告的结果是: 在 16B 与 230B 两个 DeepSeek-V2 规模上做 FP8 消融, 相对 BF16 的差距低于 0.25%. 这里写的是 relative accuracy loss, V3 技术报告附录 B.1 对同一组实验写的是相对 loss 误差, 指的是训练 loss 而不是下游准确率.
3.1.2 节的第一条建议由此而来: 累加寄存器提到 FP32, 或者让累加精度可配置, 训练用高精度, 推理按需要降低. 软件提升的代价不在 FLOPs 上, 在寄存器和指令发射上: 每个线程要多持有一组 FP32 累加器, warpgroup 每处理完一个 K 块就要停下来做一次搬运. 这一步还顺带承担了反量化, 开销在下一节算.
3.2. 细粒度量化的反量化开销与 microscaling
V3 的量化粒度是激活按 的 tile (一个 token 的 128 个通道) 共享一个缩放因子, 权重按 的 block 共享一个. 粒度细, 离群值只影响自己所在的组; 代价是缩放因子沿 K 方向每 128 个元素就变一次, 而 Hopper 的 Tensor Core 不接收这些因子. 每个 K 块的部分和都要先送出 Tensor Core, 在 CUDA Core 上乘以 ( 是激活 tile 的缩放因子, 是权重 block 的缩放因子), 再加进 FP32 累加器. DeepGEMM 里这一步是 final_accum += scale_a * scale_b * accum (DeepGEMM 解析 第 2.2 节), 反量化和 3.1 节的精度提升合在同一个点上.
这一步的开销可以按峰值估. 对输出矩阵的每个元素, 一个 128 长的 K 块在 Tensor Core 上是 FLOP; 在 CUDA Core 上是一次乘法加一次乘加, 约 3 FLOP. H800 的 FP8 稠密峰值约 1979 TFLOPS, FP32 CUDA Core 峰值约 67 TFLOPS, 两段耗时之比约 . 也就是说, 反量化如果与矩阵乘串行执行, 要多花约三分之一的时间. V3 技术报告的办法是两个 warpgroup 交替, 一个做提升时另一个继续发 WGMMA, 把这三分之一藏到矩阵乘后面; 前提是寄存器装得下两组累加器, 这也限制了 tile 形状的选择. 这个比例按规格峰值推出, 论文只给了定性的说法: 频繁的数据搬运降低计算效率, 也让硬件利用变复杂.
第二条建议是让 Tensor Core 直接接收缩放因子, 在内部完成分组缩放和部分和累加, 只输出最终结果. 论文举的例子是 Blackwell 的 microscaling (MX) 格式: 每 32 个元素共享一个 8 位纯指数 (E8M0) 的缩放因子, 由 Tensor Core 在乘加时应用. V3 的 与 都能写成 MX 的特例, 把一个缩放因子复制给相邻 4 个 32 元素子块即可, 条件是因子取 2 的整数次幂. DeepGEMM 后来支持的 UE8M0 缩放因子格式就是为了对齐这一条 (DeepGEMM 解析 第 3.1 节), MX 与 NVFP4 的格式细节见 MXFP4 与 NVFP4. 原生分组缩放消掉的是反量化的搬运, 累加器位宽是另一个问题, 所以论文把两条建议分开写.
3.3. LogFMT 的编码与精度
3.2 节讨论的是 EP 通信两半的精度差. dispatch 已经用细粒度 FP8, 比 BF16 少一半字节; combine 出于精度要求留在 BF16. 论文在 combine 上试过 FP8, E5M6 和 FP8/BF16 混合, 另外提出 LogFMT-Bit. 编码以一个 的 tile 为单位: 先对每个元素取 , 求出最小值 与最大值 ; 1 位符号之外的 位中, 全 0 表示零, 码值 1 对应 , 码值 对应 , 中间等距, 步长为
码值 解码为 . 另有两条约束. 一是 , 一个 tile 内最大最小绝对值之比不超过 , 与 5 位指数的浮点格式相当. 二是舍入在线性域做, 不在对数域做. 原因是 是凸函数: 两个相邻码值解码后为 , 对数域就近舍入的分界点是几何平均 , 低于线性域的算术平均 , 落在两者之间的值在对数域会被舍向 , 解码后幅值系统性偏大, 线性域舍入才是无偏的.
精度可以和浮点格式放到同一个量上比: 相邻两个可…6 tokens truncated…现有硬件上「省 SM」与「省 IB 字节」不能兼得.
4.4.2 节的四条建议都在拆这个取舍. 统一网卡 (或 I/O die) 同时接 scale-up 与 scale-out 两张网, 带基本的交换功能, 能用一个 LID 或 IP 加策略路由把 scale-out 进来的包直接投到 scale-up 域内的某张 GPU; 专用通信协处理器从 SM 手里接过包处理, 提供硬件显存拷贝和类似 TMA 的 load/store 加速; 硬件支持跨两张网的转发, 广播 (对应 dispatch) 和归约 (对应 combine); 硬件同步原语处理乱序到达和内存一致性, 替代 RDMA 完成事件. 第一条和第三条合起来, 就是让 4.2 节的去重由硬件完成: 网卡收到一份 token, 按目标位图复制给本节点的几张卡, 不占 SM. 论文提到的 UEC, UALink 与 UB 是这个方向上的协议. 软件侧也在压 SM 用量, DeepEP V2 的 README 写的是 V3 式训练的通信 SM 从 24 个降到 4 到 6 个 (DeepEP 解析 第 4.4 节), 用的仍是现有硬件.
4.4. PCIe 争用与 CPU 侧的带宽
4.5.1 节的例子是推理时从 CPU 内存往 GPU 搬 KV cache, 每秒几十 GB, 与此同时 GPU 还在经 IB 做 EP 通信, 两者争用导致性能下降和延迟尖刺. 对照图 2 可以算出为什么会撞上: GPU 到 PCIe switch 是一条 PCIe 5.0 x16, 单向约 63 GB/s; GPUDirect RDMA 下网卡收发的数据也经这条链路进出显存, 网卡跑满是 50 GB/s, 再加 20 GB/s 的 KV cache 拷贝就超过上限. 用户态程序无法给这两类流量设优先级, EP 通信的尾延迟随之抬高. 这组数按 PCIe 5.0 与 400Gbps 网卡的规格推出, 论文没有给出实测的争用数据.
建议分三层. 最小的改动是把 PCIe 的流量类别 (traffic class) 暴露给用户态, 让 EP, TP 与 KV cache 传输按类型设优先级, NVLink 上同理. 再进一步是把网卡做进 I/O die, 与计算 die 同封装, 不再经过 PCIe. 最彻底的是 CPU 与 GPU 之间也用 NVLink 一类的专用高带宽互连, 让 CPU 进入 scale-up 域, Grace Hopper 的 NVLink-C2C 是现成的实现. 6.2 节补充了 CPU 侧的约束: 跑满 160 条 PCIe 5.0 通道需要每节点超过 640 GB/s 的数据供给, 对应约 1 TB/s 的内存带宽, 常规 DRAM 配置很难做到; kernel 启动和网络处理这类延迟敏感任务要求单核基频在 4 GHz 以上. 640 GB/s 按每通道单向约 4 GB/s 取整, 从 640 GB/s 到 1 TB/s 的系数文中没有给出推导; 若按 DRAM 实际可用带宽约为理论值的 60% 到 70% 计, 640 GB/s 对应约 0.9 到 1.1 TB/s 的理论带宽, 与 1 TB/s 相符.
5. 网络: 多平面胖树, RoCE 与内存语义通信
5.1. MPFT 的拓扑与表 3 的成本
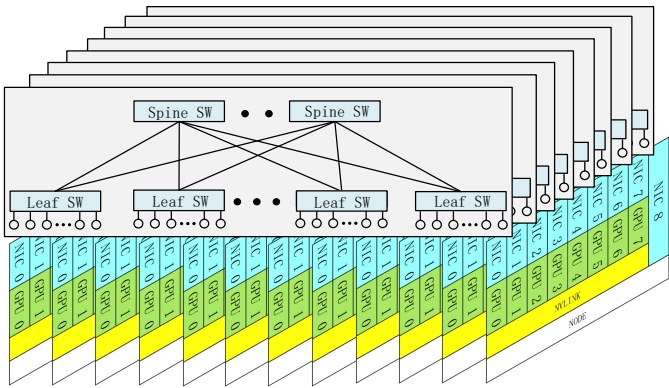
图 3: 八平面两层胖树, 每个节点的第 张 GPU 与第 块网卡属于第 个平面, 每个平面是一张独立的 leaf-spine 两层胖树, 跨平面流量要经节点内的 PCIe 或 NVLink 转发, 原文 Figure 3.
图 3 解析: 八个平面之间没有交换机相连, 一张卡经网络只能直接到达其他节点的同号卡. 发往异号卡的数据要先在源节点内经 NVLink 交给与目标同号的卡, 或到目标节点内再转发, NCCL 的 PXN 与 DeepEP 的 normal kernel 做的就是这件事. 每个平面画的是同一种两层结构, 规模由交换机端口数决定. 存储用的 RoCE 网卡和 3FS 存储网络不在图内.
V3 训练集群的 scale-out 网络就是图 3 的多平面胖树 (MPFT): 每节点 8 张 GPU 与 8 块 IB 网卡, 每对 GPU 与网卡属于一个平面; 另有 1 块 400Gbps 的 RoCE 网卡接独立的存储平面, 访问 3FS. 交换机是 64 口 400G IB. 端口数为 的两层胖树, leaf 一半端口下联, 一半上联, 最多接 个端点, 需要 台 leaf 与 台 spine 共 台交换机, leaf 与 spine 之间 条链路. 时是 2048 个端点, 96 台交换机, 2048 条链路, 正是表 3 的 FT2 一列; 8 个平面各是一张 FT2, 合起来 16,384 个端点, 即论文说的理论上限 16,384 张 GPU. 三层胖树最多 个端点, 台交换机, 两级交换机之间共 131,072 条链路. 表 3 的链路数只算交换机之间, 不含端点到 leaf 的那一段.
| 拓扑 | 端点 | 交换机 | 链路 | 成本 (百万美元) | 每端点 (千美元) |
|---|---|---|---|---|---|
| FT2 | 2,048 | 96 | 2,048 | 9 | 4.39 |
| MPFT | 16,384 | 768 | 16,384 | 72 | 4.39 |
| FT3 | 65,536 | 5,120 | 131,072 | 491 | 7.5 |
| SF (Slim Fly) | 32,928 | 1,568 | 32,928 | 146 | 4.4 |
| DF (Dragonfly) | 261,632 | 16,352 | 384,272 | 1,522 | 5.8 |
表 3 没有给单价, 只说按 Slim Fly 论文的方法估算. 用 FT2 与 FT3 两列联立, 解得每台交换机约 8.3 万美元, 每条链路约 500 美元; 代回 SF 一列得约 147, 与表中 146 一致, DF 一列得约 1551, 比表中 1522 高 2%. 读这张表要注意三点. 第一, MPFT 的每端点成本与 FT2 完全相同, 因为它就是 8 张 FT2 并列; 它相对 FT3 便宜约 41%, 换来的是平面之间不互通, 两张异号卡之间没有直达的网络路径, 要靠节点内转发补上. 第二, 相对 Slim Fly 的优势只有 4.39 对 4.43, 约 1%, 在单价取整的误差之内, 5.1.1 节的措辞也只是「略有竞争力」. 第三, V3 实际只部署了两千多张卡, 每个平面约 256 个端点, 8 台 leaf 加 4 台 spine 就能组成无阻塞的两层网, 8 个平面共 96 台交换机, 与一张 2048 端点的 FT2 一样多. 在这个规模上, MPFT, 单平面 FT2 与多轨胖树用的交换机数相同, 成本优势要到超过 2048 张卡以后才出现. 后两点按胖树公式推出, 文中没有给出 V3 集群实际的交换机数.
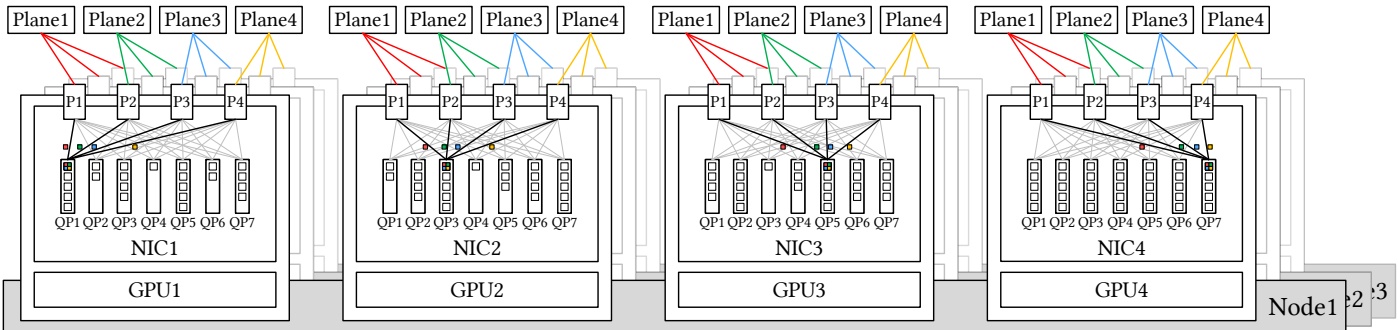
图 4: 理想的多平面网络, 每块网卡有多个物理端口, 各接一个平面, 一个 QP 可以同时用所有端口收发, 网卡需要原生支持乱序放置, 原文 Figure 4.
图 4 解析: 图中每块网卡有 P1 到 P4 四个端口, 分别连 Plane1 到 Plane4, 网卡内的 QP1 到 QP7 都能经任一端口发包. 与图 3 相比, 平面的划分从「每张 GPU 一个平面」变成「每个端口一个平面」, 一张 GPU 不经节点内转发就能到达所有平面. 同一个 QP 的包走不同平面, 到达顺序会乱, 接收端网卡必须按地址直接放置. 图里没有画平面内的交换机, 每个平面仍是一张两层胖树.
论文承认部署的 MPFT 没有达到图 4 的形态: CX7 一块网卡只接一个平面, 跨平面必须节点内转发, 推理时这会增加延迟. 图 4 要求一块网卡的多个物理端口经端口绑定呈现为一个逻辑接口, 一个 QP 的包在各端口上喷洒, 接收端原生支持乱序放置; 论文提到 CX8 已原生支持 4 个平面. 5.1.1 节列出的好处里, 单端口故障不断连这一条要靠多端口网卡才成立. 在 CX7 上, 一块网卡的上联断了, 对应的 GPU 只能借其他平面的网卡走节点内转发.
5.2. MPFT 与 MRFT 的实测对照
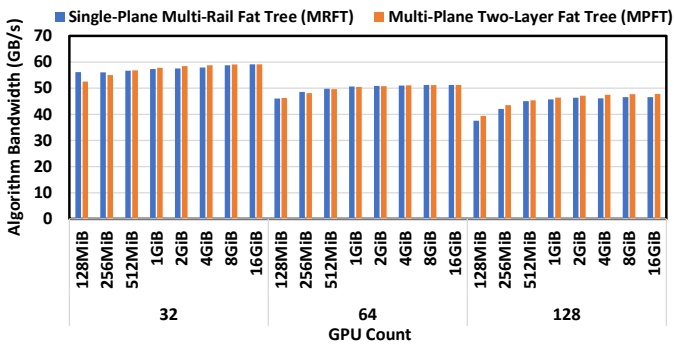
图 5: MRFT 与 MPFT 两种网络上 NCCL all-to-all 的算法带宽, 横轴是 32, 64, 128 张 GPU 下从 128MiB 到 16GiB 的消息大小, 原文 Figure 5.
图 5 解析: 两种拓扑的柱子几乎重合, 只在 32 卡, 128MiB 时 MPFT 低约 3 GB/s. 大消息下的平台值是 32 卡约 59, 64 卡约 51, 128 卡约 47 GB/s, 32 卡的读数超过了单块网卡 50 GB/s 的线速. 这组数可以用一个参数拟合: all-to-all 发往本节点其余 7 张卡的数据走 NVLink, 跨节点的份额是 ; 设跨节点部分以每卡 的速度发送, 算法带宽约为 . 取 GB/s, 时分别是 58.7, 50.3, 46.9 GB/s, 与图中读数吻合. 也就是说网卡的有效速度约 44 GB/s, 为线速的 88%, 两种拓扑在这一点上没有差别. 拟合按读图所得, 文中没有给出 NVLink 份额的拆分.
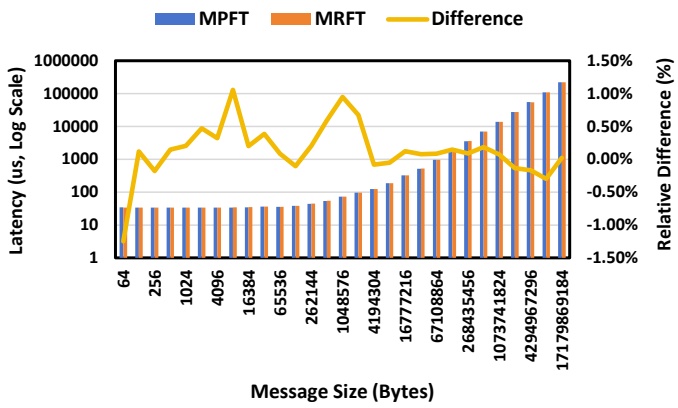
图 6: 16 张 GPU 上 NCCL all-to-all 的延迟随消息大小的变化, 柱为 MPFT 与 MRFT 的延迟 (对数轴), 折线为两者的相对差, 原文 Figure 6.
图 6 解析: 消息从 64 字节到 16GiB, 相对差在约 -1.2% 到 +1.1% 之间摆动, 没有固定方向, 属于测量波动. 小消息一端的延迟在 30 μs 量级, 主要是 NCCL all-to-all 的软件与同步开销, 远大于表 5 里几微秒的链路延迟. 16 张卡只有 2 个节点, 规模远小于训练的 2048 卡, 图 6 只能说明这个规模下两种拓扑没有可测的延迟差.
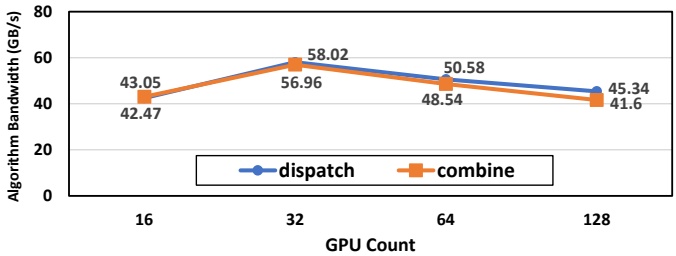
图 7: MPFT 上 DeepEP 的 dispatch 与 combine 带宽, 16 到 128 张 GPU, 每卡 4096 个 token, 原文 Figure 7.
图 7 解析: 16, 32, 64 卡三个点 (43.05/42.47, 58.02/56.96, 50.58/48.54 GB/s) 与 DeepEP V1 README 里 normal kernel 表的数字相同, 128 卡的 45.34/41.6 是新增的点. DeepEP 测试脚本报的是逻辑带宽, 本节点那一份也计入 RDMA 字节 (DeepEP 解析 第 4.1 节), 所以 32 卡能超过线速, 32 到 128 卡的下降与图 5 同一个原因. 测试脚本的组限制是 , 只有 64 卡那个点对应 V3 的 4 节点限制, 32 卡等于不加限制. 16 卡反而低于 32 卡, 文中没有给出原因. 图注说「几乎跑满 400Gbps 网卡」, 按 128 卡的 45.34 GB/s 算约为线速的 91%.
表 4 是 2048 张卡上训练 V3 的对比. MPFT 每天 272.80B token, MRFT 272.52B, 差 0.1%; 每步 19.926 s 对 19.946 s; 时间分解里前向 1F, 对输入的反向 1B, 对权重的反向 1W 都相同, 1F1B 段 13.95 对 14.00 s, 流水气泡 2.06 对 2.03 s. 论文把差别归为正常波动. 表里的数能对回 V3 的训练配置: 每步 token 数 M, 正好是 batch 15360 乘序列长 4096. MFU 按 BF16 峰值算, TFLOPS, 即 H800 的 BF16 稠密峰值, 而实际矩阵乘用的是 FP8, 所以这个 MFU 偏保守. causal 口径只算注意力矩阵的下三角, 385 TFLOPS, MFU 38.94%; non-causal 算整个矩阵, 432 TFLOPS, MFU 43.73%. 时间分解各项相加是 19.90 s, 与 19.926 s 差 0.03 s, 文中没有说差在哪一项.
这组对照能支持的结论有边界. MRFT 指单平面多轨胖树: 8 块网卡在同一张网里, 同号网卡接同一组 leaf. 2048 卡的规模下单平面也只要两层, 表 4 比的是两种两层网络, 没有三层胖树参与. 5.1.1 节「两层拓扑比三层胖树延迟低, 我们的实验证明了这一点」在图 5, 图 6 与表 4 里都找不到三层的数据. 实验能支持的是: 在 V3 的训练负载和这个规模下, 平面之间不互通没有带来可测的吞吐损失, 因为跨平面的流量本来就由 PXN 和 DeepEP 的节点内转发处理.
5.3. IB 与 RoCE: 延迟, 端口数与路由
| 链路层 | 同一 leaf | 跨 leaf |
|---|---|---|
| RoCE | 3.6 μs | 5.6 μs |
| InfiniBand | 2.8 μs | 3.7 μs |
| NVLink | 3.33 μs | - |
表 5 是三种链路的端到端延迟. 5.2 节的出发点是 2.3.2 节的 120.96 μs: 数据传输本身只有百微秒量级, 几微秒的链路延迟占比就不能忽略. decode 每层有 dispatch 和 combine 两次 all-to-all, 双 micro-batch 下共 4 次, 61 层共 244 次; 按 IB 跨 leaf 的 3.7 μs 算约 0.9 ms, 占 14.76 ms 的 6%; 换成 RoCE 跨 leaf 的 5.6 μs 是约 1.4 ms, 占 9%. 表 5 没有给出测法 (消息大小, 是否含软件栈), NVLink 的 3.33 μs 比同 leaf 的 IB 还高, 说明这一行的测法与 RDMA 写的单程延迟不同, 文中没有交代.
IB 的两个问题是价格和端口数. IB 交换机通常 64 口, RoCE 交换机常见 128 口. 按 5.1 节的公式, 128 口的两层胖树能接 个端点, 是 64 口的 4 倍, 8 个平面合计 65,536 个, 与 64 口三层胖树的上限相同. 规模上 RoCE 占优, 延迟上吃亏: 多一跳交换机, IB 多 0.9 μs, RoCE 多 2.0 μs. 5.2.2 节的第一条建议因此是做去掉多余以太网功能, 专为 RDMA 优化的低延迟 RoCE 交换机, 论文举了 Slingshot 和 Broadcom 的 AI Forwarding Header 作为例子.
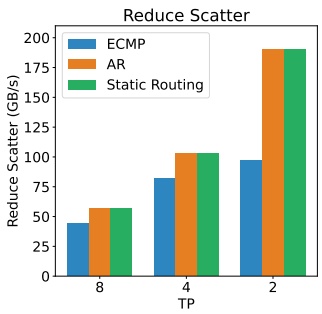
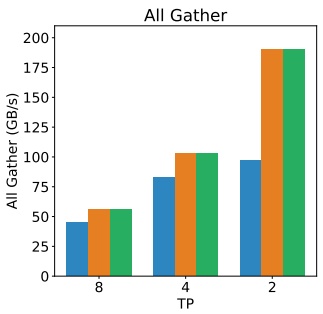
图 8: RoCE 网络上 ReduceScatter (第一张) 与 AllGather (第二张) 的带宽, 比较 ECMP, 自适应路由 (AR) 与静态路由三种策略在 TP 为 8, 4, 2 时的结果, 原文 Figure 8.
图 8 解析: 两种原语的读数几乎一样. TP 为 8, 4, 2 时, ECMP 约 45, 83, 97 GB/s, AR 与静态路由约 57, 103, 190 GB/s, ECMP 分别损失约 21%, 19%, 49%. 带宽随 TP 变小而升高, TP=2 时的 190 GB/s 超过一块 400G 网卡的线速, 纵轴应是按某种逻辑数据量计算的, 测试拓扑和带宽口径文中都没有给出. 静态路由与 AR 持平, 因为集合通信的源和目的固定, 路由表可以事先排开冲突.
ECMP 按包头哈希选路径, 流少而每条流大时, 几条流容易哈希到同一条链路上. LLM 训练的流量正是这样, DP 的集合通信在固定的卡对之间传大块数据, 缺少随机性. AR 按实时拥塞逐包选路径; 静态路由靠手工配置的路由表避开冲突, 对集合通信有效, 对目的地随路由结果变化的 EP all-to-all 就排不开, 所以论文认为大规模 all-to-all 要靠 AR. 第三条建议针对混合负载: RoCE 交换机的优先级队列有限, EP 的 all-to-all 是突发的多对一传输, 会造成 incast, 拖累同时进行的 DP all-reduce. 论文给的办法是虚拟输出队列 (VOQ, 每个 QP 一个虚拟队列), 或改用基于 RTT 的拥塞控制与用户可编程拥塞控制. 同一团队在 Fire-Flyer 2 的 IB 网络上走过另一条路 (该文第 2.2 至 2.3 节): 用 Virtual Lane 隔离四类流量, 关掉 DCQCN, 存储流量改回静态路由并在应用层限流.
5.2.3 节的 IBGDA 处理的是控制面延迟. 传统路径里 GPU 准备好数据后通知 CPU 代理线程, 由 CPU 填写 work request 并敲网卡门铃; IBGDA 让 GPU 线程直接填 work request, 直接写门铃的 MMIO 地址. decode 一次 dispatch 每卡要发约 1024 条 7.4 KB 的消息 (128 个 token 乘 8 个专家), CPU 代理串行提交跟不上, GPU 的多线程可以并行提交. DeepEP 的 low-latency kernel 建立在 IBGDA 上, 实现见 DeepEP 解析 第 3.2 节. 论文据此主张各类加速器都支持这种由 GPU 发起的网络通信.
5.4. 内存语义的顺序问题与网内计算
6.4 节讨论的是跨节点 load/store 通信的顺序. 接收方要知道数据什么时候到齐, 现在的做法是发送方写完数据后发一个内存屏障 (fence), 再更新一个标志通知接收方. 屏障要等之前所有写的完成确认, 多出一个 RTT, 发出屏障的线程在这段时间停住, 后续的写也发不出去. 消息语义的 RDMA 有同样的问题: 开启 packet spraying 后, RDMA 写之后的原子加可能先于数据到达, 也要多等一个 RTT. 按表 5, IB 跨 leaf 的 RTT 约 7.4 μs, 是 120.96 μs 的 6%; 每层 4 次 all-to-all 各多一个 RTT, 与 5.3 节的链路延迟同一量级. 这个 RTT 的实测值文中没有给出.
论文给了两个硬件方案. 一是接收方缓存原子消息, 按包序号 (PSN) 排序后再处理, 实现简单. 二是基于地址区间的 acquire/release (RAR): 接收方硬件为内存区间维护位图或计数器, 记录区间内的写是否全部落地, acquire 与 release 的作用范围限定在指定地址区间, 发送方不再需要显式屏障. 两种方案都能放在网卡或 I/O die 上, 对内存语义和消息语义的 RDMA 都适用. 这与 4.4.2 节第 4 条建议是同一件事, 也是图 4 多平面喷洒能落地的前提: 包可以乱序走, 顺序由接收端硬件保证.
6.5 节把 EP 的两个阶段对应到网内计算: dispatch 是小范围多播, 一条消息发给多个目标; combine 是小范围归约. 收益要按方向算. 负载均衡时, all-to-all 中每块网卡的发送字节与接收字节相等. 交换机做多播, 发送方每个 token 只发一份, 发送字节最多降到 1/8, 每个目标仍要收到自己那份, 接收字节不变; 交换机做归约则相反. 链路是全双工的, 单独做 dispatch 时耗时由接收一侧决定, 只省发送带宽并不缩短时间. 收益出现在双 micro-batch 下: 一个 micro-batch 的 dispatch 与另一个的 combine 同时在网上, 两个方向的字节可以互补. 按每 token 每元素的字节计 (dispatch 1 字节, combine 2 字节, 8 个专家副本), 不做网内计算时两个方向都是 ; 多播加归约后, 发送一侧是 , 接收一侧是 , 耗时由 17 决定, 约省 29%. 另一种用法是多播只在节点入口交一份, 再由 scale-up 网分发, 即 4.2 节去重的硬件版本. 这组分析按全双工链路推出, 论文只说多播与归约能大幅降低通信开销, 没有给出量化.
combine 的网内归约更难做. 论文的理由是 EP combine 的归约范围小, 负载不均. 一个 token 的 8 份专家输出来自至多 4 个节点 (训练时), 到达每个交换机端口时能合并的份数不确定, 与 DP all-reduce 那种所有端点同形状, 同时到达的归约不同. 6.5 节最终把 LogFMT 也放进网络硬件, 由网卡或交换机原生压缩解压, 提高每比特的信息量. 这与 3.4 节的结论一致: LogFMT 的字节收益要靠专用硬件做编解码才能兑现.
参考文献
- Chenggang Zhao 等, Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures, ISCA 2025. arXiv 2505.09343
- DeepSeek-AI, DeepSeek-V3 Technical Report. arXiv 2412.19437
- DeepSeek-AI, Day 6: One More Thing, DeepSeek-V3/R1 Inference System Overview, 2025-02. GitHub open-infra-index
- deepseek-ai/DeepEP, 其中 10 位 LogFMT combine 的提交 c5facf5; deepseek-ai/DeepGEMM; deepseek-ai/FlashMLA; deepseek-ai/3FS
- Jintao Zhang 等, SageAttention2: Efficient Attention with Thorough Outlier Smoothing and Per-thread INT4 Quantization. arXiv 2411.10958
- PyTorch 团队, Some Matrix Multiplication Engines Are Not As Accurate As We Thought. PyTorch Blog
- Bita Darvish Rouhani 等, Microscaling Data Formats for Deep Learning. arXiv 2310.10537
- 同库: DeepSeek-V3 解析, DeepSeek-V4 解析, DeepEP 解析, DeepGEMM 解析, Fire-Flyer 2 解析, 对照译稿