来源: 论文 Fire-Flyer AI-HPC: A Cost-Effective Software-Hardware Co-Design for Deep Learning (arXiv 2408.14158, v2 发布于 2024-08-31, 收录于 SC24), 作者单位 DeepSeek-AI, 系统由幻方 (High-Flyer) 建设和运维. 相关开源代码有两个: 文件系统 deepseek-ai/3FS 和调度平台 HFAiLab/hai-platform. HFReduce 与 HaiScale 没有开源, 因而只能依据论文分析其实现与性能. 3FS 的代码层面另见 3FS 仓库解析, 论文逐段译文见 Fire-Flyer AI-HPC 对照译稿.
1. 成本口径与节点设计
1.1. 「一半成本, 八成性能」分别出自哪张表
摘要里的「成本减半, 能耗降 40%, 性能接近 DGX-A100」其实拼接了三种口径. 性能出自 Table II 的单卡 GEMM: TF32 是 107 对 131 TFLOPS, FP16 是 220 对 263 TFLOPS, 两者之比分别为 81.7% 和 83.7%, 表中统一记为 Relative Performance 83%. 正文 III-C 和结论里写的「80%」是对 83% 的取整. 这个 83% 只反映 PCIe 卡与 SXM 卡在功耗墙和频率上的差距, 没有包含互连. DGX-A100 的 NVSwitch 让 8 卡全互连, PCIe 方案在通信密集的负载上差距会大于 17%, 论文没有给出端到端训练吞吐的对比, 也没有给出 MFU.
成本有两个数. Table II 的 Node Relative Price 是 60%, 只比较单台服务器. Table III 是整集群的相对价格 (单位文中没有给出): 我们的方案网络 350, 服务器 11250, 合计 11600; DGX 方案网络 4000, 服务器 19000, 合计 23000. , 这才是「成本减半」的来源. 服务器一项 , 与 Table II 的 60% 一致. 按 10,000 卡对应 1,250 台节点反推, Table III 的单位相当于每台 PCIe 节点 9 个单位, 每台 DGX 15.2 个单位. 也就是说「一半」里有约 10 个百分点来自网络: DGX 方案的网络占总价 17.4%, Fire-Flyer 2 只占 3.0%.
Table II 末尾一行 Cost-Performance Ratio 1.38 等于 , 是单卡 GEMM 性能除以单节点价格. 如果改用整集群价格 50.4% 去除, 得到约 1.65, 论文没有用这个更高的数. 两个比值都没有计入 PCIe 方案为补通信短板而投入的软件研发成本. VIII-C1 对此只说「几十名自研开发人员的成本只占数千台 GPU 服务器的一小部分」, 没有给出金额.
1.2. 单网卡八卡节点与 PCIe 拓扑
Fire-Flyer 2 的计算节点 (Table I) 配 2 颗 32 核 EPYC Rome/Milan, 512GB 16 通道 DDR4-3200, 8 张 PCIe A100-40GB, 只有 1 张 200Gbps CX6 IB 网卡. 对照的 DGX-A100 配 2 颗 64 核 EPYC 7742, 2048GB 内存和 9 张 CX6 网卡. 两者差得最多的是网卡数量: DGX 每张 GPU 独享 200Gbps, Fire-Flyer 2 是 8 张 GPU 共享 200Gbps, 每卡平均只有 25Gbps. 论文 III-A 的理由是幻方当时的训练负载 (多为参数量 1B 以下的模型, Figure 3) 存储 IO 和通信加起来一张网卡就够.
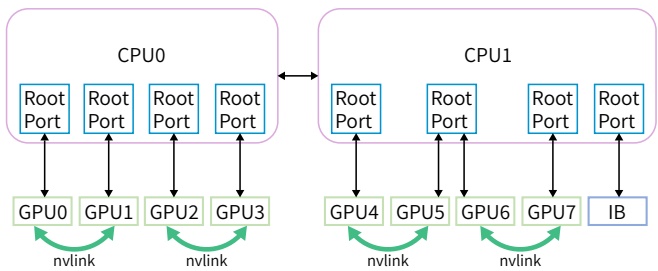
图 1: Fire-Flyer 2 计算节点内部结构, 8 张 PCIe A100 与 1 张 IB 网卡直连两颗 CPU 的 root port, 成对 GPU 之间加装 NVLink Bridge, 原文 Figure 4.
图 1 解析: 这是论文 Figure 4 的节点内部结构. GPU0 到 GPU3 挂在 CPU0 的 4 个 root port 上, GPU4 到 GPU7 和 IB 网卡挂在 CPU1 上, 没有 PCIe switch. 其中 GPU5 和 GPU6 共用一个 root port, IB 网卡独占一个. 绿色弧线是后加的 NVLink Bridge, 只连 (0,1), (2,3), (4,5), (6,7) 四对. 这张图决定了后面三件事: CPU0 侧的 4 张 GPU 访问网卡要跨插槽, 所以 VI-A3 要让 NCCL 只走同一 NUMA 的 GPU 和网卡; GPU5/6 共享 root port, 是 IV-D3 里 HFReduce 跑不满的直接原因; 每颗 CPU 下恰好 4 张 GPU, 对应 GDRCopy 一次读主机内存写 4 张卡的优化.
不使用 PCIe switch 意味着 GPU 之间的 P2P 都要经过 CPU 的 root complex. IV-D2 给出 Rome 不支持 chained write, GPU 到网卡的 P2P 带宽只有约 9 GiB/s. 这一硬件事实决定了 HFReduce 绕开 GPU 直连网卡的路径, 让数据先进主机内存.
1.3. 功耗与运营成本的口径
Table II 的功耗是 2500W 对 4200W, , 即摘要里的「能耗降 40%」. VIII-C2 补充这是 ResNet 训练期间的平均功耗, 也就是单节点在一种负载下的实测值, 没有覆盖 LLM 训练. 对整集群, VIII-C2 只说总功耗不超过 4 MW, 约 3 MW 出头. 用 1,250 台节点乘 2500W 得 3.125 MW, 已经占满「3 MW 出头」的大部分. 180 台存储节点和 122 台交换机的功耗文中没有给出, 按常见的单台几百瓦到 1kW 估, 合计在 0.1 到 0.3 MW, 总量落在 3.2 到 3.5 MW, 与「不超过 4 MW」相容.
运营成本 VIII-C3 只给了算法: 功耗乘机柜租金, 再乘节点数和 PUE. 论文没有给出任何一个具体数值. 所以论文能直接支撑的成本结论只有两条: 整集群采购价约为 DGX 方案的一半 (Table III), 单节点 ResNet 训练功耗约为 DGX 的六成 (Table II).
2. 两区两层 Fat-Tree 与存算共网
2.1. 122 台交换机怎么数出来
III-B 选择 Fat-Tree 而非 Dragonfly, 理由是存算共网需要足够的二分带宽. 选 IB 而非 RoCE, 理由是建设时 RoCE 还不成熟. 交换机是 40 口 200Gbps 的 QM8700. 两层 Fat-Tree 用 20 台 spine 和 40 台 leaf, 每台 leaf 20 口上联, 20 口下联, 40 台 leaf 共 800 个下联端口, 即论文说的「800-port Fat-Tree」. 1,250 台 GPU 节点加近 200 台存储服务器超过了 800, 于是论文做了两个完整的两层 Fat-Tree (Zone A 和 Zone B), 再用少量交换机连起来.
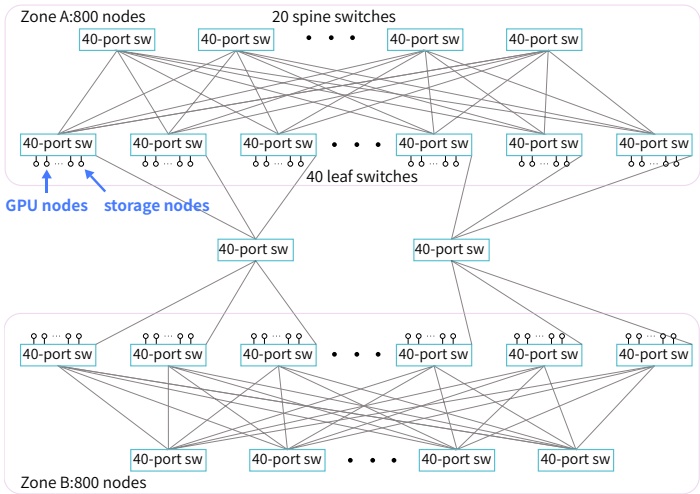
图 2: 两个完整的两层 Fat-Tree (Zone A 与 Zone B) 经两台区间交换机相连, 存储节点双网卡分别接入两区, 原文 Figure 5.
图 2 解析: 这是论文 Figure 5. 上下两个区各有 20 台 spine 和 40 台 leaf, 中间两台 40 口交换机各连两区的一部分 leaf. , 与 Table III 的 Number of Switches 一致. 每台 leaf 下同时挂 GPU 节点和存储节点, 这是 VI-A2「把存储, 计算, 管理节点均匀分布到各 leaf」的物理形态. 每台存储服务器两张网卡分别进两个区, 所以两区的 GPU 节点读的是同一套 3FS.
两区的端口余量很紧. 每区约 600 台 GPU 节点 (III-B), 再加 180 台存储节点各一个端口 (Table IV 与 VI-B2 的数字), 约 780 个端口, 与 800 的上限只差 20 左右, 还要接管理节点和连区间交换机. 正文说「近 200 台存储服务器」, 若真是 200 台, 每区就是 800 个端口, 一个都不剩. 论文没有给出每区的精确端口分配. 对照方案的数字是: DGX 集群要 10,000 个接入点的三层 Fat-Tree, 320 core 加 500 spine 加 500 leaf 共 1,320 台; 规模相当的 PCIe 三层 Fat-Tree 要 1,600 个接入点, 40 core 加 160 spine/leaf 共 200 台 (III-C). 网络价格 350 对 600, 节省 41.7%, 正文取整为「40%」.
跨区代价由调度承担. 区间只有两台交换机, 带宽远低于区内. HAI Platform 保证同一时刻最多一个跨区任务, 而且 NCCL 和 HFReduce 都用双二叉树, 只有一对节点在区间通信 (III-B). 在双二叉树里, 两个区各自形成子树, 子树的根之间只需要一条连接, 区间流量就被压到一对节点的带宽. Figure 7b 把跨区测试单独画出, 128 到 1024 卡的跨区带宽为 9.27, 8.63, 8.06, 7.75 GB/s, 区内为 10.3, 9.66, 8.56, 7.99 GB/s, 跨区与区内之比依次为 90.0%, 89.3%, 94.2%, 97.0%, 损失在一成上下, 卡数越多差距越小, 说明这种布局对 allreduce 的损失不大. 对 all-to-all 一类需要全互连的通信, 论文没有给出跨区数据.
2.2. 四类流量的隔离与静态路由
存算共网的风险是存储读写和梯度同步抢同一条链路. VI-A1 把流量分成四类: HFReduce, NCCL, 3FS 存储和其他. 建连时给每类分配不同的 IB Service Level, 再把 SL 映射到不同的 Virtual Lane. VL 是 IB 交换机上的独立物理队列, 有各自的缓冲和 credit, 一个 VL 被堵住不会让其他 VL 发生队头阻塞. 各 VL 之间的带宽比例由仲裁表配置, 论文没有给出具体比例.
VI-A2 讲的是路由. 存储场景天然有大量 incast (多个存储节点同时向一个客户端发数据), 开启自适应路由后拥塞反而扩散到更多链路, 所以改回静态路由. 静态路由下, 某个 leaf 上如果集中了大量存储节点, 它的上联链路会先被打满, 因此论文要求把存储, 计算, 管理节点均匀分布到各 leaf. 两区之间还挂着区间交换机, 拓扑并不完全对称, 静态路由表怎样生成, 是否用了子网管理器自带的 Fat-Tree 路由算法, 论文都没有交代.
VI-A3 是 NCCL 的两项调整. 第一, 让 NCCL 拓扑只经过同一 NUMA 节点内的 GPU 和网卡, 避免 CPU0 侧的 GPU 跨插槽访问网卡 (对照图 1, 网卡在 CPU1 下). 第二, 打开 PCIe Relaxed Ordering, 允许 PCIe 事务乱序完成, 减少写操作之间的相互等待. 论文说这两项都「减少拥塞, 提高带宽」, 没有给出前后对比数字.
2.3. 关掉 DCQCN 之后靠什么不拥塞
VIII-A 写明 Fire-Flyer 2 关闭了 IB 网卡的 DCQCN 拥塞控制, 原因是找不到一组参数同时适配 HFReduce 和 3FS 两类流量. HFReduce 是规整的大块双二叉树传输, 3FS 是大量并发小请求和突发的 incast, 两者对降速阈值和恢复速度的要求相反. 关掉之后, 网络依靠三层手段维持无拥塞: VL 隔离保证两类流量互不阻塞; 静态路由加均匀布点控制 leaf 上联的负载; 3FS 在应用层用 request-to-send 限制同时向一个客户端发送的服务端数量 (VI-B3).
第三层手段在开源代码里可以对上. 3FS 存储服务的 batch read 在读完 SSD 后先调用 applyTransmission 向客户端申请发送许可, 再获取每块 IB 设备的并发 RDMA 写信号量, 最终才发 RDMA Write. 客户端侧的 RDMATransmissionLimiter 默认 max_concurrent_transmission 为 64, 可以热更新. 这与 VI-B3「客户端限制并发发送方数量」一致, 代价是论文承认的端到端延迟增加.
3. HFReduce: 把 allreduce 的规约搬到 CPU
3.1. 三段流程与两段算法
HFReduce 要解决的成本是 PCIe 带宽. 在图 1 的节点里, GPU 之间没有 NVLink (加装 Bridge 之前), 也没有 PCIe switch, 任何 GPU 到 GPU 或 GPU 到网卡的数据都要穿过 CPU 的 root complex. 数据并行训练每一步都要对全部梯度做一次 allreduce, 论文 IV 的做法是不让 GPU 参与规约, 改由 CPU 在主机内存里做加法, 整个过程分三段: GPU 把梯度拷到主机内存 (D2H), CPU 先在节点内把 8 份梯度加成 1 份, 再与其他节点做 allreduce, 最终把结果拷回每张 GPU (H2D).
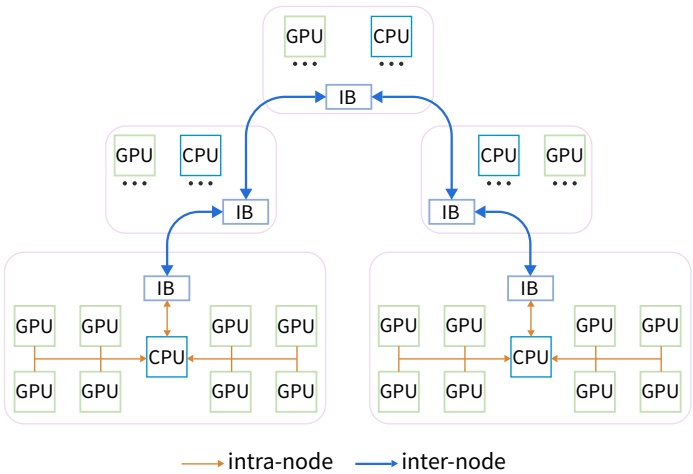
图 3: HFReduce 示意图, 节点内 8 张 GPU 的数据先汇到 CPU 规约, 节点之间经 IB 网卡按树形结构做 allreduce, 原文 Figure 6.
图 3 解析: 橙色箭头是节点内的 PCIe 传输, 8 张 GPU 都只和本节点 CPU 交换数据, GPU 之间没有箭头; 蓝色双向箭头是节点间的 IB 传输, 画成一棵三层的树, 对应双二叉树里的一棵. 图里只画了一棵树, 双二叉树的第二棵 (把同一批节点的叶子和内部节点角色互换) 没有画出; 每个节点内部只画了一个 CPU, 没有区分两个 NUMA 节点, 所以从图上看不出 D2H 目标内存交错分布在两个 NUMA 上这一实现细节.
Algorithm 1 是节点内部分. 梯度张量 按 Chunk_Size 切块, 每块用 cudaMemcpyAsync 拷到主机内存 (小数据改用 GDRCopy, 由 CPU 直接经 BAR 映射读写显存), 8 张 GPU 的第 块都到齐后, CPU 用 SIMD 指令把 8 份加到 , 随即把这一块交给节点间算法. 按块流水的意义在于第 块做节点间通信时, 第 块的 D2H 和节点内加法可以同时进行. Algorithm 2 是节点间部分, 写成两遍: 第一遍沿树向根规约, 每个节点收到子节点的数据后加到本地块上再发给父节点; 第二遍从根往下广播已规约的结果, 收到后直接 cudaMemcpyAsync 给本节点的每张 GPU. 双二叉树 (原文引用 [65], 即 NCCL 2.4 采用的 double binary tree) 让每个节点在一棵树里是叶子, 在另一棵里是内部节点, 两棵树各承担一半数据, 每个节点的收发量因此对称.
3.2. 与 NCCL 比 PCIe 流量与 kernel 占用
IV-B 给出的第一条优势是 PCIe 流量. 设参与通信的 GPU 数为 , 论文写 NCCL ring 的每单位数据要经过 次传输, 每次占用一张 GPU 的入向和另一张 GPU 的出向, 摊到每张 GPU 是 个单位的双向带宽; HFReduce 每单位数据只需一次 D2H 和一次 H2D, 即 1 个单位. 按标准的 ring allreduce (reduce-scatter 加 allgather), 每张 GPU 收发的数据量是 , 分子比论文少 1, 在 时是 1.75 对 1.875, 大时两者都趋于 2. 无论用哪个式子, 结论都是 NCCL 在每条 PCIe 链路上的流量约为 HFReduce 的两倍. 这里的前提是 GPU 之间的每一跳都要过 PCIe; 加装 NVLink Bridge 后, 成对 GPU 之间的那一跳不再占 PCIe, 这个两倍关系会变小.
第二条优势是不占 GPU 的 SM. D2H 和 H2D 都由 GPU 的 Copy Engine 完成, 不启动 kernel, 规约在 CPU 上做, 所以反向传播的计算 kernel 不会和通信 kernel 抢 SM. NCCL 的 allreduce 需要 kernel 执行, 会占用一部分 SM 并与计算 kernel 争抢. 论文据此说 HFReduce「complete asynchrony with no overhead」. 这句话只对 GPU 侧成立: CPU 侧要付出内存带宽 (3.3 节算出是原始数据量的 24 倍) 和 CPU 核, 这些资源与 dataloader 的解码和预处理共享, 论文没有给出 HFReduce 占用多少个 CPU 核, 也没有测它对数据加载的影响.
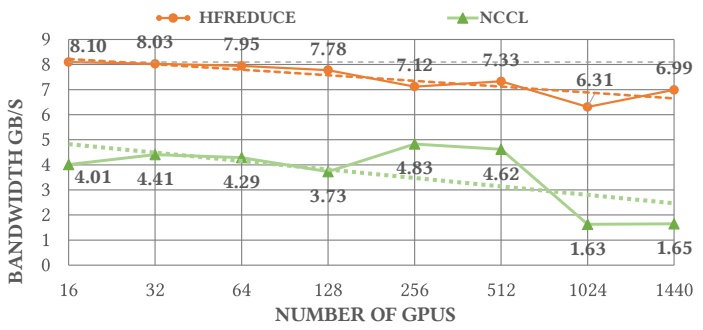
图 4: 16 到 1440 张 GPU 上 HFReduce 与 NCCL 的节点间 allreduce 带宽, 数据量 186 MiB, 原文 Figure 7a.
图 4 解析: 横轴是 GPU 数 (16 到 1440, 非等距), 纵轴是 GB/s. HFReduce 从 16 卡的 8.10 降到 1024 卡的 6.31, 1440 卡又回到 6.99; NCCL 在 16 到 512 卡之间是 3.73 到 4.83, 到 1024 和 1440 卡骤降到 1.63 和 1.65. 正文「HFReduce 6.3-8.1GB/s, NCCL 1.6-4.8GB/s」就是这两条曲线的最小值和最大值. 图里没有说明纵轴是 algbw (数据量除以耗时) 还是 NCCL 习惯的 busbw (algbw 再乘 ), 两种口径在大 下差约两倍; NCCL 在 1024 卡处骤降的原因论文也没有解释, 1024 卡是 128 台节点, 远小于单区的 600 台, 跨区不是原因.
IV-D2 补充了 NCCL 慢的硬件根源. EPYC Rome 不支持 chained write, GPU 与 IB 网卡之间的 P2P 带宽最高约 9 GiB/s, NCCL 走 GPUDirect RDMA 时被这条路径卡住, 所以只有 4 GB/s 左右. HFReduce 让数据先落主机内存再由网卡读走, 绕开了 GPU 到网卡的 P2P. 这一条也说明 NCCL 与 HFReduce 的对比带有平台条件: 换到支持 chained write 的 CPU, 或者节点里有 PCIe switch, NCCL 的基线会高很多, 图 4 的差距不能直接外推到其他 PCIe 机型.
3.3. 24 倍内存访问与 8 GB/s 的天花板
IV-D3 把 HFReduce 单节点的内存读写逐段加起来, 单位是 GPU 上原始梯度的大小. D2H 阶段 8 张 GPU 各写一份, 共 8 次写; 节点内规约读 8 份, 写 1 份结果; 节点间 allreduce 由 IB 发送读 2 次, 接收写 2 次, 再为规约加法读 1 次; H2D 阶段用 GDRCopy 读 2 次 (每个 NUMA 一次, 读进 CPU cache 后写给本 NUMA 的 4 张 GPU), 用 cudaMemcpyAsync 则要读 8 次. 合计:
式中每一项的单位都是一份梯度大小的内存读或写. 节点间那一项的「发 2, 收 2」可以从双二叉树推出来: 两棵树各管一半数据, 节点在作内部节点的那棵树里, 规约阶段收 2 个子节点各 0.5, 发给父节点 0.5, 广播阶段收 0.5, 发给 2 个子节点各 0.5; 在作叶子的那棵树里收发各 0.5. 加起来发 2 收 2. H2D 若不用 GDRCopy, 总数变成 30, 理论上限从 13.3 GB/s 降到 GB/s, 这就是 GDRCopy 在 H2D 段的价值.
16 通道 DDR4-3200 的实际访存速度按 320 GB/s 计, GB/s 是 HFReduce 的理论上限. 论文说计入 allreduce 算法和网络带宽后实际约 12 GB/s, 网络一侧的上限可以从「发 2 收 2」算出: 每个节点只有一张 200Gbps 网卡, 单向 25 GB/s, 每单位数据要发 2 个单位, 节点间 allreduce 的速度上限是 GB/s. 实测只有 8 GB/s 出头, 原因在图 1 里的 GPU5 和 GPU6: 两张卡共用一个 root port, Rome 与 Milan 的 root port 到 CPU 内部总线最多约 37.5 GB/s, 单卡 PCIe 4.0 x16 能跑 27 GB/s 以上, 两卡同时传就只剩约 37 GB/s, D2H 与 H2D 双向同时进行时还会更低. 节点内规约要等 8 张卡的同一块都到齐, 最慢的那对卡决定了整条流水的速度.
3.4. HFReduce with NVLink
IV-C 是加装 NVLink Bridge 之后的版本. 成对 GPU 先在 NVLink 上互相规约, 再把梯度交给 CPU; CPU 返回结果时把数据切开, 分别发给一对 GPU 中的两张, 两张卡再经 NVLink 做 allgather. 论文写 NVLink Bridge 提供 600 GB/s, NVIDIA 给 PCIe A100 双卡 Bridge 标的 600 GB/s 是双向合计, 远高于 PCIe 4.0 x16 的约 32 GB/s 单向. 这一版的内存访问次数文中没有给出. 按「先 reduce-scatter 到成对两卡, 每卡只拷一半」的读法重算: D2H 是 8 张卡各写 0.5, 共 4; 节点内规约读 4 写 1; 节点间不变, 仍是 5; H2D 每个 NUMA 只需把两个半份各读一次, 共 2. 合计 16, 理论上限 GB/s, 共享 root port 的 GPU5 和 GPU6 每张卡的 PCIe 流量也减半. 这只是按论文对流程的文字描述推出的数, 没有实测数据验证.
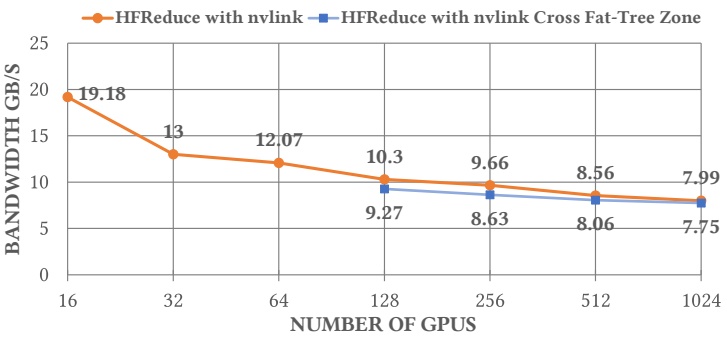
图 5: HFReduce with NVLink 在 16 到 1024 张 GPU 上的节点间带宽, 以及 128 卡以上跨两个 Fat-Tree 区的带宽, 原文 Figure 7b.
图 5 解析: 橙线是区内, 16 卡 19.18, 32 卡 13, 64 卡 12.07, 128 卡 10.3, 256 卡 9.66, 512 卡 8.56, 1024 卡 7.99 GB/s; 蓝线是跨区, 128 到 1024 卡为 9.27 到 7.75 GB/s. 16 卡只有 2 台节点, 双二叉树退化为两点交换, 每个节点只需发 1 收 1, 网络上限是 25 GB/s 而非 12.5, 所以 19.18 不能当作稳态数字. 与图 4 同卡数相比, NVLink 版在 1024 卡上是 7.99 对 6.31, 提升约 27%; 128 卡是 10.3 对 7.78, 提升约 32%.
正文「HFReduce with NVLin…6 tokens truncated… truncated…证的 token 吞吐; 如果 batch size 指的是 token 数, 算出的利用率会低三个数量级, 不合常理, 所以序列数的读法更可能成立.
4.3. 3FS: 论文给出的硬件与机制
VI-B 介绍 3FS 的篇幅不长, 给出的是硬件配置和四个机制要点. Table IV 的存储节点是 1 颗 64 核 EPYC 7742, 512GB 8 通道 DDR4-3200, 2 张 200Gbps CX6 网卡, 16 块 15.36TB PCIe 4.0 x4 NVMe. 一共 180 台, 网卡 360 张, 理论出向带宽 GB/s 即 9 TB/s, 实测总读吞吐 8 TB/s; 2880 块 SSD 以镜像冗余提供「20 PiB 以上」的空间. 镜像按两副本算, PB, 合 19.6 PiB, 略低于 20 PiB; 写成 PB 才过 20.
四个机制是: 集群管理 (cluster manager 主备选举, meta 与 storage 服务向它发心跳, 所有服务和客户端从它拉配置); 元数据存在分布式 KV 里, inode 表与目录项表分开, 目录项的键是 (父目录 inode, 文件名); 数据面用 CRAQ 链式复制, 写全部副本, 读任一副本, 文件按 stripe 大小 从 chain table 的某个偏移开始分配到连续 条链上; 拥塞控制用 request-to-send, 存储服务读完 SSD 后先请求客户端许可, 获准后以 RDMA WRITE 加 RDMA SEND 送出. 这些机制在开源代码里的实现, 包括 FoundationDB 上的表结构, 链状态机, USRBIO 客户端和 6.6 TiB/s 压测的口径, 见 3FS 仓库解析; 用 3FS 做中间数据的 GraySort 见 smallpond 技术解析.
有两部分内容只出现在 Fire-Flyer 论文里, 开源文档没有覆盖. 一是 VI-B4 的 3FS-KV: 建在 3FS 之上的共享存储数据处理系统, 支持 key-value, 消息队列和对象存储三种模型, 支撑 DeepSeek 的硬盘 KV Context Caching, 论文称它把 LLM 服务成本降低一个数量级, 但没有给出 3FS-KV 的任何性能数字, 开源仓库里也没有名为 3FS-KV 的组件, 只有 KVCache 客户端的读吞吐图. 二是 3FS 与网络调优的配合: VI-A1 把 3FS 流量放进单独的 VL, VI-A2 的均匀布点让存储节点的上联流量分散到所有 leaf, request-to-send 在应用层限制 incast, 三者合起来才让 2.3 节里关掉 DCQCN 的网络保持不拥塞.
4.4. HAI Platform 的分时调度与 checkpoint manager
VI-C 的 HAI Platform 按分时原则管理集群: 用户提交的任务可以被平台按资源需求和集群忙闲打断, 再加载. 任务代码必须遵守平台约定, 依次是接收打断信号, 保存 checkpoint, 通知集群已打断, 下次从 checkpoint 恢复. 资源不做 GPU 池化, 以计算节点为基本单位, 按资源类型和网络区域打标签. 开源的 HFAiLab/hai-platform 能对上这几点: 示例调度器 FIFOAssigner 以 task.nodes 为单位扣配额, 按 (用户, 优先级, group) 三元组维护配额, 再按 group 统计 Ready 节点并累加判断能否运行; 同一任务被打断后重提交会产生新 id, first_id 指向链头, 排队中的非链头任务状态标为 SUSPENDED. 打断信号由 suspend_helper.py 实现, 它用 zmq 收到打断指令后在一个 1 字节的 SysV 共享内存里写入标志位, 训练进程轮询这个标志位决定何时保存并退出.
论文说 HAI Platform「facilitating 99% utilization」, 没有定义 utilization 的口径. hai-platform 的文档给出的是另一组数: 1500 多台计算节点, 日常节点占用率 95% 以上, 日常 GPU 利用率 75% 以上. 「占用」指节点被分配给任务, 「利用」指 GPU 实际在算, 两者差 20 个百分点, 99% 更接近占用率一类的口径.
VII-A 的 checkpoint manager 服务于打断恢复和硬件故障. 参数与优化器状态先异步从 GPU 拷到主机内存, 再切块用 3FS 的 batch write 接口写出, 单节点超过 10 GiB/s, 一般每 5 分钟存一次; 保存时记录每个张量的索引和在文件内的偏移, 加载时用 batch read 一次定位. 论文的结论是故障时最多丢 5 分钟进度. 这个说法只计了训练进度, 没有计故障检测, 节点替换和重新加载的时间, 论文也没有给出一次恢复的总耗时.
单节点 10 GiB/s 在全集群同时保存时达不到. 1250 台节点每台 10 GiB/s, 合计约 13.4 TB/s, 已超过存储侧 9 TB/s 的网卡上限; 镜像冗余下每份数据要写两个副本, CRAQ 的链式转发让存储网卡的入向流量翻倍, 全集群同时写时每台计算节点能分到的带宽约为 GB/s. 以 LLaMA-13B 为例, 按 BF16 权重加 FP32 主权重和两份 Adam 状态每参数 14 字节, checkpoint 约 182 GB, 64 台节点各写约 2.8 GB, 按 10 GiB/s 不到 0.3 秒, 按 3.6 GB/s 不到 1 秒, 「数秒内完成」在这个规模上都成立. 所用模型的 checkpoint 大小文中没有给出.
5. 稳定性统计与下一代架构
5.1. Validator 与 Xid 分类
VII-B 的 validator 是每周在节点上跑一遍的硬件自检, 不合格的节点从调度平台摘除. 检查项包括硬件频率与链路速率, CPU 压力与内存带宽, 逐字节写读显存, 占满显存跑 GEMM (同时检验芯片运算逻辑), 节点内 allreduce (从应用层测 NVLink 带宽), 以及存储带宽压测. 显存逐字节检查和满显存 GEMM 针对的是 VII-C 提到的 ECC 查不出的计算错误和显存错误, 这类错误在训练里表现为 gradnorm 尖峰, loss 爆炸甚至不收敛. 论文没有给出 validator 每周摘掉多少节点, 也没有给出它对静默错误的检出率.
Table V 把 NVIDIA 驱动上报的 Xid 分成五类: 软件引起 (13, 31, 43, 45), NVLink 错误 (74), 显存 ECC (63, 64, 94, 95), 不可纠正故障 (44, 48, 61, 62, 69, 79), 以及 GSP 故障 (119). Table VI 是过去一年的计数, 合计 12970 条. 软件类合计 7114 条, 占 54.85%, 其中 Xid43 有 4342 条占 33.48%, Xid31 有 2487 条占 19.18%. 论文把 Xid43 称为非法内存访问; 按 NVIDIA 的 Xid 文档, 非法地址访问对应 Xid31 (GPU MMU 页错误), Xid43 是用户程序出错后 GPU 停止处理该通道, 两者常成对出现. Xid74 有 5521 条, 占 42.57%. 显存 ECC 四项合计 277 条, 占 2.14%, 与正文「about 2%」一致. 不可纠正故障六项合计 57 条, GSP 1 条. 去掉软件类, 硬件 Xid 共 5856 条, Xid74 占其中的 94.3%.
Table V 写 Xid74 的出现率「比其他硬件故障高几个数量级」. 按 Table VI, Xid74 的 5521 条是显存 ECC 合计 277 条的约 20 倍, 是不可纠正故障 57 条的约 97 倍, 只差一到两个数量级. 另外 Xid 是驱动日志里的消息条数, 同一次故障可以连续上报多条, 是否去重也没有说明, 所以 Table VI 的计数不等于故障次数.
5.2. ECC 与网络闪断
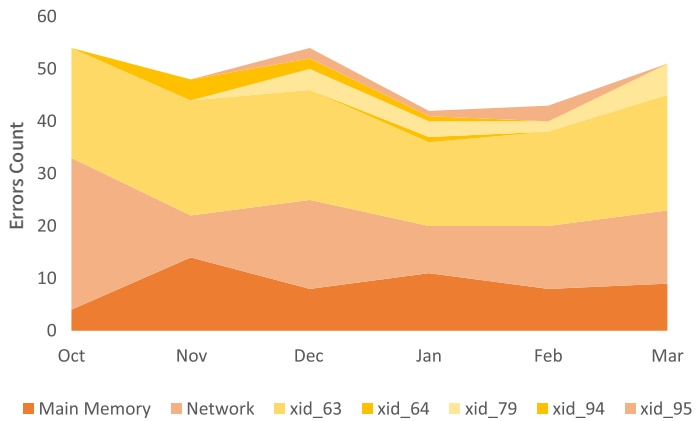
图 10: 2023 年 10 月到 2024 年 3 月每月的 CPU 内存 ECC, IB 网络闪断与 GPU 相关 Xid 计数堆叠面积图, 原数据见附录 Table VII, 原文 Figure 10.
图 10 解析: 横轴是 6 个月, 纵轴是月度计数, 自下而上依次堆叠 Main Memory, Network, Xid63, Xid64, Xid79, Xid94, Xid95. 每月总数在 42 到 54 之间, 10 月的 Network 层最厚. 图注说「xids」是与 GPU 显存 ECC 相关的错误, 但堆叠里包含 Xid79, 而 Table V 把 Xid79 归在不可纠正故障里, 不属于显存 ECC 类. 图里没有 Xid74, 所以它反映的是除 NVLink 以外的硬件故障.
Table VII 的行列和都能对上: Main Memory 54, Network 89, Xid63 120, Xid64 1, Xid79 15, Xid94 7, Xid95 6, 六个月合计 292. 正文「IB link failures account for 30% of hardware faults excluding Xid74」是 , 分母只含 Table VII 的七列, 不含 Xid61, Xid62 等其他不可纠正故障. GPU 侧 ECC 类 (Xid63, 64, 94, 95) 六个月 134 条, CPU 内存 ECC 54 条, 约 2.5 倍. 按容量折算差距更大: 10,000 张卡的显存共 400 TB, 1,250 台节点的主机内存共 640 TB. NVIDIA 的 Xid 文档把 Xid63 定义为行重映射 (row remapping) 的记录事件, 这是 A100 处理 ECC 的正常路径; Table V 也写明「多数情况下重置 GPU 即可」. 因此, 把 Xid63 与不可纠正错误放进同一组累计, 会高估真正需要人工处理的故障数.
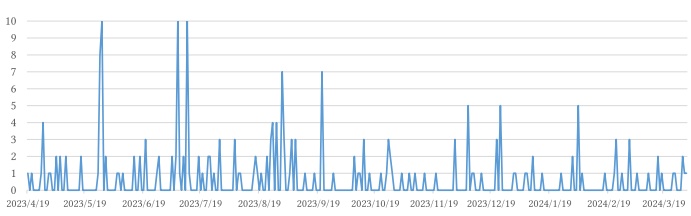
图 11: 2023 年 4 月 19 日到 2024 年 3 月 31 日每日 IB 链路闪断次数, 原数据见附录 Table VIII, 原文 Figure 11.
图 11 解析: 横轴是日期, 纵轴是当日闪断次数. 大多数日子为 0 或 1, 尖峰出现在 2023 年 5 月 27 日 (8 次) 和 28 日 (10 次), 7 月 7 日 (10 次), 7 月 12 日 (10 次), 8 月 31 日与 9 月 21 日 (各 7 次). 图中看不出单次闪断影响了多少条链路或多少个任务.
Table VIII 共列出 101 个日期, 合计 213 次, 其中 2023 年 6 月 16 日一行记为 0, 不清楚为何列入. 次数不少于 5 的 9 天合计 67 次, 占全年 31%. 按月汇总是 4 月 (从 19 日起) 8, 5 月 30, 6 月 13, 7 月 39, 8 月 30, 9 月 20, 10 月 13, 11 月 8, 12 月 17, 2024 年 1 月 9, 2 月 12, 3 月 14. 前半年 (4 到 9 月) 140 次, 后半年 73 次, 少了将近一半, 正文说闪断「在整个运行期随机发生」, 但按月数据有明显下降和集中爆发. 每次闪断计的是一条链路还是一个事件, 也没有交代. 两区共约 1,600 条 leaf 到 spine 的上联, 加上约 1,430 台节点的接入链路, 链路总数在 3,000 条以上, 按这个数折算每条链路每年约 0.07 次.
5.3. 与 NSDI 24 统计的比较口径
VIII-D 引用 [96] (NSDI 24, 上海 AI Lab 的数据中心 LLM 开发表征) 的数字: 103 次故障里 NVLink 相关 54 次, 论文写成 52.42%, 四舍五入应为 52.43%. 对比的另一边是 Fire-Flyer 2 的 Xid74 占 GPU 故障的 42.57%, 论文据此暗示 PCIe 加 Bridge 的 NVLink 故障占比并不比 SXM 机型高.
两个百分比的分母不同. [96] 的 103 是故障次数, 分母里包含 CUDA 错误, 节点故障, ECC 和网络错误; Fire-Flyer 的 12970 是 Xid 消息条数, 分母里有 54.85% 是软件引起的 Xid, 不含网络闪断和 CPU 内存错误. 只看硬件 Xid, Xid74 的占比是 94.3%; 若按 [96] 的口径把网络闪断也算进分母, 需要同一时间窗的网络数据, Table VIII 是一年 213 次, Table VI 也是一年, 两表相加后 Xid74 占 . 无论按哪种口径, 都推不出「PCIe 方案的 NVLink 故障占比更低」.
5.4. 下一代架构: 1:1 网卡与多平面网络
IX 的下一代 PCIe 节点面向 MoE 训练. MoE 的 EP 每层前向和反向各需要两次 all-to-all, 通信量随激活专家数增长, 且无法像 DP 的 allreduce 那样靠 CPU 规约减半 PCIe 流量. 下一代节点改为 GPU 与网卡 1:1, 与 DGX-H100/B100 相同, 每卡的网络配额从 25Gbps 提到一整张网卡. 网络上考虑多平面以降低成本, 并考虑用 RoCE 交换机替代 IB.
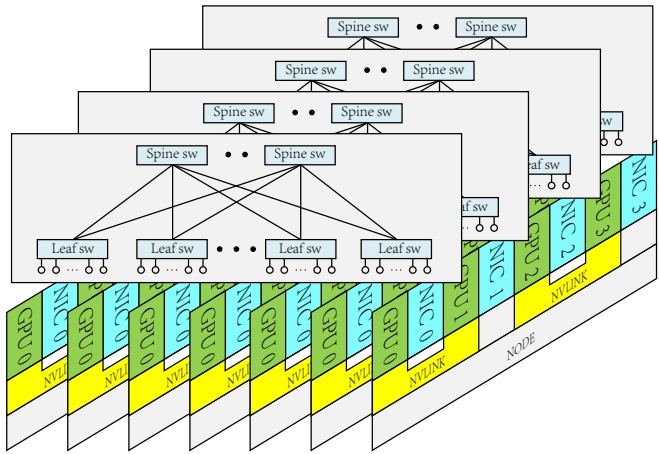
图 12: 下一代 PCIe 节点与多平面 Fat-Tree 网络示意, 每层是一个独立的两层 Fat-Tree 平面, 节点上编号相同的网卡接入同一平面, 原文 Figure 12.
图 12 解析: 图上叠了四层网络, 每层都是 spine 加 leaf 的两层 Fat-Tree, 平面之间没有连线. 下方节点画了成对 GPU 之间的 NVLink, 以及 NIC0 到 NIC3, 每个编号的网卡只连本编号的平面. 图里没有画出跨平面的数据怎么走: 不同平面之间不互通, 两台节点上接在不同平面的 GPU 要通信, 只能先经节点内 (NVLink 或 PCIe) 转到同一平面的网卡, 这部分转发的开销没有讨论.
32,768 这个数可以从交换机端口数推出. 128 口交换机组两层 Fat-Tree, leaf 64 口向下, 64 口向上, spine 的 128 个端口各连一台 leaf, 所以最多 128 台 leaf, 每个平面 个端点, 4 个平面共 32,768 个网卡端口, 1:1 时就是 32,768 张 GPU. 后来 DeepSeek-V3 的硬件论文 (ISCA 2025, 见 DeepSeek-V3 硬件与模型协同设计解析) 在 H800 集群上用的是八平面两层 Fat-Tree, 每对 GPU 与网卡接入一个平面, 交换机是 64 口 400G IB, 按同一算法每个平面 个端点, 八平面 16,384 张 GPU. 两者的方向一致, 落地时选了 IB 而不是 Fire-Flyer 论文设想的 RoCE. V3 的 EP all-to-all 由 GPU 侧的通信库承担, 实现见 DeepEP 解析, 与 HFReduce 把规约放到 CPU 的路线不同.
6. 数字复核
6.1. 能对上的数字: 下表把正文里反复引用的数字逐个放回它出处的表或图重算. 「复算」一列写的是用论文自己给出的量能得到的式子, 结果与论文一致的记为一致, 只差取整的也算一致.
| 数字 | 出处 | 复算 | 结果 |
|---|---|---|---|
| 122 台交换机 | Table III, Figure 5 | 一致 | |
| 成本一半 | Table III | 一致 | |
| 性价比 1.38 | Table II | 一致 | |
| 能耗降 40% | Table II | 一致 | |
| HFReduce 上限 13.3 GB/s | IV-D3 | 一致 | |
| 存储出向 9 TB/s | VI-B2, Table IV | GB/s | 一致 |
| 2880 块 SSD | VI-B2, Table IV | 一致 | |
| MoE 效率 92.92%, 76.14% | Figure 9b | , | 一致 |
| FSDP 弱扩展 95% | Figure 8b | 一致 | |
| Xid74 占 42.57% | Table VI | 一致 | |
| 显存 ECC 约 2% | Table VI | 一致 | |
| 网络闪断占 30% | Table VII | 一致 |
这些数字一致, 说明表与表之间的基础数据是自洽的: Table VI 十六行加起来正好是 12970, 每行百分比按 12970 重算到小数点后两位都对得上; Table VII 每一行和每一列的合计都对得上. 网络部分 Table III 的「PCIe 三层 Fat-Tree 200 台」与 III-C 的「40 core 加 160 spine 和 leaf」也一致, DGX 方案的 1,320 台按 III-C 拆成 320, 500, 500 也一致, 只是 320 台 core 的来历没有交代.
一致的数字仍然带着口径. 「一半」是整集群采购价, 「83%」是单卡 GEMM, 「40%」是 ResNet 训练时的单节点平均功耗, 三个数分别来自集群, 单卡和单节点三个层面, 摘要把它们放进同一句话. 「13.3 GB/s」是按 320 GB/s 实际访存速度算的理论值, 不是测得的; 「30%」的分母只包含 Table VII 的七类故障.
6.2. 前后矛盾与口径不一处: 扩展效率与带宽一类有四处. LLaMA-13B 从 64 卡到 512 卡, 按图 8 的耗时算效率是 82.5%, 正文写 91%, 91% 只与 256 卡的 91.9% 吻合; 同一段里 DeepSeekMoE 的两个效率用同一个式子都能复现, 说明式子没有换, 是 LLaMA 的数字写错了位置. HFReduce with NVLink「超过 10 GB/s」只在 128 卡及以下成立, 256 卡起是 9.66, 8.56, 7.99. HaiScale FSDP「训练时间减少近一半」, 图 7 逐点的降幅是 32% 到 41%. VGG16 的「近 88%」按图 6 是 86.7%, 而且 NCCL 后端自己的弱扩展效率 93.8% 更高, 「88% 的并行扩展性」不能当作 HFReduce 比 NCCL 扩展得更好的证据.
成本一类有一处. III-C 同一段先写「60% 的 GPU 成本和能耗」, 后写「80% 的性能, 仅 60% 的成本」, V-C 和摘要写「一半的成本」. 60% 是 Table II 的单节点价格, 一半是 Table III 的整集群价格, 论文在不同段落里交替使用这两个数, 没有说明换了口径. III-C 的「60% 的能耗」与 Table II 的 59.5% 一致, 结论里写成「less than 60%」, 也一致.
故障统计一类有四处. Table VII 的 2023 年 10 月 Network 一格是 29, 按 Table VIII 逐日加起来只有 13, 其余五个月两表完全相同, 差出的 16 次全在 10 月; 若以 Table VIII 为准, 正文的 30% 应为 . Table V 说 Xid74 比其他硬件故障高「几个数量级」, Table VI 显示只高一到两个数量级. Figure 10 的图注把堆叠里的 Xid 都称作显存 ECC 相关, 其中的 Xid79 在 Table V 里属于不可纠正故障. VIII-D 引用 [96] 的 写成 52.42%, 应为 52.43%, 而且拿故障次数的占比和 Xid 消息条数的占比相比, 分母不同.
存储与公式一类有四处. 20 PiB 以上的镜像容量按 2880 块 15.36TB 两副本算是 19.6 PiB. III-B 写近 200 台存储服务器, Table IV 和 VI-B2 是 180 台. IV-B 的 ring 流量式 比标准 ring allreduce 的 多 . GDRCopy 在 IV-A 用于 H2D, 在 IV-D1 第一条写成用于 D2H 的小数据加速, 两处都写「读主机内存减少三倍」, 按 IV-D3 的 8 次对 2 次, 减少的是四分之三, 读次数变为原来的四分之一.
6.3. 论文没有给出的数: 有几项数字是判断这套方案时最需要的, 论文都没有给出. 第一是端到端对比: 全文没有一次在 DGX-A100 集群上跑同一个训练任务的吞吐或 MFU 对比, 「接近 DGX-A100」只由单卡 GEMM 支撑; 4.2 节按 推出的 LLaMA-13B 约 42% 到 51% 的利用率, 依赖 batch size 单位的读法. 第二是通信细节: Figure 7 的带宽是 algbw 还是 busbw, HFReduce 的 chunk 大小, 占用几个 CPU 核, VL 之间的带宽比例, 静态路由表怎么生成. 第三是运维: 一次故障恢复的总耗时, validator 每周摘除的节点数, 运营成本的任何一个具体金额.
这些缺口让论文的结论分成两层. 有表格直接支撑的结论是: 整集群采购价约为 DGX 方案的一半, 单节点 ResNet 功耗约六成, HFReduce 在 Rome 平台上的 allreduce 带宽约为 NCCL 的 1.5 到 4.2 倍 (图 4 同卡数逐点相除), 一年的硬件故障里 NVLink Bridge 是最大来源. 需要读者自己补条件的结论是: 「性能约为 DGX 的 80%」只在不受互连限制的负载上成立; HaiScale 的扩展效率只覆盖到 512 卡 (LLaMA) 和 640 卡 (DeepSeekMoE), 远小于 10,000 卡的集群规模; 99% 的利用率没有定义. Fire-Flyer 2 之后, DeepSeek 在 H800 集群上转向 1:1 网卡和多平面网络, 训练通信改由 GPU 侧的通信库承担, 见 DeepSeek-V3 解析 与 5.4 节.
参考文献
- W. An et al. Fire-Flyer AI-HPC: A Cost-Effective Software-Hardware Co-Design for Deep Learning. SC24, arXiv:2408.14158, 2024. https://arxiv.org/abs/2408.14158
- DeepSeek-AI. 3FS: Fire-Flyer File System. https://github.com/deepseek-ai/3FS
- HFAiLab. HAI Platform. https://github.com/HFAiLab/hai-platform
- NVIDIA. Massively Scale Your Deep Learning Training with NCCL 2.4 (double binary tree). https://developer.nvidia.com/blog/massively-scale-deep-learning-training-nccl-2-4/
- NVIDIA. GDRCopy. https://github.com/NVIDIA/gdrcopy
- NVIDIA. Xid Errors. https://docs.nvidia.com/deploy/xid-errors/index.html
- Q. Hu et al. Characterization of Large Language Model Development in the Datacenter. NSDI 24. https://arxiv.org/abs/2403.07648
- C. Zhao et al. Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures. ISCA 2025, arXiv:2505.09343. https://arxiv.org/abs/2505.09343
- 幻方 AI. 模型并行训练工具 hfreduce. https://www.high-flyer.cn/blog/hf-reduce/
- 幻方 AI. 在减少网络拥塞上, 我们的一点实践 (一). https://www.high-flyer.cn/blog/network-1/