来源: deepseek-ai/3FS, 2025-02-28 在 DeepSeek 开源周第五天发布 (仓库首个提交 815e55e 为 2025-02-27). 仓库没有打版本 tag, 最新提交是 main 分支 2026-05-07 的 22fca04, 共 113 个提交, 许可证 MIT. 3FS 是 Fire-Flyer 2 AI-HPC 集群的存储层, 论文里报告的同一套 180 节点存储 (360 块 200Gbps 网卡, 理论 9 TB/s, 实测 8 TB/s) 与集群网络, HFReduce 等内容见 Fire-Flyer AI-HPC 解析. README, 设计说明与 USRBIO API 参考的逐段对照见 3FS 文档对照译稿. 代码引用都给出 GitHub 链接.
1. 存储瓶颈与总体架构
1.1 四类负载对存储提出的要求
README 把 3FS 的用途列成四类: 数据准备, 训练数据加载, checkpoint, 推理 KVCache. 这四类负载的共同点是读多写少, 而且读的形态差异很大. 数据准备阶段的分析流水线产出大量中间文件, 需要原子地移动目录, 递归删除目录; 训练数据加载要在数千个计算节点上随机取样本, 单个样本几 KB 到几 MB, 在文件里通常不按 4K 对齐; checkpoint 是周期性的大块并行写和故障后的大块并行读; KVCache 是推理时按前缀命中后整块读回之前算好的 key/value.
设计说明给出的目标是「读写吞吐随 SSD 数量和客户端与存储之间的对分带宽线性扩展」, 并且应用不关心数据在哪台机器上. 训练数据加载因此可以不做预取, 也不必提前把数据集打乱再切片: 每个 rank 直接按随机下标从共享存储读样本. 这一点和 DeepSeek 的硬件部署相互印证: DeepSeek-V3 硬件洞察 提到每台训练节点除 8 块 IB 网卡外还单独配一块 400Gbps RoCE 网卡接存储平面, 访问的正是 3FS; DualPath 的实验集群把 3FS 当作 KVCache 后端, 写明集群级 3FS 没有内部 DRAM 缓存, 能跑满存储网卡的 400Gbps. DeepSeek-V4 的沙箱平台 DSec 把只读镜像层放在 3FS 上按需拉取数据块.
1.2 四个组件与它们之间的数据流
3FS 由集群管理器 (mgmtd), 元数据服务 (meta), 存储服务 (storage) 和客户端四部分组成, 全部接在 InfiniBand 或 RoCE 的 RDMA 网络上. mgmtd 部署多个, 靠一条存放在 FoundationDB 里的租约选主, 默认租期 60 秒, 每 10 秒续一次, 逻辑在 src/mgmtd/store/MgmtdStore.h 的 extendLease 和 src/mgmtd/service/MgmtdConfig.h. 主 mgmtd 收各服务心跳, 维护链表和每个存储目标的状态, 把路由信息推给服务和客户端. meta 服务无状态, 所有 inode, 目录项, 文件会话都存在 FoundationDB 里, 客户端可以连任意一台 meta. storage 服务管理本机若干 SSD, 每块 SSD 上切出多个存储目标 (target), 不同 target 加入不同的复制链.
一次读文件的数据流是这样的: 客户端先经 meta 打开文件, 拿到 layout (链表 ID, chunk 大小, stripe 大小, 链范围和 shuffle 种子); 之后按偏移自己算出 chunk 序号和所在链, 查 mgmtd 下发的路由表找到链上的 target, 直接向存储服务发 RPC; 存储服务读盘后用 RDMA Write 把数据写进客户端注册过的内存. meta 只出现在打开, 关闭, 列目录, 改长度这些元数据操作里, 数据路径上没有它. FoundationDB 同时承担两种职责: 文件系统元数据和集群协调 (租约, 节点信息, 配置), 设计说明把这称为「少一个依赖」.
1.3 为什么选文件接口和 FUSE 内的原生客户端
设计说明解释了不用对象存储的理由: 对象存储能用带斜杠的键模拟目录, 但给不了原子 rename 目录和递归删除, 而 DeepSeek 内部常见的模式恰好是「先写临时目录, 再整体改名到最终位置」, 处理海量小文件时又离不开递归删除. 符号链接和硬链接被用来给追加式更新的数据集做轻量快照. 文件接口还有一个现实好处: CSV, Parquet 数据集和现有的数据加载器不用改就能读.
客户端没有做成内核 VFS 模块. 内核模块能避开 FUSE 的拷贝和锁争用, 但出错时可能整机宕机且不留日志, 升级要停掉所有使用该文件系统的进程, 否则只能重启. 3FS 的折中是在 FUSE 守护进程里再实现一套原生客户端: 元数据操作仍走 FUSE, 保持 POSIX 语义; 读写数据走共享内存环 (USRBIO), 绕开内核 FUSE 队列. 这个选择决定了后文的很多细节, 包括虚拟目录 3fs-virt 的存在, 以及 fd 注册这一步.
2. 数据面: 文件布局, CRAQ 复制与 chunk 引擎
2.1 文件到链的映射
文件按固定大小的 chunk 切分, chunk 大小和 stripe 大小按目录配置, 新文件继承父目录的 layout. 新建文件时, meta 从链表里按轮转选出连续的 stripe 条链, 再生成一个 shuffle 种子把它们打乱, 种子写进 inode. 客户端算第 个 chunk 所在的链时, 先对链编号列表做一次确定性打乱, 再取下标 , 代码在 src/fbs/meta/Schema.cc 的 ChainRange::getChainIndexList 与 Layout::getChainOfChunk. chunk 序号是 32 位整数, 超过上限时 File::getChunkId 返回 kFileTooLarge, 所以单个文件最多 个 chunk.
ChunkId 比设计说明写的多一段: 8 字节 inode, 2 字节 track, 4 字节 chunk 序号, 三段都按大端序存, 见 src/fbs/meta/Schema.h. 大端序让同一文件的 chunk 在存储端按序号连续排列, meta 在 close 或 fsync 时可以用一次范围查询找到每条链上的末尾一个 chunk, 由此算出精确文件长度. 打乱这一步后来成了兼容性问题: 最初用的是 std::shuffle, 而 libstdc++ 不同版本对同一种子给出的排列不同, g++10 与 g++11 编出的客户端和服务端会把同一个 chunk 算到不同的链上. 2025-12-26 的 #369 改成可配置的确定性实现, 构建时必须用 -DSHUFFLE_METHOD 锁定与已有集群一致的算法, README 的构建说明因此加了一段 (见 issue #368).
2.2 写路径: 链头串行化, 逐跳拉取, 尾部提交
CRAQ 的写请求只能从链头进入. src/storage/service/StorageOperator.cc 的 handleUpdate 先检查自身是否位于链头, 否则返回 kRoutingError; 再取 chunk 锁, 拿锁之后重新核对链版本, 防止等锁期间链已经变化. doUpdate 用 rdmaReadBatch 从客户端 (或前驱) 的内存把写数据拉过来, 每块 IB 设备一个信号量限制并发的 RDMA Read. 数据进本地缓冲后写入存储引擎, 生成待定版本 , 然后 reliableForwarding.forwardWithRetry 把请求转给后继. 后继同样拉数据, 写盘, 再往后转; 链尾收到后直接提交, 返回确认, 确认沿链回传, 每一跳收到确认后提交本地待定版本并释放锁.
设计说明之外, 代码在写路径上还有两层保护. 第一层是 checksum 比对: 链头在本地写完后会拿自己的 checksum 和后继回传的 checksum 比较, 不一致返回 kChecksumMismatch. 第二层是幂等: src/storage/service/ReliableUpdate.cc 的 ReliableUpdate::update 按 (客户端, 链, channel) 记录最近一次请求的 seqnum, requestId 和结果, 更旧的 seqnum 返回 kDuplicateUpdate, 同一 seqnum 重发时直接回放缓存的结果, channel 被占用时返回 kChannelIsLocked. 客户端超时重发因此不会把同一次写应用两遍. 版本号冲突也被分成两类: kChunkCommittedUpdate 与 kChunkStaleUpdate 表示这次更新已经生效过, 按成功处理; kChunkMissingUpdate 与 kChunkAdvanceUpdate 表示中间缺了更新或版本跳了号, 作为错误返回.
2.3 读路径: 读任意副本与待定版本
CRAQ 允许读请求发给链上任一副本, 这是 3FS 能用满所有副本读带宽的前提. 客户端选副本的策略在 src/client/storage/TargetSelection.h, 有 Default, LoadBalance, RoundRobin, RandomTarget, TailTarget, HeadTarget 和手工模式, 另外可以按 trafficZone 偏向同一网络区域的 target. 存储端 StorageOperator::batchRead 拿一份 target 路由快照, 只接受处于 up-to-date 状态的 target, 把读请求按 batch_read_job_split_size 切成多个作业交给 AIO 线程池 (libaio 或 io_uring), 读完后一次性 RDMA Write 回客户端, 小数据也可以用 SEND_DATA_INLINE 随响应带回.
设计说明对「同时有已提交版本和待定版本」的处理是返回一个特殊状态码, 让客户端稍后重试或改发宽松读. 这只在旧的 C++ 存储路径上成立: src/storage/store/ChunkReplica.cc 的 aioPrepareRead 在 commitVer 不等于 updateVer 时返回 kChunkNotCommit, 客户端 src/client/storage/StorageClientImpl.cc 把它和 kRoutingVersionMismatch 归为快速重试错误. Rust 引擎路径 src/storage/store/ChunkEngine.cc 只读已提交的 chunk 元数据, 正在写的新 chunk 挂在引擎的 writing_list 里, 读请求看不到它, 直接拿到上一个已提交版本. 宽松读对应请求里的 ALLOW_READ_UNCOMMITTED 特性位. 2025 年 9 月和 10 月的两个提交 #341, #346 又放宽了批量读对链版本和公开状态的检查, 换来的是故障切换期间少一些读失败.
Fire-Flyer 论文还描述了一个读侧的拥塞控制: 存储服务读完 SSD 后先向客户端申请发送许可, 客户端限制同时向它发数据的服务数, 拿到许可的服务才用 RDMA Write 加 RDMA Send 把数据送过去. 代码里对应 src/common/net/RDMAControl.h 的 RDMAControlImpl, 客户端默认 max_concurrent_transmission 为 64, 服务端在 src/common/serde/CallContext.cc 的 RDMATransmission::applyTransmission 里申请. 这一机制提高了端到端延迟, 换来的是数百台存储同时向一台客户端回数据时不出现 incast 拥塞.
2.4 chunk 引擎: 两套实现与 Rust 引擎的写法
仓库里有两套 chunk 存储. 旧的是 C++ 的 ChunkStore / ChunkReplica, 元数据默认放 LevelDB (src/storage/store/PhysicalConfig.h); 新的是 Rust 写的 src/storage/chunk_engine, 元数据放 RocksDB, 设计说明末尾一节描述的就是它. 每个 target 用哪套由 only_chunk_engine 决定, 代码默认值是 false, 但官方部署脚本 deploy/data_placement/src/setup/gen_chain_table.py 生成的建 target 命令都带 --use-new-chunk-engine, 按部署指南搭出的集群走 Rust 引擎. 社区文章里「元数据默认用 LevelDB」的说法对应的是旧路径.
Rust 引擎把物理空间分成 11 档, 从 64KiB 到 64MiB 按 2 的幂递增 (src/storage/chunk_engine/src/types/constants.rs). 每档每块盘 256 个数据文件, 空间按 group 管理, 一个 group 256 个块, 用 256 位位图记录占用; 分配器优先在活跃 group 里找空位, 没有就取一个已分配的 group, 再没有才同步 fallocate 一段新空间. 后台 allocate_thread 预分配, compact_thread 把稀疏 group 里的块搬走以回收空间. RocksDB 里有三张映射: chunk_id 到 chunk 元数据, group_id 到 group 状态 (用 RocksDB 的 MergeOp 原子更新), 物理位置到 chunk_id (给压缩线程反查用).
写入流程在 src/storage/chunk_engine/src/core/engine.rs 的 update_chunk: 先校验数据的 CRC32C, 比较链版本 (更低则 ChainVersionMismatch), 再比较更新版本号, 小于等于已提交版本返回 ChunkCommittedUpdate, 跳号返回 ChunkMissingUpdate. 若写入覆盖已有范围, 或追加后超过当前块的容量, 走 copy_on_write: 分配新块, 读旧数据, 合并新数据, 写到新块; 纯追加且块容量够时走 safe_write, 原地写到块尾. 新 chunk 先挂进 writing_list 并持久化一条「写中」记录, commit_chunk 时再用一个 WriteBatch 原子地更新 chunk 元数据和新旧块的占用状态, 刷新内存缓存. 进程重启时 occupy_uncommitted_positions 把写中记录对应的块重新占住并标记为中止, 避免空间泄漏. 代价是随机覆盖写会放大: 改 4KiB 要读写整个 chunk, 对读多写少的负载可以接受, 对小块随机更新不友好.
3. 控制面: 元数据, 成员管理与恢复
3.1 FoundationDB 上的 inode 与目录项
元数据只有两种核心记录. inode 的键是前缀 INOD 加 64 位 inode id, 值里存属主, 权限, 时间戳, 以及按类型不同的字段: 文件存长度, chunk 大小, 链范围和 shuffle 种子; 目录存父目录 id 和默认 layout; 符号链接存目标路径. 目录项的键是 DENT 加父目录 id 加名字, 值是目标 inode id 和类型, 同一目录下的条目在键空间里连续, 列目录就是一次范围读. 全部键前缀列在 src/common/kv/KeyPrefix-def.h, 除这两种外还有 mgmtd 的节点信息, 链表, 配置, 以及 meta 的幂等记录 (IDEM) 和文件会话等.
inode id 单调递增, 键却按小端序编码 (src/fbs/meta/Common.h 的 InodeId::packKey). FoundationDB 按键的字典序切分区间分给存储进程, 大端序下新分配的 inode 全落在同一区间, 写入集中在一台机器上; 小端序把变化最快的低位放在最前, 相邻 id 的键分散到整个键空间. 元数据操作全部包在 FoundationDB 的事务里: 只读事务服务 stat, lookup, listdir; 读写事务服务 create, link, unlink, rename. FoundationDB 用读写键集合做冲突检测, 冲突时 meta 自动重试, 所以多台 meta 可以并行处理请求. 目录 rename 要防止把目录移进自己的子树, meta 从目标目录一路向上查祖先, 默认目录深度上限 max_directory_depth 为 64 (src/meta/base/Config.h).
3.2 文件会话, 文件长度与动态 stripe
本地文件系统删除一个打开中的文件时, 要等所有 fd 关闭才真正释放, 为此必须跟踪 fd. 训练作业启动时会一次打开大量文件, 若都登记会压垮 meta 和 FoundationDB, 所以 3FS 只给写方式打开的 fd 建会话, 只读 fd 不跟踪. 删除仍有写会话的文件时, meta 推迟删除到会话结束; 离线客户端留下的会话由 meta 定期检查存活后清理. 文件数据的回收交给后台 GC, 默认 gc_file_delay 为 5 分钟, 可用空间低于 5% 时取消延迟立即回收 (src/meta/base/Config.h). README 的 KVCache 图里, GC 删除操作每隔一两分钟出现一次约 1 MIOPS 的尖峰, 就是这条回收路径.
文件长度采用最终一致. 写入时客户端定期把每个写打开文件的最大写入位置报给 meta, 位置超过 inode 里的长度且没有并发 truncate 时就更新长度; close 或 fsync 时 meta 向存储查每条链的末尾一个 chunk, 算出精确长度. 设计说明写的上报周期是 5 秒, 开源代码 FUSE 侧 periodic_sync 默认 30 秒, 每轮最多 1000 个 inode, 实际间隔再乘 0.7 到 1.3 的随机系数 (src/fuse/FuseConfig.h). 多台 meta 同时改同一文件长度会事务冲突, 所以长度更新任务按 inode id 分派给固定的一台 meta, 实现在 src/meta/components/Distributor.cc 的 Distributor::getServer, 用 Weight::select 在在线 meta 中按权重哈希选择.
精确长度要查每条链, 生产环境 stripe 为 200, 小文件也查 200 条链很浪费. 设计说明给出的优化是在 inode 里记一个「可能用到的链数」, 初值 16, 文件写到更多链时翻倍, 查长度和删除时只查这么多条. 开源配置里这个功能默认关闭: meta 端 dynamic_stripe 默认 false, 初值 16, 增长因子 2, configs/meta_main.toml 也写 false. 自建集群如果沿用大 stripe, 小文件的 close 与删除会比 DeepSeek 生产环境慢.
3.3 心跳, 租约与链状态机
故障检测靠心跳. mgmtd 在 heartbeat_fail_interval (默认 60 秒, 即设计说明里的 T) 内收不到某服务的心跳就宣布它故障; 服务一侧若 T/2 联系不上 mgmtd 就停止服务并退出. 这个不对称保证了被判死的服务一定已经自己停下, 不会出现 mgmtd 已把它移出链, 它还在接写请求的情况. 服务若发现自己某个 target 的公开状态是 lastsrv 或 offline, 也立即退出, 因为这说明它可能被网络分区隔开了.
每个 target 有本地状态 (up-to-date, online, offline, 由服务在心跳里上报) 和公开状态 (serving, syncing, waiting, lastsrv, offline, 随链表下发). mgmtd 定期扫描每条链, 按转移表计算新的公开状态, 实现是 src/mgmtd/service/updateChain.cc 的 generateNewChain. 代码先按 SERVING, LASTSRV, SYNCING, WAITING, OFFLINE 的顺序重排链成员, 再做转移, 其中两条规则比设计说明的表更严: 只有「链上有 SERVING 且没有 SYNCING」时, 才把排在最前的一个 WAITING 或 OFFLINE 成员提升为 SYNCING, 所以一条链同一时刻最多一个成员在同步; 所有 SERVING 同时离线时, 只有排第一的变成 LASTSRV, 它是唯一可能持有最新数据的副本, 其余进 OFFLINE. 链有任何变化, 链版本加一, 写请求里的链版本对不上就被拒绝, 这是第 2.2 节写路径第一步检查的来源. 2026-05-07 的最新提交 #413 修的正是「链表版本必须单调递增」.
3.4 数据恢复与恢复期间的流量均衡
target 重新上线后, 服务先等最新链表把它的所有 target 都标为 offline 才开始发心跳, 确保每个 target 都走一遍恢复. 恢复以「整 chunk 替换写」为单位: 前驱先发 dump-chunkmeta 拿到后继的全部 chunk 元数据 (id, 链版本, 已提交和待定版本号), 和本地比对后决定传哪些; 只在本地有的传, 只在远端有的删, 本地链版本更大的传, 链版本相同但本地已提交版本不等于远端待定版本的传. 传输时逐 chunk 加锁, 读出链版本, 版本号和内容, 发整 chunk 替换写, 再解锁, 全部传完发 sync-done. 同步期间新到的客户端写也被前驱改写成整 chunk 发给后继. 这套做法省掉了日志回放, 代价是恢复期间网络流量按 chunk 大小放大, 设计说明没有给出实测恢复速度.
恢复期间还有一个读负载问题. 链上一个副本故障后, 它的读流量转到同链其他副本上; 如果每块 SSD 只和固定的两块 SSD 组链 (设计说明第一张表, A 只和 B, C 同链), A 故障时 B, C 各多扛一半, 立刻成为全系统瓶颈, 而换盘加同步可能要几个小时. 解决办法是让每块 SSD 和尽可能多的 SSD 组过链, 设计说明把它表述为平衡不完全区组设计 (BIBD). 仓库的求解器在 deploy/data_placement/src/model/data_placement.py, 用 Pyomo 建整数规划, HiGHS 求解, 以任意两节点之间的「对等流量」上下界相等为目标. 设计说明的第二张示例表并没有做到均衡: 按表计算, A 故障时 D 接走 30%, E 只接 10%, 合格的设计应让每对节点恰好同链 次.
式中 是节点 (或 SSD) 数, 是链数, 是每条链的副本数, 是每块 SSD 上的 target 数, 是任意两块 SSD 同时出现的链数. 部署指南的例子是 5 节点, 3 副本, 每盘 6 个 target, 求解器输出 , 每对节点之间的对等流量都是 1.5. 恢复路径上也有已知问题: issue #345 报告重同步中途再次离线的 target 不能自动回到 serving, 加上一条链只允许一个 SYNCING, 卡住的成员会挡住同链其他成员的恢复; 2026-03 的 #403 修了同步期间 truncate 与 extend 操作的处理.
4. 客户端: FUSE 与 USRBIO 的取舍
4.1 FUSE 路径的三个上限
FUSE 客户端的门槛最低, 多数应用直接用挂载点读写. 它的第一个上限是请求速率: 内核 FUSE 把请求放进一个自旋锁保护的共享队列, 用户态守护进程从中取请求, 锁争用使吞吐不随线程数增长, 设计说明的实测是每秒约 40 万次 4KiB 读, 合 , 不到一块 200Gbps 网卡的十分之一. 第二个上限是单次请求大小: 3FS 把 FUSE 连接的 max_read / max_write 设成 io_bufs.max_buf_size, 默认 1MB (src/fuse/FuseConfig.h). 第三个是写并发: Linux 5.x 的 FUSE 对同一文件的写持有 inode 锁, 同一文件不能并发写, 应用只能同时写多个文件来提高总吞吐.
FUSE 侧也做了一些弥补. 只读打开且启用读缓存时走内核页缓存, max_readahead 默认 16MB; 写入经守护进程里的写缓冲合并 (write_buf_size 1MB). 虚拟目录 3fs-virt 承载了文件系统接口表达不了的操作: 在 3fs-virt/rm-rf/ 下建符号链接即请求 meta 递归删除目标目录, get-conf / set-conf 用来读写配置, iovs/ 用于 USRBIO 的共享内存注册, 实现在 src/fuse/FuseOps.cc. smallpond 删除中间目录时就用 rm-rf 这个入口.
4.2 USRBIO 的结构
USRBIO 的数据结构仿照 io_uring: Iov 是用户进程与 FUSE 守护进程共享的一大块内存, 由守护进程注册给 IB 网卡, 读出的数据直接被 RDMA 写进来, 要写的数据由存储服务直接从这里 RDMA 读走; Ior 是一个小的共享环, 用户进程放提交项, 守护进程放完成项. 共享内存的交接借用文件系统完成: src/lib/api/UsrbIo.cc 的 hf3fs_iovcreate 在 /dev/shm 建文件, 再在挂载点 3fs-virt/iovs/ 下建一个符号链接, 链接名里编码共享内存 ID, block 大小, 读写方向, io_depth, 优先级和超时, 守护进程截获这次 symlink 调用后 mmap 同一块内存. 用户进程的 fd 由内核管理, 守护进程不知道它对应哪个 inode, 所以要先 hf3fs_reg_fd: 函数用 statx 取 inode, dup 一个新 fd 登记进表, 成功时返回 -dupfd, 失败返回正的错误码, 和其他函数的约定相反.
提交和完成都靠 IPC 信号量唤醒, 没有做轮询: 用户调 hf3fs_submit_ios 对信号量做一次 post, 守护进程的 watcher 线程等信号量 (带随机抖动的超时兜底) 后取提交项, 交给 ioRingWorker 协程查 inode, 查 Iov, 组成批量读写请求发往存储服务. 批的大小由 io_depth 控制: 0 表示不攒批; 正数表示攒够这么多个才发, 不看超时; 负数表示最多攒 个, 到 timeout 就发 (src/fuse/IoRing.cc). 2026-03-30 的 #404 修正了这里的超时判断. 正数 io_depth 适合每轮请求数固定的数据加载器, 请求数不确定时用 0 或负值, 否则末尾一批凑不满会一直等.
4.3 两条路径怎么选
USRBIO 换来的收益集中在小块随机读和大块顺序读两端. 小块随机读不再经过内核 FUSE 队列, 请求在守护进程里攒批后合成少量 RPC; 大块读不受 1MB 单次上限, 一次请求可以是 32MiB 甚至更大 (API 文档的示例就是 1024 个 32MiB 块). 数据从网卡直接进用户可见的内存, 用户态与内核态之间没有拷贝. 社区文章引用过「比 FUSE 快 3 到 5 倍」的说法, 仓库没有给出这个对比的测试条件; README 的峰值吞吐测试要求用 fio 的 USRBIO 引擎 (benchmarks/fio_usrbio/README.md), 说明官方数字都是零拷贝路径上的.
代价在接入成本和语义上. 应用要改代码: 管理 Iov 与 Ior 的生命周期, 注册 fd, 保证读写缓冲落在 Iov 内且不跨 block 边界, 一个环只能由一个线程提交, 一个线程收割. 元数据操作 (open, close, stat) 仍然经过 FUSE, 元数据密集的负载得不到加速. 存储节点内部也不是全程用户态: 存储服务读盘走内核 Direct IO, 没有用 SPDK 一类的用户态 NVMe 驱动, 零拷贝指的是客户端这一侧. 社区的 open3fs/smallpond-3fs 分支让 smallpond 的 DuckDB 引擎改走 USRBIO, 也从侧面说明上游 smallpond 只走 FUSE 挂载.
5. 性能数字的口径, 版本演进与局限
5.1 180 节点 6.6 TiB/s 读吞吐
README 的峰值吞吐测试用 180 台存储节点, 每台 2 块 200Gbps InfiniBand 网卡, 16 块 14TiB NVMe; 客户端 500 多台, 每台 1 块 200Gbps 网卡; 结果是「在训练作业背景流量存在的情况下」聚合读吞吐约 6.6 TiB/s. README 没有给出读块大小 (图注只写 large block), 副本数和压测持续多久, 也没有说 6.6 TiB/s 是否包含训练作业自己的那部分流量. 压测工具是仓库里的 fio USRBIO 引擎, 所以这是零拷贝客户端路径上的数字.
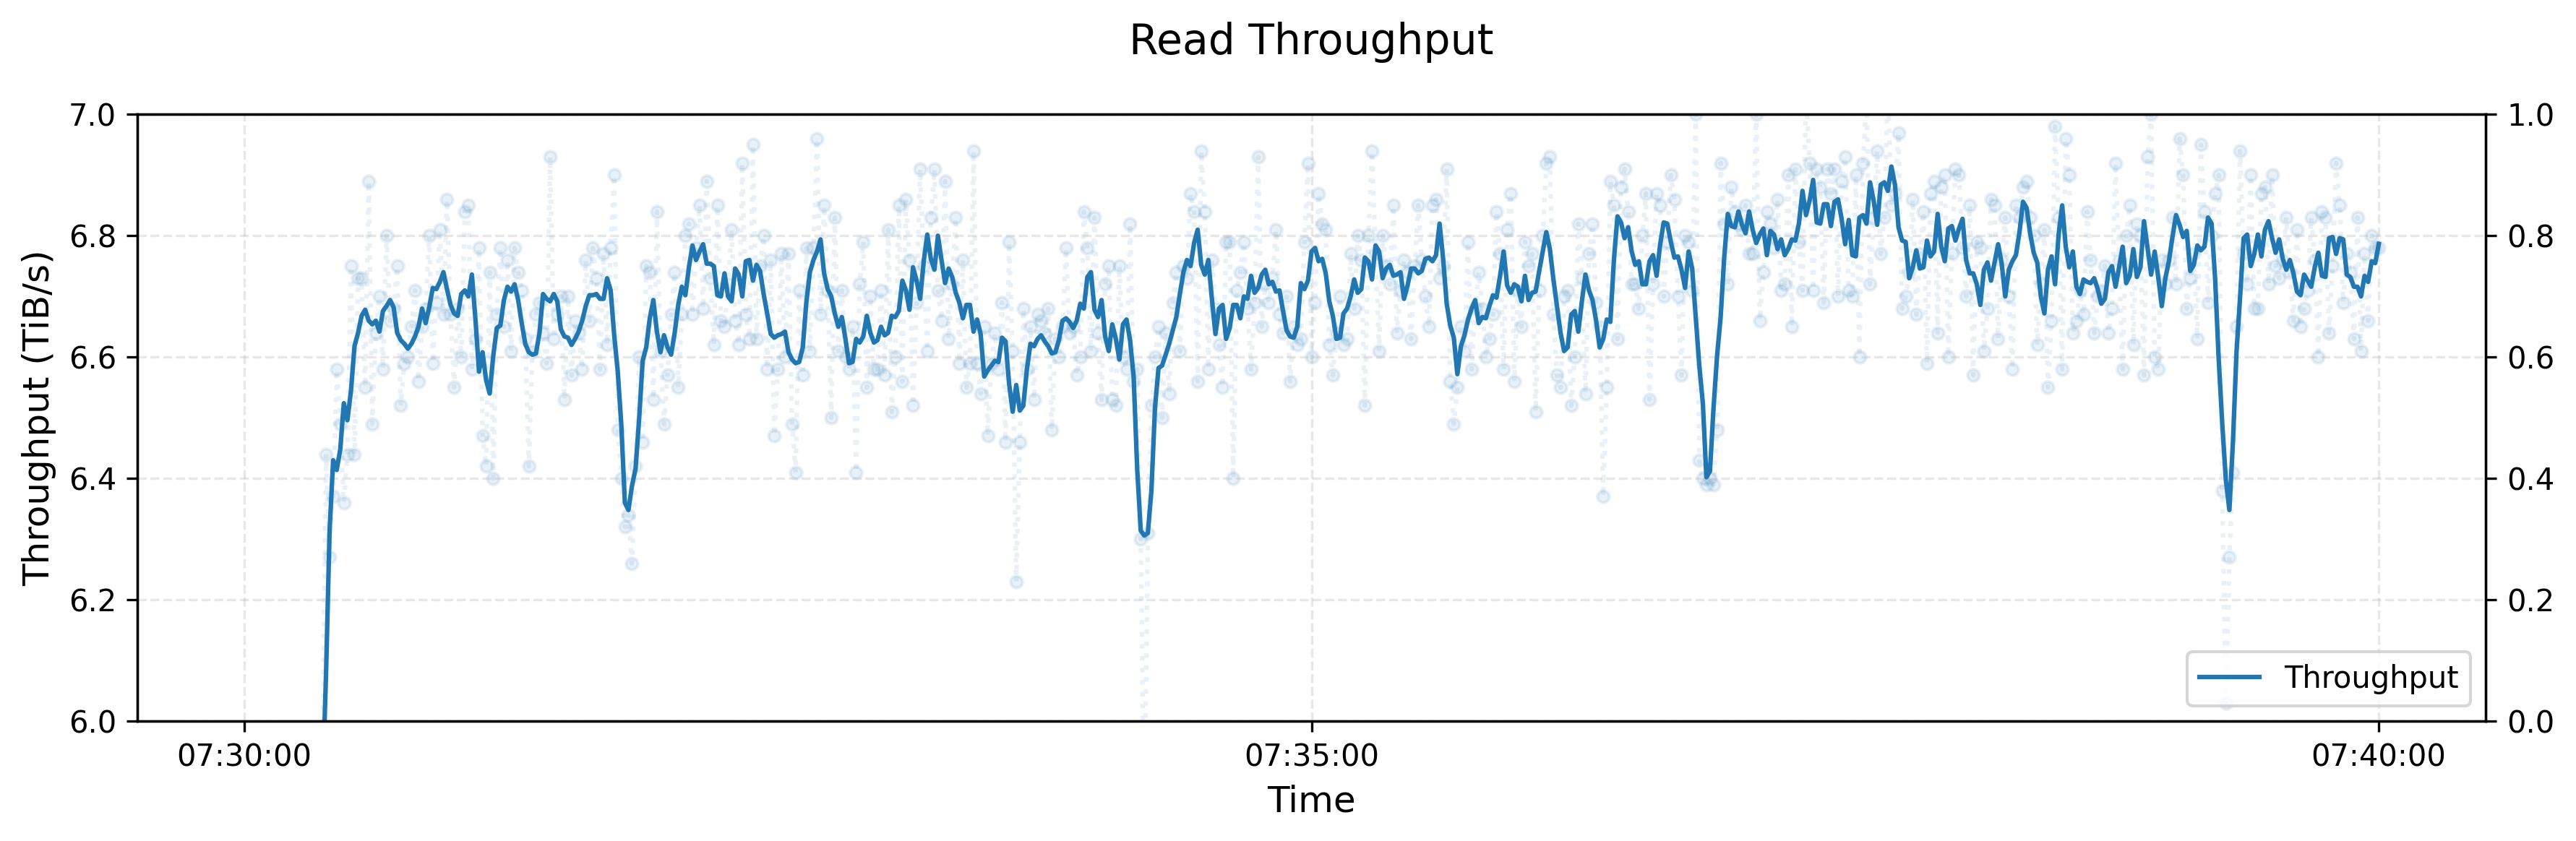
图注: 横轴是 07:30 到 07:40 的 10 分钟, 纵轴为 TiB/s, 浅色散点是采样值, 实线是平滑后的吞吐. 吞吐在开始后约半分钟爬到 6.6 TiB/s 上下, 之后在 6.5 到 6.9 TiB/s 之间波动, 后半段略高; 期间有四次明显下陷, 低点在 6.3 到 6.4 TiB/s, 每次持续十几秒. 图 1 解析: 横轴是 07:30 到 07:40 的 10 分钟, 纵轴为 TiB/s, 浅色散点是采样值, 实线是平滑后的吞吐. 吞吐在开始后约半分钟爬到 6.6 TiB/s 上下, 之后在 6.5 到 6.9 TiB/s 之间波动, 后半段略高; 期间有四次明显下陷, 低点在 6.3 到 6.4 TiB/s, 每次持续十几秒. 下陷的原因文档没有给出, 结合「有训练作业背景流量」这一说明, 较可能来自同时运行的作业 (例如 checkpoint 写入) 抢占了存储带宽.
把这个数字放回硬件上限里看. 存储侧网卡总量是 , 6.6 TiB/s 合 7.26 TB/s, 约占 81%; 平均到每台存储节点约 37.5 GiB/s. 每台 16 块 PCIe 4.0 NVMe 的顺序读合计远超 50 GB/s, 磁盘不是瓶颈, 网络才是. 客户端侧 500 台合计 12.5 TB/s, 每台平均只用了不到六成. Fire-Flyer 论文对同一批硬件给的是理论 9 TB/s, 实测 8 TB/s, 两者差别在口径: 论文的 8 TB/s 是峰值, README 的 6.6 TiB/s 是带背景流量时的持续值, 而且单位一个是 TB 一个是 TiB. 论文还提到 2880 块 SSD 以镜像冗余提供 20 PiB 以上的空间, 的裸容量除以 2 正好在 20 PiB 附近, 说明生产环境这批存储用的是两副本链, 设计说明里的三副本只是示例.
5.2 GraySort 110.5 TiB / 30 分 14 秒
GraySort 测试由 smallpond 驱动: 25 台存储节点 (每台 2 个 NUMA, 每个 NUMA 一个存储服务, 2 块 400Gbps 网卡), 50 台计算节点 (每台 192 物理核, 2.2 TiB 内存, 1 块 200Gbps 网卡), 110.5 TiB 数据排进 8192 个分区, 用时 30 分 14 秒, 平均 3.66 TiB/min. 算法分两阶段, 先按键的前缀位 shuffle 到分区, 再在分区内排序, 两阶段都读写 3FS. 脚本在 smallpond 的 benchmarks/gray_sort_benchmark.py, smallpond 侧的执行细节见 smallpond 技术解析.
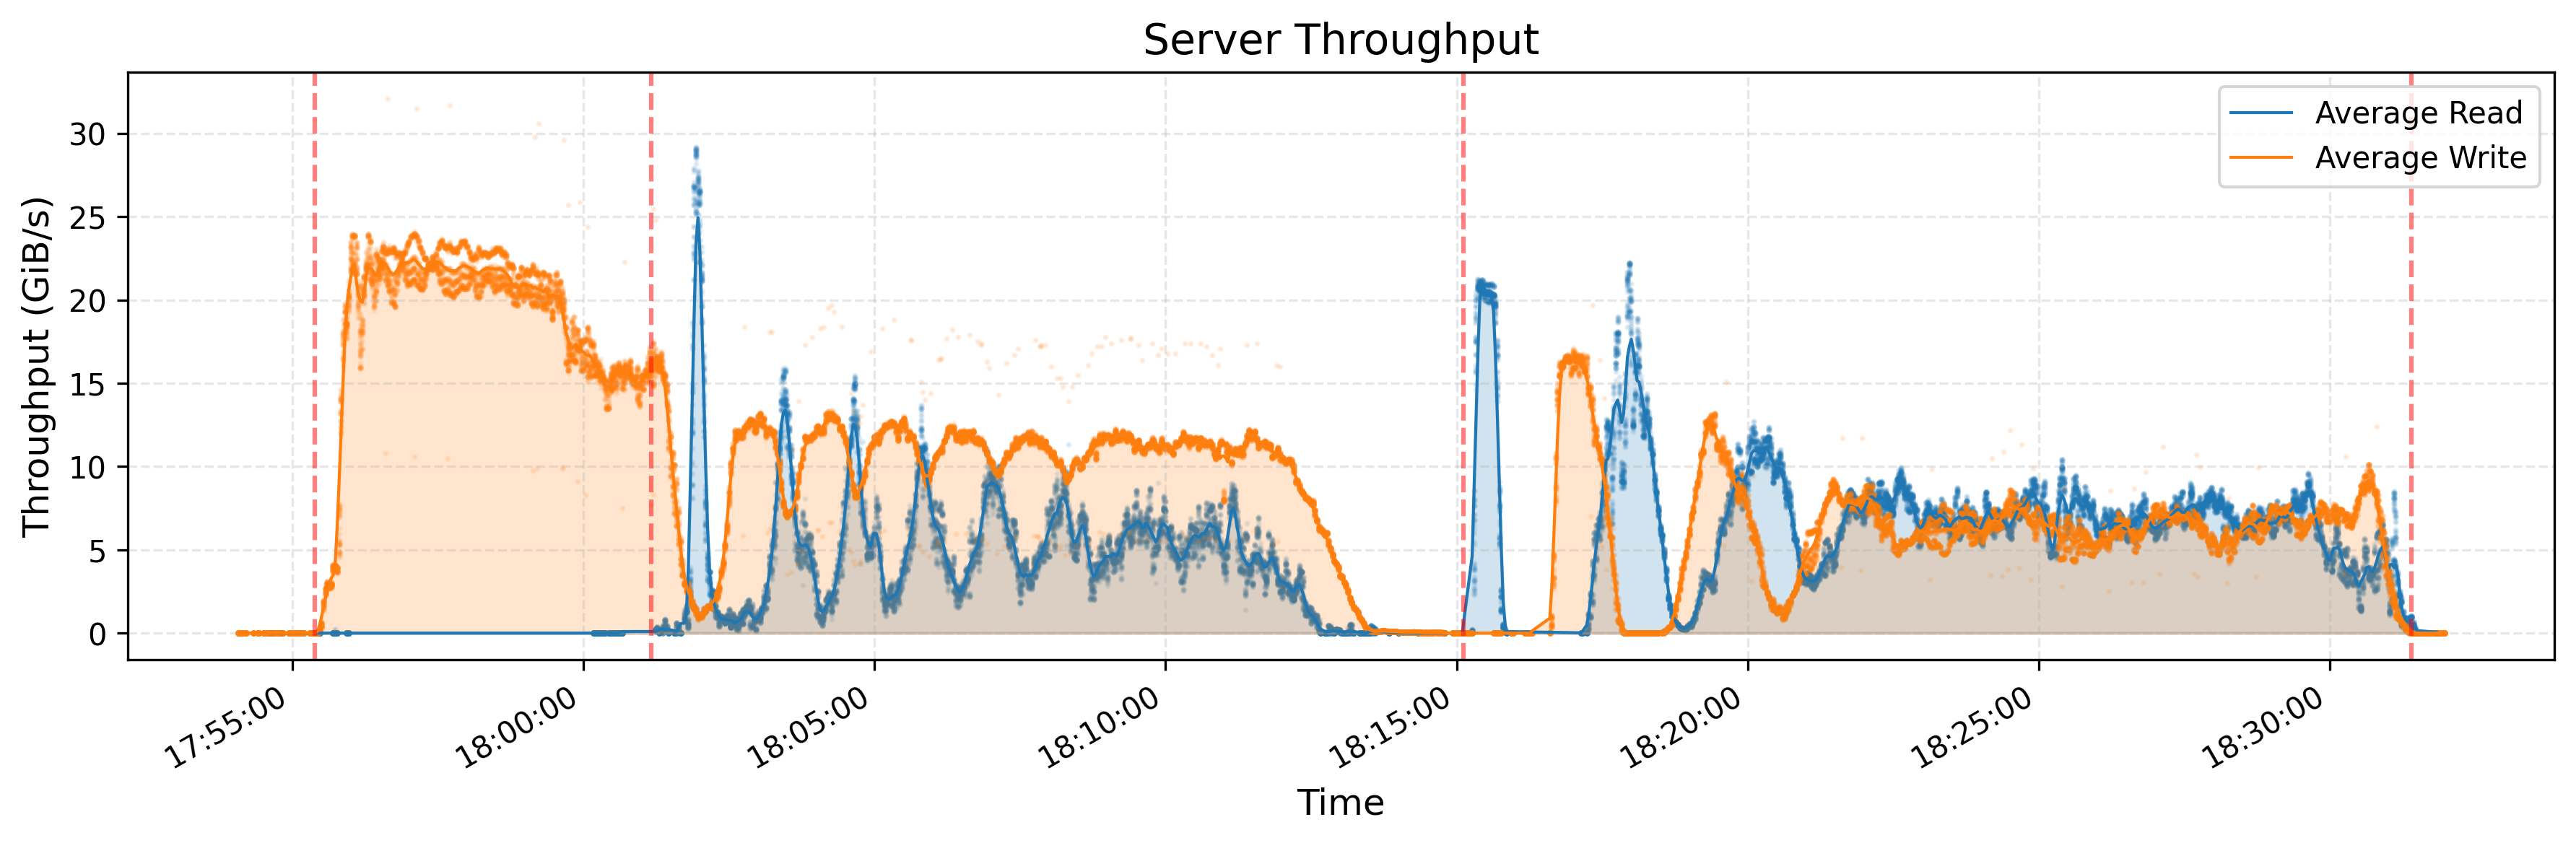
图注: 存储服务端每台的平均读 (蓝) 写 (橙) 吞吐, 单位 GiB/s, 四条红色竖虚线大约在 17:55, 18:01, 18:15, 18:31. 第一段只有写, 每台约 20 到 23 GiB/s, 形态是生成输入数据; 第二段 (18:01 到 18:15) 读写交替起伏, 对应 shuffle 阶段一边读输入一边写分区; 第三段 (18:15 到 18:31) 先有一阵读尖峰, 随后读写都稳定在 5 到 8 GiB/s, 对应分区内排序. 图 2 解析: 存储服务端每台的平均读 (蓝) 写 (橙) 吞吐, 单位 GiB/s, 四条红色竖虚线大约在 17:55, 18:01, 18:15, 18:31. 第一段只有写, 每台约 20 到 23 GiB/s, 形态是生成输入数据; 第二段 (18:01 到 18:15) 读写交替起伏, 对应 shuffle 阶段一边读输入一边写分区; 第三段 (18:15 到 18:31) 先有一阵读尖峰, 随后读写都稳定在 5 到 8 GiB/s, 对应分区内排序. 存储端写峰值约 22 GiB/s, 读峰值约 29 GiB/s, 都远低于每台 2×400Gbps 的网卡上限.
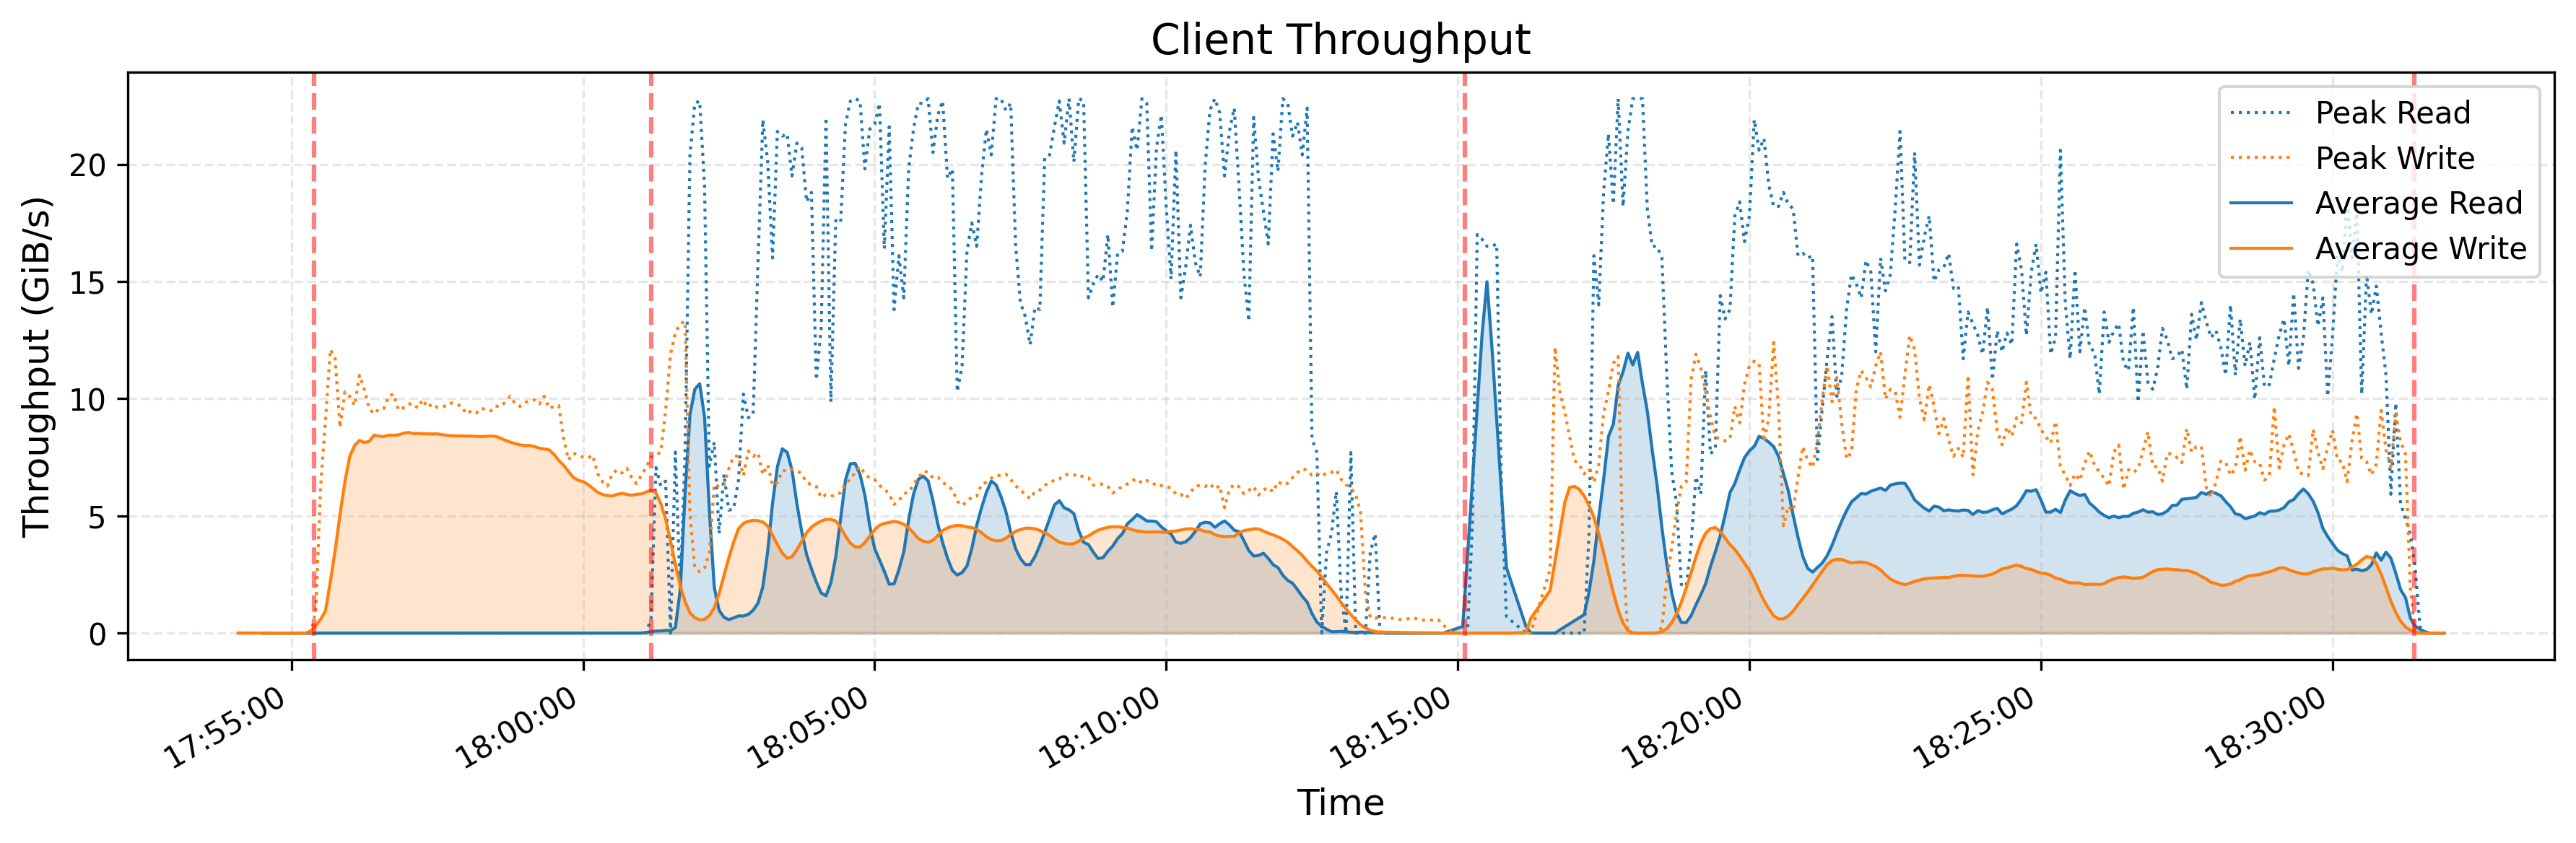
图注: 计算节点 (客户端) 的读写吞吐, 虚线是峰值, 实线是平均. 生成阶段每台平均写约 8 GiB/s; shuffle 阶段读的峰值贴近 22 GiB/s, 接近 200Gbps 网卡的 23.3 GiB/s, 平均读写各在 3 到 6 GiB/s; 排序阶段平均读约 5 GiB/s, 平均写约 2 到 3 GiB/s. 图 3 解析: 计算节点 (客户端) 的读写吞吐, 虚线是峰值, 实线是平均. 生成阶段每台平均写约 8 GiB/s; shuffle 阶段读的峰值贴近 22 GiB/s, 接近 200Gbps 网卡的 23.3 GiB/s, 平均读写各在 3 到 6 GiB/s; 排序阶段平均读约 5 GiB/s, 平均写约 2 到 3 GiB/s. README 没有说 30m14s 是否含生成数据, 从图上数, 18:01 到 18:31 约 30 分钟, 与 30m14s 吻合, 生成阶段的约 6 分钟不在计时内.
用这几张图可以核对 3.66 TiB/min. , 摊到 50 台计算节点每台每秒排序约 1.25 GiB 数据. 两阶段各读一遍, 写一遍, 客户端侧 IO 至少是数据量的 4 倍, 即 442 TiB, 平均每台客户端约 5 GiB/s, 约为网卡上限的 21%, 与图 3 的平均线一致. 社区有文章拿 62 GB/s 去比客户端网卡总量 1.25 TB/s 得出 5% 的利用率, 没有计入这 4 倍 IO. 以 sortbenchmark 的 Spark 2014 年记录作参照: 206 台 EC2 i2.8xlarge, 23 分钟排完 100 TB, 约 4.27 TB/min; 3FS 加 smallpond 的 110.5 TiB 合 121.5 TB, 30.2 分钟, 约 4.02 TB/min. 两者量级相同, 而后者用了更快的网络和更多的核, GraySort 本身说明不了 3FS 的优势, 它展示的是 smallpond 这种「每个分区一个 DuckDB 进程, 中间数据全落共享存储」的简单架构能在 3FS 上跑到这个量级.
5.3 KVCache 读吞吐与 GC: README 的 KVCache 图给的是所有 KVCache 客户端的读吞吐, 每台客户端 1 块 400Gbps 网卡, 峰值最高 40 GiB/s; 下图是同一时段 GC 删除操作的 IOPS. 网卡规格在 2025-03-03 的 PR #58 才补进 README. 文档没有给出客户端台数, KV 块大小, 命中率和读取的 token 数.
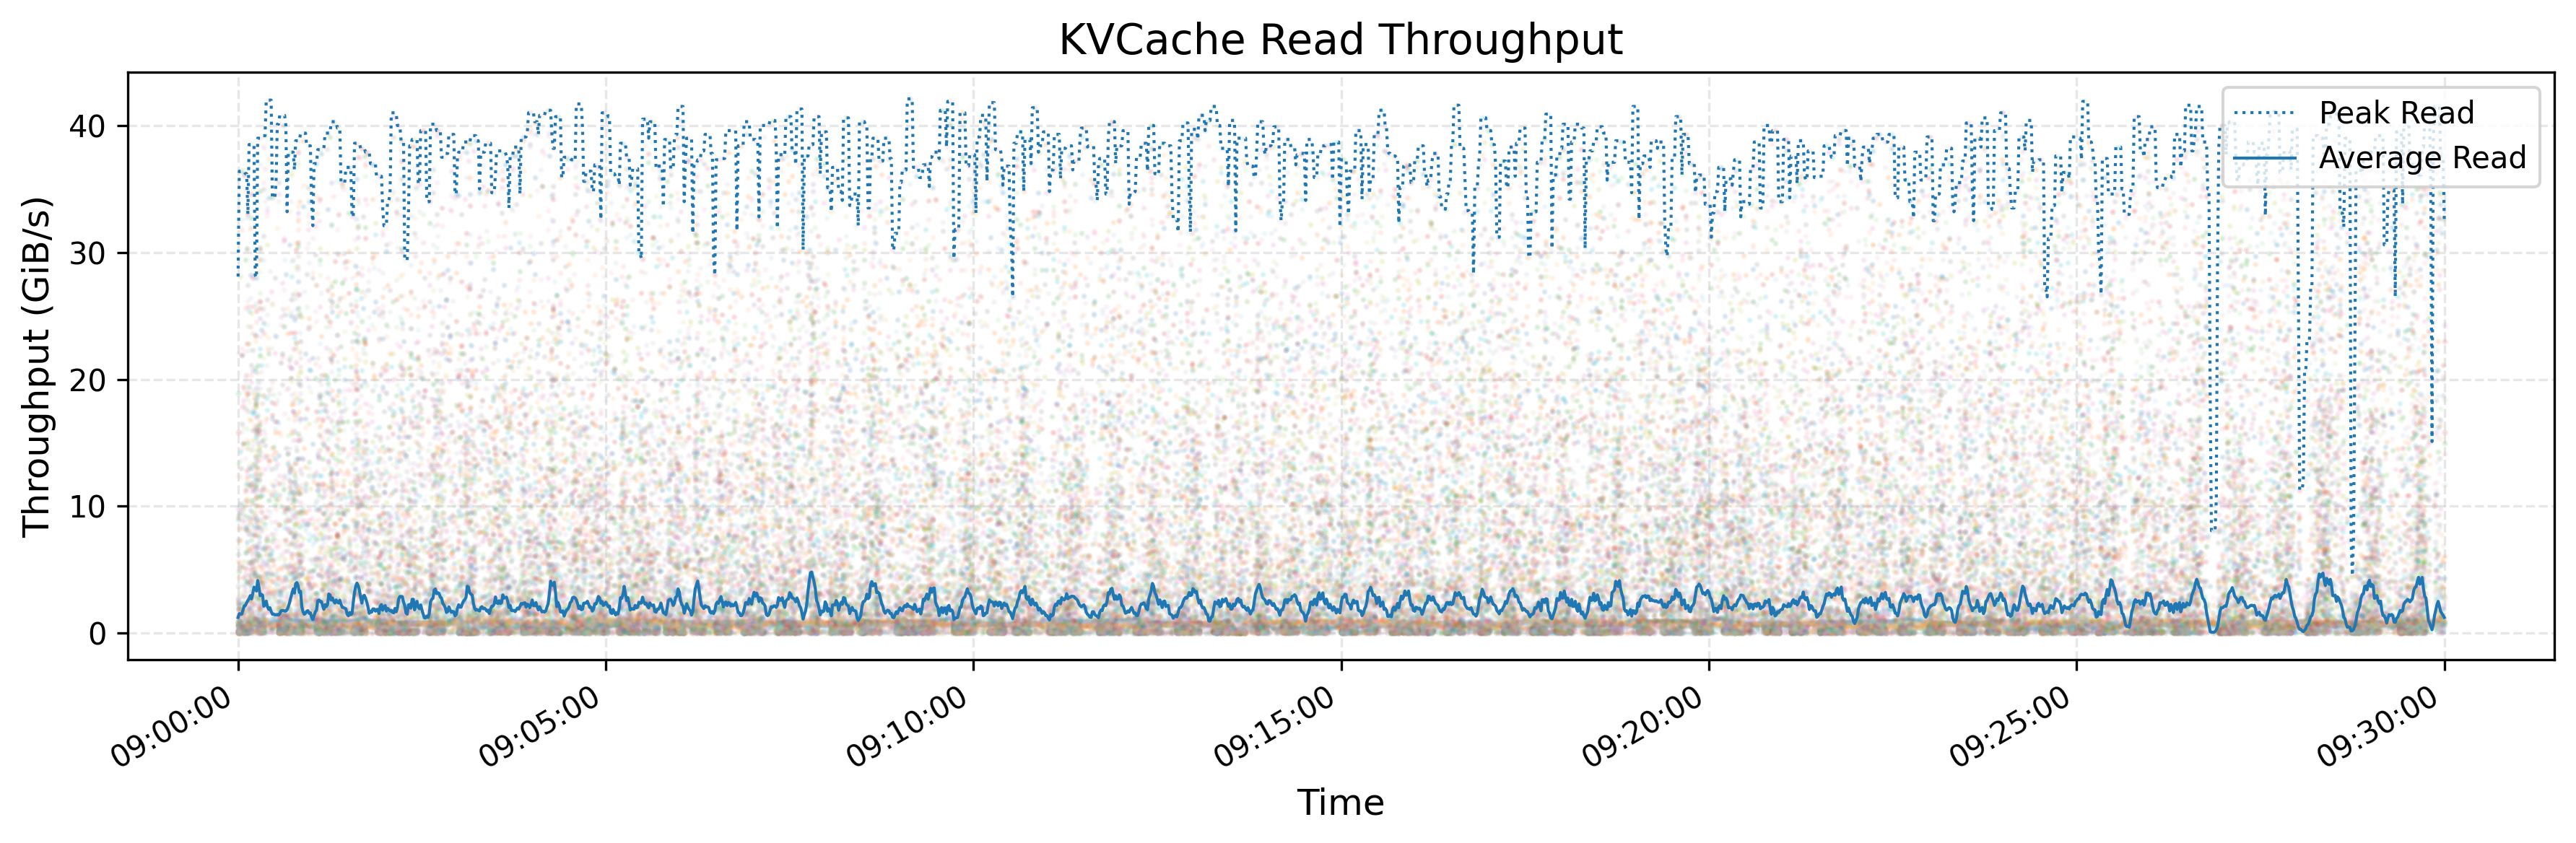
图注: 09:00 到 09:30 的半小时, 纵轴 GiB/s. 虚线是各时刻所有客户端中的最高值, 多数时间在 35 到 41 GiB/s; 实线是客户端平均值, 只有 2 到 3 GiB/s; 背后的彩色散点是单台客户端的采样. 图 4 解析: 09:00 到 09:30 的半小时, 纵轴 GiB/s. 虚线是各时刻所有客户端中的最高值, 多数时间在 35 到 41 GiB/s; 实线是客户端平均值, 只有 2 到 3 GiB/s; 背后的彩色散点是单台客户端的采样. 峰值线接近 400Gbps 网卡的 , 约 86%, 说明单台客户端可以把网卡读满; 平均值低一个数量级, 说明 KVCache 读取是突发的, 多数客户端多数时间在等计算.
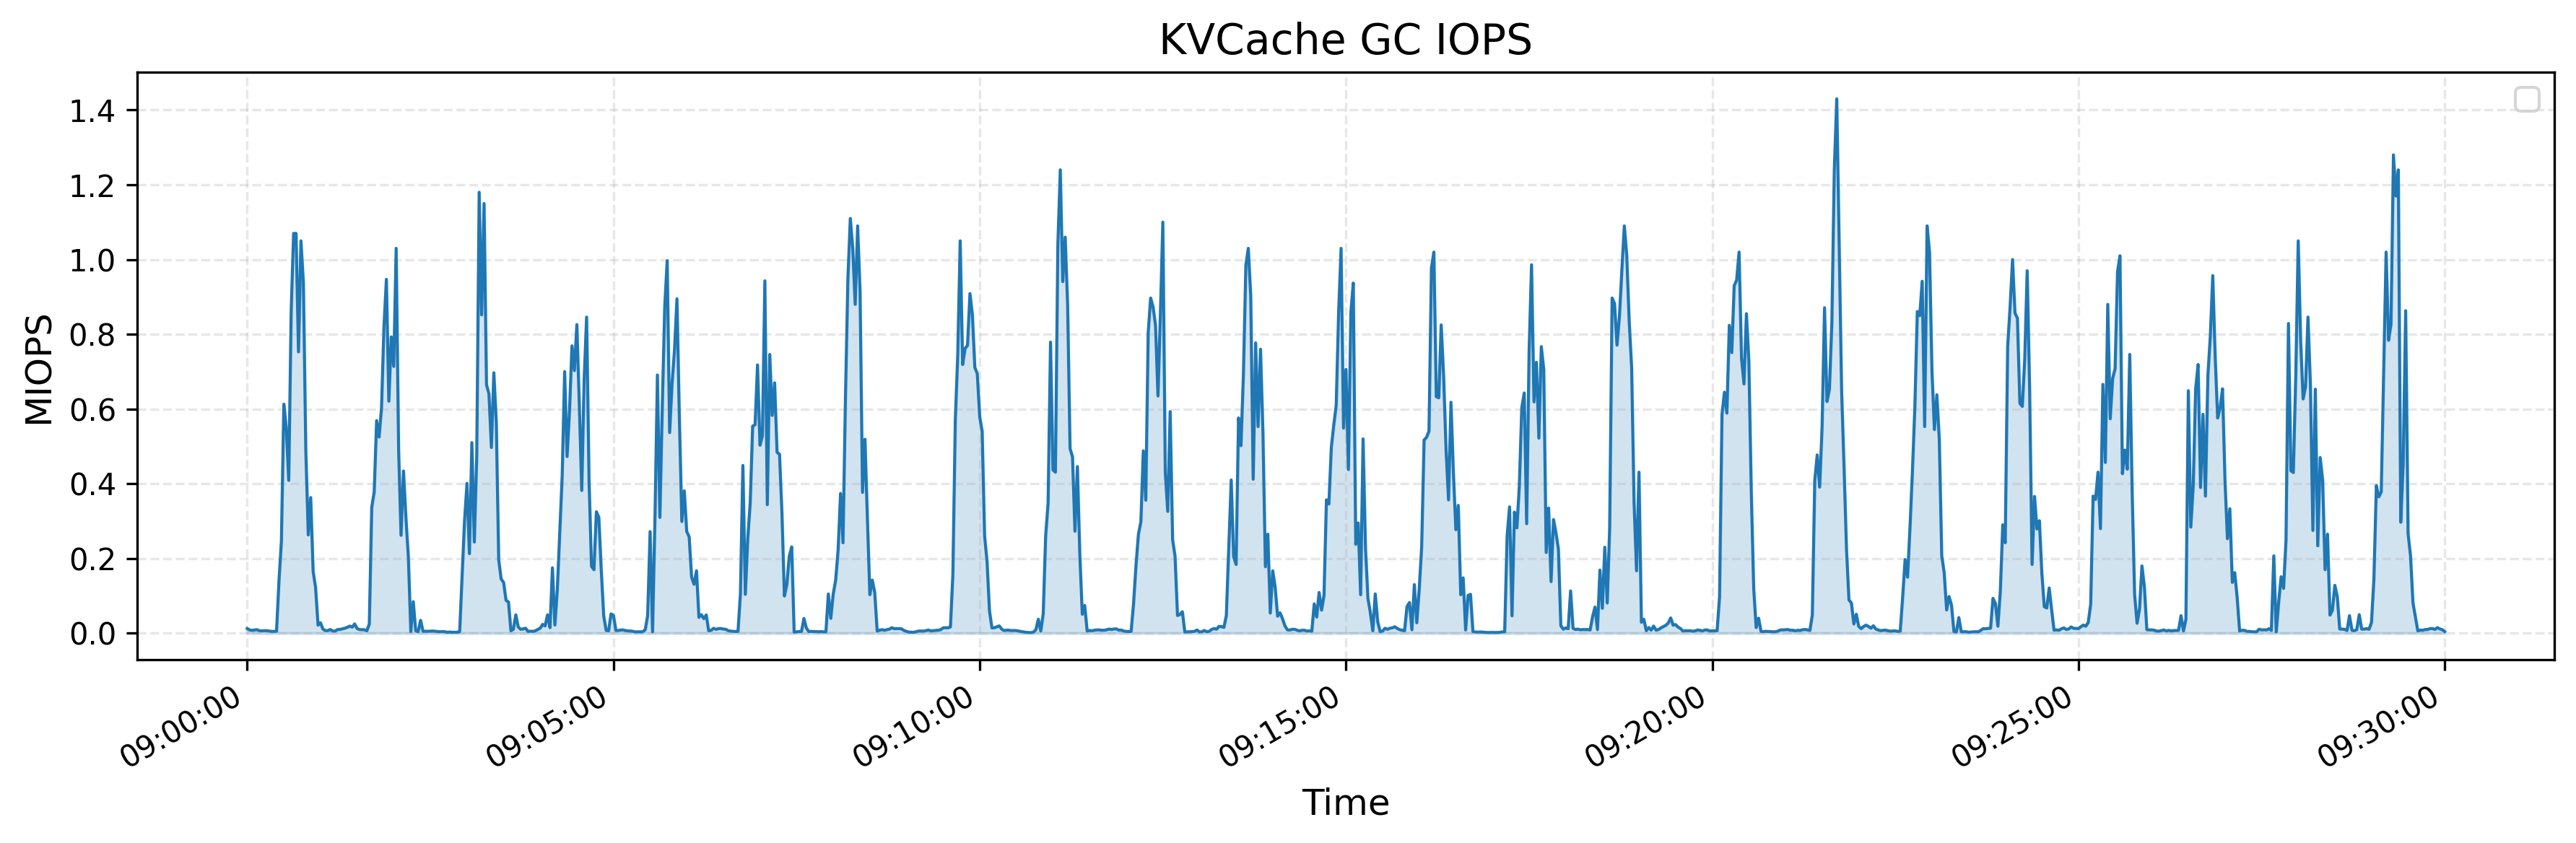
图注: 同一时段 GC 删除操作的 IOPS, 单位百万次每秒. 删除以脉冲形式出现, 半小时内约 22 次, 平均间隔约 80 秒, 每次峰值 0.8 到 1.4 MIOPS, 两次脉冲之间接近 0. 图 5 解析: 同一时段 GC 删除操作的 IOPS, 单位百万次每秒. 删除以脉冲形式出现, 半小时内约 22 次, 平均间隔约 80 秒, 每次峰值 0.8 到 1.4 MIOPS, 两次脉冲之间接近 0. KVCache 的条目寿命短, 过期后成批删除, 这张图说明 meta 和存储的删除路径能承受百万级的批量删除而不拖累读.
把吞吐换成 token 数需要每个 token 的缓存大小, 文档没有给出. 若按 DeepSeek-V3 的 MLA 缓存推算 (见 DeepSeek-V3 技术解析): 61 层, 每层每 token 存 512 维压缩 KV 加 64 维 RoPE key, 按 BF16 存放, 每 token 字节, 约 68.6 KiB. 40 GiB/s 的峰值对应单台客户端每秒约 61 万 token 的前缀, 2.5 GiB/s 的平均值约 3.8 万 token. 这条推算只依赖模型结构, 实际存储格式 (是否 FP8, 是否按页对齐) 文档没有给出.
5.4 版本演进: 仓库没有发版 tag, 演进只能看提交. 113 个提交大致分四段, 列在下面.
- 2025-02 到 2025-03: 开源后的头一个月以构建与平台适配为主, 包括 fio USRBIO 引擎 (#62), arm64 / aarch64 支持, CentOS, openEuler, OpenCloudOS, TencentOS 的构建镜像, 以及 README 补充 KVCache 客户端网卡规格.
- 2025-04 到 2025-08: Rust chunk 引擎的一致性修复集中出现, 包括 meta 缓存与 meta 存储的写入顺序 (#252), 批量删除越界与不一致 (#256, #326), 删除与压缩的竞态导致元数据损坏 (#322), 移动与提交 chunk 的不一致 (#325, #329).
- 2025-09 到 2025-10: 放宽批量读对链版本和公开状态的检查 (#341, #346), 修复一次性客户端造成的连接泄漏 (#356).
- 2025-12 到 2026-05: 确定性 shuffle 与
-DSHUFFLE_METHOD(#369), IoRing 批处理超时判断 (#404), 同步期间 truncate 与 extend 的处理 (#403), 链表版本单调递增 (#413).
设计说明自发布后只改过错别字和格式, README 的性能数字从未更新. 2025 年 5 月补了指标文档 docs/metrics.md (#282). 修复的分布说明, 开源时最不成熟的是 Rust chunk 引擎的并发与崩溃一致性, 而链复制协议和元数据层的改动很少.
5.5 局限与代码和文档的出入: 3FS 的设计取向很明确: 读密集, 大文件, 有 RDMA 和全闪存硬件. 由此带来的局限主要有五条.
- 硬件门槛: 存储与客户端都要 RDMA 网卡, 存储节点要 NVMe 全闪, 公有云常规实例难以复现 README 的数字; 部署还要单独运维一套 FoundationDB.
- 写路径: 链式复制让写延迟随链长线性增加, 同一 chunk 的写在链头串行, Rust 引擎的覆盖写需要读改写整个 chunk, 小块随机更新代价高.
- 小文件与元数据: 元数据每次操作都是一次 FoundationDB 事务, 小文件的 close 和删除还要查多条链, 动态 stripe 在开源配置里默认关闭.
- 客户端: USRBIO 要改应用代码, 元数据操作仍经 FUSE; Linux 5.x 上 FUSE 不能对同一文件并发写.
- 恢复: 整 chunk 替换写简化了恢复, 代价是恢复流量放大, 而且一条链一次只能同步一个成员, 已有 issue 报告恢复卡住的情形.
代码与文档的出入集中在六处. 第一, 设计说明说读到同时有已提交和待定版本的 chunk 会返回特殊状态码, 这只在旧 C++ 存储路径成立, Rust 引擎直接返回已提交版本. 第二, 状态转移表允许多个成员同时 syncing, generateNewChain 限制每条链最多一个. 第三, 文件长度上报周期文档写 5 秒, FUSE 默认 30 秒. 第四, 动态 stripe 被写成生产做法, 开源 meta 默认关闭. 第五, 恢复期间流量均衡的示例表并不均衡, D 与 E 分到的流量相差三倍. 第六, 写路径的幂等去重 (channel 与 seqnum) 和链头 checksum 比对在文档里没有出现, 而 chunk ID 也比文档多了 2 字节 track 字段.