材料是论文 DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference (arXiv 2602.21548, v2 日期 2026-02-26, 17 页), 作者来自北京大学, 清华大学和 DeepSeek-AI, 第一作者 Yongtong Wu 同时署北大与 DeepSeek-AI; 署清华的 Mingxing Zhang 也是 Mooncake 论文的作者之一. 系统实现在 DeepSeek 的内部推理框架上, 改动约 5K 行, 存储后端是 3FS, kernel 用 FlashMLA, DeepGEMM 和 DeepEP. DualPath 本身没有开源代码. 逐段对照见 DualPath 对照译稿.
论文要解决的问题很具体: Agent 多轮推理里, 每轮只追加几百个 token, 却要把前面几万 token 的 KV cache 从存储读回 GPU. 在 prefill-decode 分离 (PD 分离) 的部署里, 读盘只由 prefill 节点做, 每个节点只有一块 400Gbps 的存储网卡, 这块网卡先被打满, GPU 在等数据; 同一集群里 decode 节点的存储网卡几乎不用. DualPath 的改动是让 decode 节点也去读, 读到的 KV 再经计算网络转给 prefill 节点. 下文按瓶颈成因, 数据通路, 带宽约束, 隔离与调度, 实验口径的顺序展开, 最终与 Mooncake 等方案对照.
1. 瓶颈从哪来: Agent 负载把 prefill 变成读盘任务
1.1. 命中率 98.7% 对应多少字节和多少 FLOPs
论文的 trace 来自 DeepSeek 生产环境的 Agent RL 训练, 任务是在沙箱里修代码仓库的已知 bug (附录 A.3). 表 2 给出三份数据集, 各 500 条轨迹. 最长的一份 (MaxLen 64K) 平均 157 轮, 每轮平均追加 429 个 token, 生成 176 个 token, 平均上下文 32,721 个 token. 每轮 prefill 的输入是「全部上下文 + 新追加」, 其中上下文部分在上一轮已经算过 KV, 只需读回; 新追加的 429 个 token 才要真正计算. 命中率因此是 . 另两份数据集 MaxLen 32K 和 48K, 平均轮数 60 和 106, 追加 608 和 474 个 token.
论文用 cache-compute 比衡量这种负载对存储的压力: 每轮要加载的 KV 字节数除以本轮需要的计算量, 单位 GB/PFLOP. 正文说 DeepSeek-V3.2 在这份 trace 上约为 22 GB/PFLOP, 表 1 列出 16K 到 64K 上下文下五个模型的范围. 论文没有写分子分母各算了什么, 但按公开配置可以复算出来. 分子取上下文 个 token 的 KV 字节, 分母取追加 个 token 的前向 FLOPs:
DeepSeek-V3.2 的主 KV 按 FlashMLA 的 FP8 布局, 每 token 每层 656 字节 (512 维 FP8 潜变量, 4 个 FP32 缩放因子, 64 维 BF16 的 RoPE 部分), 61 层合计 KB. 每个新 token 的计算分三块: 线性层按激活参数约 GFLOPs; DSA 主注意力每个 query 只看 top-2048 个 token, 按 MLA 吸收形式每层约 GFLOPs, 61 层约 35 GFLOPs; lightning indexer 对全部上下文打分, 每层 , 32.7k 上下文时 61 层约 33 GFLOPs. 代入得 GB/PFLOP, 16K 和 64K 处分别是 12.2 和 35.1, 与表 1 的 13-36 一致. Qwen2.5-32B 按 GQA 的 8 个 KV 头, 头维 128, 64 层, FP16 存放, 每 token 256KB, 同样算法给出 115.8 到 265.4, 对应表 1 的 117-267. 两个模型都对得上, 说明表 1 的口径是「追加长度固定为 429, V3.2 不计 indexer 的 key cache」. 把 indexer 每 token 每层 132 字节也算进分子, V3.2 在 32.7k 处是约 26 GB/PFLOP. 这一复算是从公开配置推出的, 论文没有给出.
1.2. 稀疏注意力让这个比值随长度上升
表 1 里 DeepSeek-V3 的比值在 4.8 到 5.8 之间, 几乎不随长度变, V3.2 却从 13 涨到 36. 差别来自注意力的计算形状. V3 的 MLA 是稠密注意力, 每个新 token 的注意力 FLOPs 随上下文线性增长, 要读的 KV 也随上下文线性增长, 两者之比在长上下文下趋于常数, 这正是论文 §9 说的「稠密注意力的计算与 KV 之比是常数」. V3.2 的 DSA 把主注意力限制在 top-2048 个 token 上, 主注意力计算不再随上下文增长, 只剩 indexer 那一项随长度线性增加, 而 indexer 每个 token 每层的计算远比主注意力便宜. 结果是上下文越长, 每 FLOP 要搬的 KV 字节越多. DSA 的机制见 DeepSeek-V3.2 技术解析.
这个对比有一个容易忽略的后果: 模型侧降计算的改动, 会把压力转移到 I/O 上. V3.2 的 KV 字节数与 V3 相同 (都是 MLA 的 576 维潜变量), 但计算少了, 同样的 GPU 每秒能处理的新 token 更多, 每秒要读的 KV 字节也就更多. 后续的 V4 与 V4.1-Flash 继续压缩 KV 体积, 把持久化 KV 缩到 V4 的 1/8, 并把 KV 分层放在 HBM, 主机内存和 SSD 上, 见 DeepSeek-V4.1-Flash 解析. 那是从字节数一侧减压, DualPath 是从带宽一侧扩容, 两者针对的是同一个比值的分子和分母. KV 容量的通用计算方法见 KV 缓存: 容量计算, 调度与压缩边界.
1.3. 一个节点只有一块存储网卡
论文 §2.3 以 DGX SuperPOD 为参照描述硬件: 每个节点 8 块 Hopper GPU, 每块 GPU 配一块 400Gbps 计算网卡 (CNIC, 东西向), 整个节点另有一块最高 400Gbps 的存储网卡 (SNIC, 南北向). 计算网络与存储网络物理隔离. 实验集群与此相同, 只是 8 块 CNIC 接 InfiniBand, SNIC 接 3FS (§7.2). 换算成字节, 一个节点的存储读带宽上限约 50 GB/s, 计算网卡合计约 400 GB/s, 差 8 倍. 按 1.1 节的数, V3.2 一个 32.7k 上下文的请求要读约 1.31GB, 一块 SNIC 每秒最多读完约 38 个这样的请求, 而一个 8 卡 prefill 节点的算力远不止于此.
图 3 左把这个问题放到硬件演进上: 2020 到 2024 年, GPU 稠密算力涨了 28.8 倍, 网卡与 PCIe 带宽只涨了 2.0 倍, HBM 容量涨了 2.4 倍, 于是 I/O 与算力之比下降 14.4 倍 (). 28.8 这个数需要打折看: 它等于 , 0.3125 PFLOPS 是 A100 的稠密 BF16 峰值, 9 PFLOPS 是 B200 的稠密 FP4 峰值, 中间 2022 年约 2 PFLOPS 的点对应 H100 的稠密 FP8. 三个点各取当代最低精度, 涨幅里有一部分来自位宽从 16 降到 4, 论文没有注明. 结论方向不受影响, 14.4 倍是偏大的上限. 图 3 右测的是另一件事: 每个请求 30K 上下文, 追加 300 token, batch 从 1 增到 20 时相对吞吐从 1 涨到约 3 倍, 说明 prefill 需要足够大的 batch 才能用满 Tensor Core, 而 HBM 容量限制 batch, 这是逐层 prefill 的动机.
1.4. PD 分离下谁去读
PD 分离把 prefill 和 decode 放到不同 GPU 上, prefill 计算密集, decode 受访存带宽限制, 分开后各自选并行方式, 互不干扰. 在带外部 KV 存储的版本里, 每轮的流程是: prefill 引擎 (PE) 从存储读回命中的 KV, 计算新追加 token 的 KV, 把完整 KV 经 RDMA 发给 decode 引擎 (DE); DE 解码, 每攒满一个块就把新 KV 写回存储. 读盘的只有 PE. SGLang 加 Mooncake 的开源实现也是这样: Mooncake 维护者在 issue #1860 里确认, SGLang 的 PD 模式下 D 节点从不直接读 Mooncake Store, 总是 P 节点读 (或重算) 后用 Transfer Engine 写给 D.
这样一来, 读带宽只取决于 prefill 节点数. 论文默认的 DS 660B 配置是 2P4D, 即 2 个 prefill 节点, 4 个 decode 节点; 6 块 SNIC 里只有 2 块在读盘, 总读带宽约 100 GB/s, 另外 200 GB/s 闲着. 把这 4 块也用上, 读带宽从 变成 , 2P4D 下是 3 倍, 1P1D 下是 2 倍. 剩下的问题是 decode 节点读到的 KV 怎么到 prefill 节点的 GPU 上: 论文观察到计算网络的流量是间歇的, 集合通信以亚毫秒级突发出现, 突发之间网卡空闲, 可以用来转运 KV. 图 1 用一句话概括了这一点: 现状是 prefill GPU 利用率 40%, 存储网卡 100%; 改动后 prefill 与 decode 两侧的存储网卡都在读, GPU 利用率到 80%. 图 1 是示意图, 40% 和 80% 没有对应的实验测量.
2. 两条路径的数据流
2.1. 逐层 prefill 与两种块布局
DualPath 建立在逐层 prefill 之上. 长上下文 prefill 时, 整个 batch 的 KV 都要进 HBM, batch 大小因此受限; LayerKV 和 PrefillOnly 注意到第 层的注意力只需要第 层的 KV, 于是 KV 可以按层加载, 用完即释放, HBM 里只放一层. 有效 batch (按 token 计) 大约扩大到层数倍. 代价是 KV 被切成很多细块: 每层一份, 每块只含 个 token. 按 §4.1 举的 64 token 一块, 32.7k 上下文是约 511 个块, 乘 61 层约 3.1 万个单层块. 这是 §5.2 要比较拷贝提交开销的原因.
为了兼顾细粒度传输和存储对象数量, 论文定义两种块 (附录 A.5). Layer Block 是形状 的字节张量, 存若干 token 的单层 KV; Full Block 的形状是 , 存同一批 token 的全部层. 把 个 Layer Block 拼起来就是一个 Full Block, 不需要转换内存布局. 存储侧一律使用 Full Block, 并以 trie 组织, 让前缀相同的轨迹共享路径; GPU HBM 侧一律使用 Layer Block, 与逐层计算同步. DRAM buffer 位于两种粒度之间, 负责接收整块数据并按层切片发出.
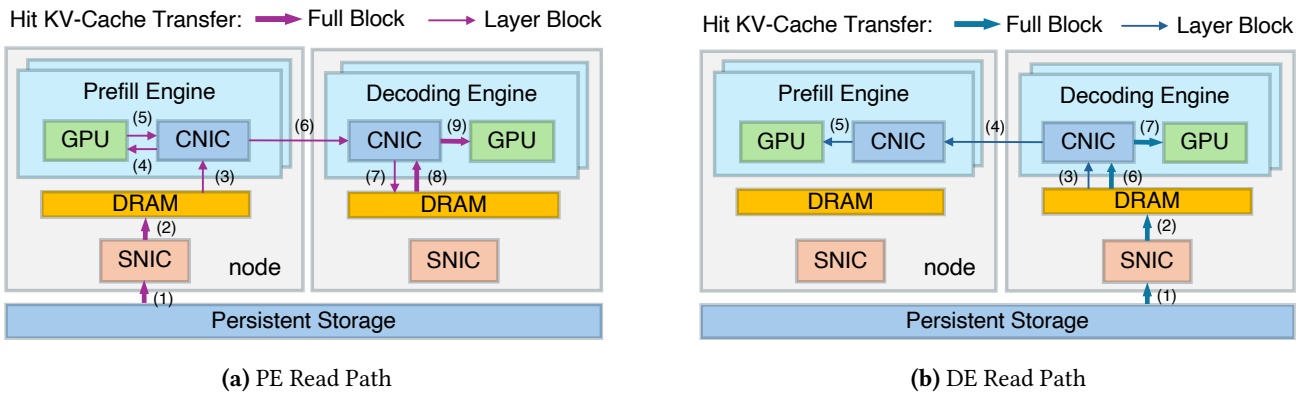
图 4: 双路径加载示意, 左 (a) 为 PE 读路径, 右 (b) 为 DE 读路径, 标出 Full Block 与 Layer Block 的流向 (原文 Figure 4).
图 4 解析: 左右两张子图画的是同一对 PE 节点与 DE 节点, 每个节点里有 GPU, CNIC, DRAM 和 SNIC, 底部是共享的持久存储 (实验中是 3FS). 粗箭头是 Full Block, 细箭头是 Layer Block, 数字是步骤编号. 左图 (a) 是 PE 读路径, 命中 KV 从 PE 的 SNIC 进来; 右图 (b) 是 DE 读路径, 命中 KV 从 DE 的 SNIC 进来, 经两个 CNIC 之间的 RDMA 送到 PE 的 GPU. 图里没有画调度器, 也没有画未命中 token 的 KV 怎样回到 DE (b 图中的 (4) 是双向箭头). 两张图里 GPU 与 DRAM 之间都经过 CNIC, 没有直连, 这是第 4.1 节「所有流量走 CNIC」的体现.
2.2. PE 读路径: 命中 KV 在 PE 节点上进出两次
PE 读路径对应图 4a 的九步. (1)(2) 命中 KV 以 Full Block 从存储经 PE 的 SNIC 读进 PE buffer. 计算某一层之前, (3)(4) 把这一层的命中 KV 从 PE buffer 经 CNIC 写进 PE 的 HBM; GPU 用它计算新追加 token 的注意力和这一层的新 KV. 这一层算完, (5)(6)(7) 把这一层命中与新算的全部 KV 从 PE 的 HBM 经两端 CNIC 发到 DE buffer. (3) 到 (7) 每层重复一次. 全部层完成后, DE buffer 里有了完整的 prompt KV, (8)(9) 由 DE 的 CNIC 把它从 DE buffer 写进 DE 的 HBM, 开始解码.
数一下命中 KV 经过哪些链路: 在 PE 节点上, 它被 PE 的 CNIC 从 DRAM 读出一次 (3), 写进 HBM 一次 (4), 又从 HBM 读出一次 (5); 在 DE 节点上, 它被 DE 的 CNIC 写进 DRAM 一次 (7), 读出一次 (8), 写进 HBM 一次 (9). 这一份数据在两台机器的 PCIe 上一共走了 6 趟, 在两台机器之间的网络上走了 1 趟. 第 3 节的带宽约束就是把这些趟数逐项加起来.
2.3. DE 读路径: 只有新 KV 回到 DE
DE 读路径对应图 4b. (1)(2) 命中 KV 以 Full Block 经 DE 的 SNIC 读进 DE buffer. PE 计算每一层时, (3)(4)(5) 由 DE 的 CNIC 从 DE buffer 读出这一层的命中 KV, 经网络发到 PE 的 CNIC, 写进 PE 的 HBM. 这一层算完, PE 只把未命中 token 的新 KV 发回 DE buffer, 与那里已有的命中 KV 合并. 全部层完成后, (6)(7) 由 DE 的 CNIC 把完整 KV 从 DE buffer 写进 DE 的 HBM.
与 PE 读路径相比, 命中 KV 少走了两趟: 它不经过 PE 的 DRAM, PE 也不用把它发回 DE, 因为 DE buffer 里本来就有. 命中 KV 在 DE 节点上被 DE 的 CNIC 读两次 ((3) 发往 PE, (6) 做 H2D), 写一次 ((7)); 在 PE 节点上被写进 HBM 一次 ((5)). 网络上命中 KV 只走 DE 到 PE 一个方向, 反方向只有新 KV, 按 98.7% 的命中率不到总量的 2%. 这条路径的代价落在 DE 节点上: DE 的 CNIC 和内存要多承担一份读出流量.
2.4. DE buffer 的用处与代价
两条路径都让 KV 先进 DE 的 DRAM, 再整体 H2D 进 HBM. 论文承认这多了一次 H2D, 给 DE 的 DRAM 和 CNIC 增加压力, 用 GPUDirect RDMA 把 KV 直接写进 DE 的 HBM 本可省掉. 保留 DE buffer 的理由是 HBM 占用: 在这类负载里, 生成长度很短 (每轮平均 176 token), TTFT 在请求总时间里占比不小; 如果 KV 一边 prefill 一边直接写进 DE 的 HBM, 这部分 HBM 在整个 prefill 期间都被占着却不解码. 先放在 DRAM, 等 prefill 完成再分配 HBM, DE 的 HBM 只用于正在解码的请求.
prefill 时间有多长, 可以从图 15 的千卡离线实验看到: 任务前期 TTFT 在 10 到 27 秒之间. 而解码 176 个 token, 按在线实验约 30 到 50 毫秒的 TPOT, 只要 5 到 9 秒. 如果在 prefill 期间就占住 DE 的 HBM, 每个请求占用 HBM 的时间会是实际解码时间的两三倍. decode 期间, DE 每攒满一个块 (例如 64 token) 就把新 KV 立即写回存储, 下一轮这条轨迹的 prefill 就能命中. 论文没有给出写回走哪条链路的带宽分析, 第 3 节的式子也没有计入写回流量; 按每轮生成 176 token 对比读回 32.7k token, 写回量不到读量的 1%.
3. 不引入新瓶颈的条件: 式 (1) 到 (9)
3.1. 符号与每对 GPU 的流量
§4.2 用一组不等式回答一个问题: 让 DE 节点也读盘之后, 新增的转运流量会不会把 CNIC 或 DRAM 变成新的瓶颈. 记号如下: 和 是 PE 和 DE 的节点数, 每节点 块 GPU, 每块 GPU 配一块带宽为 的 CNIC; 每个节点的 SNIC 带宽是 , 即一块 SNIC 相当于 块 CNIC; 每节点内存带宽为 . 分析假设读盘流量均匀摊到所有 SNIC 上, 每块都满速, 只计命中 KV, 忽略新算的 KV, decode 写回和模型自身的通信.
在这个假设下, PE 节点合计每秒读进 字节, 均匀发往 块 PE GPU 与 块 DE GPU 组成的每一对, 每对的流量是
来自 PE 读路径, 来自 DE 读路径. 一块 PE GPU 的 CNIC 面对 个 DE 对端, 一块 DE GPU 的 CNIC 面对 个 PE 对端, 下面每个约束都是「某个方向上经过的趟数 × 对端数 × 每对流量 ≤ 链路带宽」. 这里 CNIC 的读和写指的是它经 PCIe 从本机内存或 HBM 取数据和往里放数据, 环回 H2D 同时占读和写.
3.2. 四个约束逐项对应图 4 的箭头
PE 节点的 CNIC 读出命中 KV 有两处, 都在 PE 读路径上: (3) 从 PE buffer 读出, (5) 从 HBM 读出发往 DE. 写入也有两处: PE 读路径的 (4) 写进 HBM, DE 读路径的 (5) 写进 HBM. 于是
第一式化简后是 . 论文 §4.2 写成 , 条件放宽了一倍. 实验使用 , , 同时满足两个条件, 因此这处推导差异不会改变该组实验的可行性.
DE 节点的 CNIC 读出: DE 读路径的 (3) 发往 PE 和 (6) 做 H2D 各一次, 加上 PE 读路径的 (8) 一次; 写入: PE 读路径的 (7) 写进 DE buffer 和 (9) 写进 HBM 各一次, 加上 DE 读路径的 (7) 一次. 由此
内存带宽方面, PE 节点的 DRAM 只服务 PE 读路径, 被 SNIC 写入一次, 被 CNIC 读出一次, 合计 . DE 节点的 DRAM 服务自己读的数据 (SNIC 写入一次, CNIC 读出两次, 共 ), 再服务从 PE 发来的数据 (写入一次读出一次, 按节点平摊为 ), 合计 .
3.3. 区间, 边界与没有算进去的流量
代入实验平台的数: , , GB/s, GB/s. PE 写入约束给出下界 ; DE 读出约束给出 , DE 写入约束给出 , DE 内存约束 也给出 . 区间是 , 上界由 DE 的 CNIC 写入和 DE 的内存带宽同时决定. 论文的实验配置 2P4D, 1P1D, 1P2D 以及图 8 扫过的 1P1D 到 2P1D 都落在区间里. 区间的上界说明一件事: PE 节点数相对 DE 越多, 每个 DE 节点要转运的 PE 读路径流量越大, DE 的 CNIC 写入最先吃紧. 所以 DualPath 适合 decode 节点不少于 prefill 节点的部署, 而 Agent 负载生成短, prefill 重, 实际配置的 往往不会太大.
这组约束有几处没有覆盖. 其一, 它假设两条路径的流量严格按 SNIC 带宽均分, 实际由调度器按队列长度逐请求选路 (第 4.2 节), 流量分配有波动, 图 13 测到的存储网卡最大/平均比在有调度时是 1.184, 不是 1. 其二, 它只看节点内的 CNIC 和 DRAM, 没有看存储集群的总带宽: 能不能读出来, 取决于 3FS 集群的规模和 SSD 数量, 实验里 3FS 关闭了 DRAM 缓存, 所有读都打到 SSD 上, 论文没有给出 3FS 集群的配置. 其三, CNIC 上原有的模型流量 (EP 的 all-to-all, PD 之间的 KV 转发) 不在式子里, 论文的处理是用第 4.1 节的优先级隔离, 让 KV 只用模型流量剩下的带宽. 3FS 单客户端的读带宽实测见 3FS 解析 中的 KVCache 一节.
4. 流量隔离与调度
4.1. 所有 GPU 进出流量都绕道 CNIC
DualPath 多出来的转运流量与模型推理的集合通信共用 CNIC. 推理时 EP 的 all-to-all 在每层都要做, 对延迟敏感, 被 KV 流量挤占就会直接拉长 TPOT 和 TTFT. 论文 §5.1 的做法是把所有经过 GPU 的数据都交给 CNIC 搬运, 包括本机 DRAM 与 HBM 之间的拷贝: H2D 和 D2H 不用 GPU 的 copy engine, 改为 CNIC 的 RDMA 环回, 由 CNIC 从 DRAM 读出再写进同一节点的 HBM. 这样所有流量都在 CNIC 一个点上排队, 可以用网卡的 QoS 统一管. 如果 KV 走 copy engine 或 GPUDirect Storage, 它会直接上 PCIe,…6 tokens truncated…17 tokens truncated…efill 前向往往包含多个请求, 前一种开销会直接加到 TTFT 上. 这个换算是按论文给的单次开销乘块数得到的, 论文没有给出整请求的提交耗时.
代价是 PCIe 流量翻倍. 环回 H2D 时, 数据先从 DRAM 经 PCIe 进 CNIC, 再从 CNIC 经 PCIe 进 GPU, 同一份数据过两次 PCIe, 而 copy engine 只过一次. 第 3 节的约束里 CNIC 的读和写分开计算, 正是在计入这一点; §4.2 还假设每对 GPU 与 CNIC 挂在同一个 PCIe switch 下, 环回流量不出 switch. 论文没有测 PCIe 链路本身的利用率, 也没有给出开关 VL 隔离前后 TPOT 的对比, 隔离效果只能从在线实验的 TPOT 达标间接看出.
4.3. 引擎间调度: 用 token 数代替时间
调度分三层: 跨引擎选 PE 和 DE, 选读路径, 引擎内组 batch. 引擎对应一块 GPU, 同一节点的引擎编为一组, 组内 rank 0 作为 leader 与中心调度器通信. 每个引擎上报三个量: 是引擎上的请求数, 是引擎上尚未处理完的 token 数, 是所在节点存储网卡上待读的字节数. 论文用 token 数估计计算负载, 用待读字节估计 I/O 负载, 不直接测量耗时.
请求先进中心调度器的等待队列. PE 选择在某个 PE 组来取任务时触发, 按 FIFO 逐个分配 (算法 1), 把组内引擎分成三类: 的过载引擎 C1 不接新请求; 剩下的按所在节点读队列分成 的 C2 和 的 C3. 新请求优先给 C2 中 最小的引擎, C2 为空才看 C3, 两类都空就结束这次取任务. 优先 C2 的理由是读队列短的节点如果接不到新请求, 存储网卡会闲下来. 取存储网卡 3 秒能读完的 token 数, 取一块 GPU 5 秒能处理的 token 数, 都事先测定 (附录 A.4).
DE 选择分两级, 不保持全局 FIFO. 第一级在 DE 组来取任务时把全局队列清空, 每个请求分给 最小的组, 进入该组的私有队列. 第二级先按组内剩余 HBM 总量 (假设没有碎片) 从私有队列头部数出最多能放下的请求集合 , 算阈值 ; 然后逐个弹出队头, 在 HBM 够用的 DE 里, 优先选 的那些中 最小的, 这一类为空时选其余 DE 里 最小的, 所有 DE 的 HBM 都不够就结束. PE 和 DE 定下之后, 比较两者所在节点的读队列, 哪边短就从哪边读. 一个请求只走一条路径, 把同一请求拆到两条路径上读被列为未来工作.
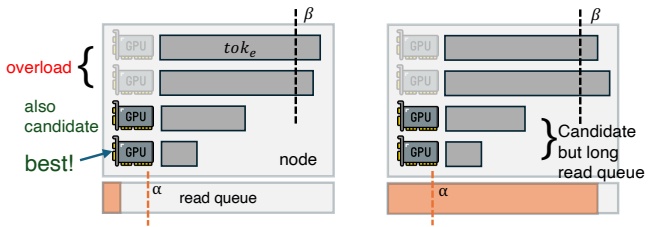
图 5: 引擎间 PE 调度示意, 横条为各引擎未处理 token 数, 下方为节点存储网卡读队列 (原文 Figure 5).
图 5 解析: 两个方框各是一个节点, 每行一块 GPU, 横条长度是该引擎的 , 竖虚线是 ; 方框下方的橙色条是该节点存储网卡的读队列, 竖虚线是 . 左边节点读队列短于 , 横条越过 的两块 GPU 标为过载, 另两块是候选, 其中 最小的标为最佳. 右边节点读队列长于 , 两块未过载的 GPU 只是次选. 图注说明八块 GPU 同属一个 PE 组. 图中没有画 DE 选择与读路径选择.
4.4. 引擎内调度: 计算配额与 DP attention 的空泡
PE 内部的问题来自 DP attention. 大 MoE 模型推理时, 注意力按数据并行切, 每块 GPU 处理自己的一批请求; 之后 MoE 层用 EP, 所有 GPU 要做 all-to-all, 必须同步. 如果各 GPU 上的注意力计算量差别大, 快的 GPU 在 all-to-all 前等慢的, 形成空泡. Agent 负载里请求的上下文长度从几千到 6 万多 token 不等, 每个请求的注意力时间与上下文长度相关, 按请求数均分会有明显不均.
论文的做法是给注意力层的预计执行时间设上限, 称为计算配额, 实验中 DualPath 与 Oracle 都取 300 毫秒 (附录 A.4). 每个请求在一次前向里用一对数 描述: 是已有 KV 的 token 数 (来自存储命中或之前的前向), 是本次要算 KV 的 token 数. 由这些数算出注意力层的理论计算量, 再用事先拟合的「计算量到耗时」关系估计执行时间. 组 batch 时按 FIFO 往里加请求, 只要预计时间不超过配额就继续; 加某个请求会超时, 就对它的 做二分查找, 找到能塞进剩余配额的 , 这个请求走 chunked prefill. 图 6 右对比了用配额前后的 GPU 时间线, 图 14 是对应的实测. 300 毫秒乘 61 层约 18 秒, 与图 15 中 10 到 27 秒的 TTFT 量级相符. DE 不做引擎内调度, 所有请求都放进前向 batch. MoE 推理里 DP attention 与 EP 的组合方式见 MoE 推理部署.
5. 实验口径与结果
5.1. 硬件, 模型, trace 与基线
测量条件集中在 §7.2 和附录 A. 硬件是 InfiniBand 互联的 GPU 集群, 每节点 8 块 Hopper GPU, 双路 CPU, 8 块 400Gbps CNIC 和 1 块存储网卡; 3FS 集群关闭了内部 DRAM 缓存, 单节点能读满 400Gbps. 论文没有说是 H800 还是 H100, 也没有给 3FS 集群的节点数和 SSD 数. 模型有三个: DS 660B 即公开的 DeepSeek-V3.2, 带 DSA; DS 27B 是内部的缩小版, 结构相近, 附录 A.2 给出 30 层, 隐藏维度 2560, 72 个路由专家, indexer top-k 1024; Qwen 32B 即 Qwen2.5-32B, 稠密 GQA. 默认配置是 DS 660B 用 2P4D, DS 27B 用 1P1D, Qwen 32B 用 1P2D; DS 模型用 EP 加 DP attention. 每节点给 KV 分配的 DRAM, DualPath 在 DS 模型上是 80GB, 在 Qwen 上是 320GB.
负载是 1.1 节的三份生产 trace, 回放时工具调用耗时按零处理, 前一轮结束立刻发下一轮. 基线有三个. Basic 是未修改的内部框架, 只有 PE 读盘, 也没有逐层 prefill. Oracle 在 DualPath 基础上跳过所有读盘, D2H 和 H2D 以及 PD 之间的 KV 传输, 代表零 I/O 的上限. SGL(MC) 是 SGLang (commit 19089aa) 加 HiCache, 以 Mooncake Store 为分布式缓存, 3FS 为后端, Mooncake Transfer Engine 做 PD 传输, 每节点用 1.5TB DRAM. 论文自己说明 SGL(MC) 与 DualPath 实现差异大, 比较不公平, 加速比只对 Basic 报告; Qwen 上 SGL(MC) 用 TP=8, DualPath 用 DP. 离线指标是全部轨迹跑完的作业完成时间 (JCT); 在线指标是 TTFT, TTST (第二个 token 的时间) 和 TPOT, SLO 是 TTFT 不超过 4 秒, TPOT 不超过 50 毫秒.
5.2. 离线 rollout: 1.87 倍里有多少来自双路径
离线场景对应 RL 训练的 rollout: 个 agent 同时开始, 测全部结束的时间. 图 7 按模型分三行, 按 MaxLen 分三列, 横轴是 agent 数. 摘要里的 1.87 倍出自 DS 660B, 64K, 2048 个 agent 这一格: Basic 约 10,100 秒, DualPath 约 5,400 秒. 同一列里 512 个 agent 时 Basic 约 2,900 秒, DualPath 约 2,100 秒, Oracle 约 2,000 秒; 4096 个 agent 时 Basic 约 19,500 秒, DualPath 约 10,400 秒, Oracle 约 9,400 秒. agent 越多, 读盘压力越大, 加速比越高. DS 660B 上 DualPath 与 Oracle 的差距在 10% 上下, 32K 列 4096 个 agent 时 DualPath 甚至略快于 Oracle, 说明测量本身有几个百分点的波动. DS 27B 和 Qwen 32B 上 DualPath 比 Oracle 慢 1.09 到 1.85 倍, 原因是 1P1D 和 1P2D 只有两三块存储网卡, 小模型算得快, 存储带宽仍然不够.
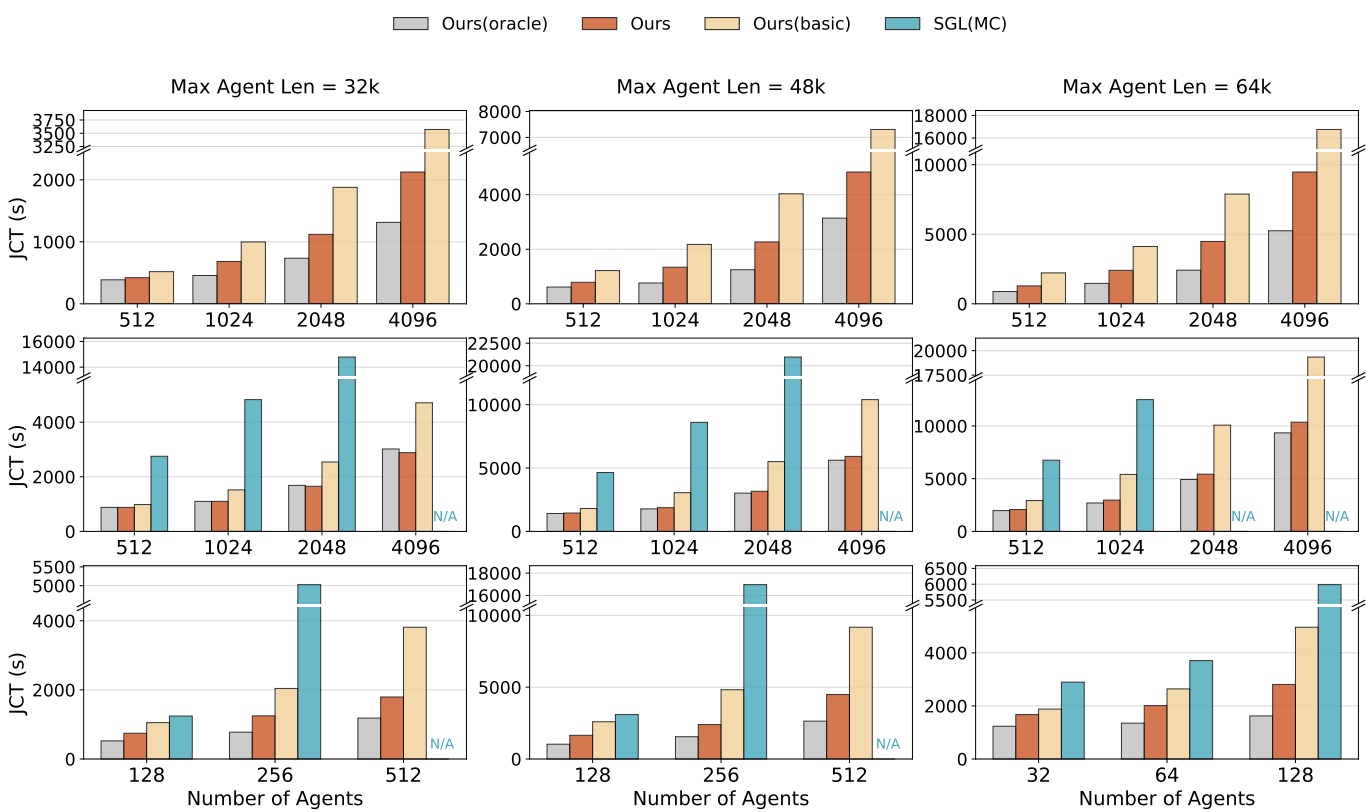
图 7: 离线 rollout 的任务完成时间, 三行为 DS 27B, DS 660B, Qwen 32B, 三列为 MaxLen 32K, 48K, 64K, 横轴为 agent 数 (原文 Figure 7).
图 7 解析: 每格四根柱分别是 SGL(MC), Basic, DualPath 和 Oracle 的 JCT, 越低越好; N/A 表示 SGL(MC) 在该配置中途出错. 三行从上到下是 DS 27B, DS 660B, Qwen 32B, 三列是 32K, 48K, 64K. 读图时要注意两点: Basic 与 DualPath 之间同时差着逐层 prefill 和双路径两项改动; SGL(MC) 的 DRAM 是 DualPath 的近 20 倍, 慢的原因主要在实现, 不能读成 Mooncake 架构本身的上限.
1.87 倍包含三项改动, 消融实验 (图 12 右, DS 660B, 64K) 把它拆开. 按图读数, 1024 个 agent 时 JCT 依次是 Basic 约 5,400 秒, 加逐层 prefill 约 4,250 秒, 再加双路径约 3,200 秒, 再加调度约 3,000 秒; 2048 个 agent 时依次约 10,100, 8,750, 6,500, 5,450 秒. 两组平均降幅 17%, 38%, 45%, 与正文的 17.21%, 38.19%, 45.62% 一致. 以「已有逐层 prefill」为起点, 双路径加调度带来的加速是 倍和 倍. 逐层 prefill 来自 LayerKV 和 PrefillOnly, 不是 DualPath 的贡献, 但 Basic 没有用它, 所以标题数字比 DualPath 自身的贡献高出一截. 双路径单项贡献约 21 到 26 个百分点的 JCT 降幅, 调度在此之上再降 3 到 10 个百分点.
5.3. 存储带宽决定性能的两组证据: 图 8 在 DS 27B 上扫 P/D 配比. 论文指出三组性能相近的配置: Basic 1P1D 与 Basic 1P2D, DualPath 1P1D 与 Basic 2P1D, DualPath 2P1D 与 DualPath 1P2D. 每组的可用存储带宽相同: Basic 只用 prefill 节点的网卡, 1P1D 和 1P2D 都是 1 块; DualPath 1P1D 用 2 块, Basic 2P1D 也是 2 块; DualPath 2P1D 和 1P2D 都是 3 块. 计算资源不同而 JCT 相近, 说明 JCT 由存储网卡数决定. 2.46 倍的最大加速比出现在 1P2D: Basic 约 8,300 秒, DualPath 约 3,400 秒, 网卡数从 1 块变 3 块, 加速比不超过 3 倍, 符合带宽上限. 平均加速比是 1.64 倍.
图 9 改变每轮追加长度和生成长度 (DS 660B, 64K, 1024 个 agent). 追加长度放大后, 每轮要算的 token 多了, 计算压力上升, Basic 逐渐接近 DualPath 和 Oracle, DualPath 相对 Basic 的加速比在 1.82 到 1.99 倍之间. 图中三条曲线的 JCT 都随追加倍数增大而下降, 原因在实验方法: 追加放大后轨迹在 MaxLen 处截断, 平均轮数变少, 总读量下降. 这一点论文只用一句「再在给定 MAL 截断」带过, 读图时需要知道 JCT 下降不代表系统变快. 生成长度变长时, 两次 prefill 之间的间隔变长, 单位时间要读的 KV 变少, 趋势相同.
5.4. 在线服务: 1.96 倍是两个点的平均: 在线实验按泊松过程以给定速率 (APS, 每秒新到 agent 数) 注入 agent, 每个 agent 从第 0 轮回放到末尾一轮. 实验在 TTFT 超过 4 秒时终止, 或在稳态时终止, 稳态定义为 150 秒滑动窗口内 TTFT 与 30 分钟前相比变化小于 5%. 论文没有写在线实验用的是哪份 trace. 图 10 中 DS 660B 的 Basic 在约 0.2 APS 时 TTFT 超过 SLO, DualPath 撑到约 0.45 APS, 比值 2.25; DS 27B 是约 0.3 对约 0.5, 比值 1.67. 摘要的「平均 1.96 倍」就是 , 只有两个模型, Qwen 32B 没有做在线实验.
TTFT 的构成见图 12 左 (DS 660B): 各 APS 下 DualPath 的排队, 分配, 读 KV, prefill 四段基本稳定, Basic 的排队时间随 APS 迅速增长, 原因是存储带宽不足, 请求在读队列里等. TPOT 方面 DualPath 与 Basic 持平, 说明 KV 转运没有拖慢解码, 这是第 4.1 节 VL 隔离有效的间接证据; 论文没有做关闭 VL 隔离的对照实验. DS 27B 上 Basic 和 DualPath 的 TPOT 都明显高于 Oracle, 论文归因于小模型上 PD 之间 KV 传输开销占比大, 留作未来工作. SGL(MC) 的 TTST 异常低, 论文推测是前两个 token 几乎同时到达客户端, 属实现问题.
5.5. 千卡扩展, 负载均衡与工作集: 表 3 把规模扩到 1,152 块 GPU. 离线 2P4D 跑 2K 个 agent 用 3,167 秒, 48P96D 跑 48K 个 agent 用 3,201 秒, 资源扩 24 倍, 负载扩 24 倍, JCT 持平. 在线 2P4D 在 0.4 APS 下 TTFT 1.739 秒, 44P88D 在 8.8 APS 下 1.847 秒, 资源扩 22 倍, 容量扩 22 倍. 这说明调度器和存储在这个规模下没有成为瓶颈 (调度器 CPU 占用低于 10 核), 但也没有规模收益, 论文在 §7.6 承认大规模实验相对等成本的多个小单元没有额外的 JCT 或容量提升. 图 15 是 48P96D 离线过程: Prompt TPS 在 900 到 2,400 秒间稳定在约 token/s, TTFT 开头冲到约 27 秒, 之后在 10 到 13 秒.
Prompt TPS 的口径论文没有定义, 可以用算力反推. 若它只计未命中 token, 384 块 PE GPU 每块每秒约 16 万 token, 按 1.1 节每 token 约 142 GFLOPs 要 22 PFLOPS, 超过单卡峰值一个数量级, 不可能; 所以它包含命中 token. 按 98.7% 命中率, 未命中 token 约 /s, 每块 PE GPU 约 2,000 token/s, 约 0.29 PFLOPS, 是 Hopper 稠密 FP8 峰值 (约 0.99 PFLOPS) 的三成. 命中部分按每 token 40KB 算约 2.4 TB/s, 而 144 个节点的存储网卡合计 7.2 TB/s, 利用率约三分之一. 这组数说明 48P96D 的稳态瓶颈已经不在存储网卡. 这一反推假设图 15 用 64K trace, 论文没有说明.
负载均衡有两张图. 图 13 测存储网卡流量的最大/平均比, 有调度时 1.184, 轮询时 1.528. 正文说统计的是「三台机器」上的所有存储网卡, 而 DS 660B 默认 2P4D 是六台, DS 27B 的 1P1D 是两台, 三台对应 1P2D 或 2P1D, 论文没有说明是哪组实验. 图 14 测 EP 组内各 GPU 注意力时间的最大/平均比, 正文说「任务前 5% 内低至 1.06」. 图上 512 个 agent 的曲线到任务进度 20% 时已升到约 1.9, 在 35% 到 40% 附近与不用调度的曲线相交, 论文的解释是后期负载不足, 比值失去意义. 1.06 只代表任务开头一小段.
§8.2 用 Little 定律估 KV 工作集: , 其中 是 APS, 是平均 JCT (图 11). 论文给出 DS 660B 在线时从 APS 0.1 的 69GB 到 APS 0.45 的 681GB. 按 64K trace 的 , 每 token 40KB, 图 11 读出 APS 0.1 时 约 575 秒, 0.45 时约 1,100 秒, 得到约 64GB 和 554GB; 每 token 计入 indexer cache 按 48KB 算, 得约 77GB 和 665GB. 论文的两个数落在这两种口径之间, 每 token 字节数文中没有给出. 更重要的是后半段推理: 真实场景有工具调用耗时, 若 JCT 变为 倍, 同样的推理资源能承载的 APS 也变为 倍, 工作集按 增长, 很快超过 DRAM 池容量. 这是论文主张直接以 SSD 存储为后端, 不依赖 DRAM 池的主要论据.
6. 与 Mooncake 等方案的关系
6.1. Mooncake 与 HiCache: 池子放在哪里, 谁去读: Mooncake (FAST'25) 是 Kimi 的线上推理架构, 以 KV cache 为中心: 把 GPU 集群里各节点的 CPU 内存和 SSD 组成分布式 KV 池, 由全局调度器按缓存命中和负载选 prefill 实例, 跨节点传输用 Transfer Engine 走 RDMA. 它和 DualPath 都做 PD 分离, 都做逐层传输, 都有缓存感知调度. 差别在两处. 第一是 KV 的落点: Mooncake 的主体是 DRAM 池, SSD 是下一级; DualPath 的 KV 只存在独立的 3FS 存储集群里, 节点 DRAM 只用作中转 buffer, DS 模型每节点 80GB. 按 5.5 节的工作集分析, Agent 负载的工作集随 JCT 平方增长, DRAM 池的命中率难以保持, 这是论文选 SSD 后端的理由. 第二是读的发起方: 在 SGLang 加 Mooncake 的 PD 模式里, 总是 prefill 侧读池子再转给 decode 侧 (Mooncake issue #1860), 与 Basic 相同; DualPath 改变的就是这一点.
HiCache 是 SGLang 的分级缓存, 层级为 GPU HBM, 主机 DRAM, 外部存储 (Mooncake Store, 3FS 等), 实验中的 SGL(MC) 就是这一组合. 两者的比较有前提: 两种 DRAM 用量相差近 20 倍, 并行方式不同 (Qwen 上 TP 对 DP), SGL(MC) 在大配置上出错. 论文自己放弃了与 SGL(MC) 算加速比. §9 还说 DualPath 可以与中间层 DRAM 缓存结合, 但「收益很小」, 这句话没有附实验数据. 在 3FS 关闭 DRAM 缓存, 存储网卡打满的设定下, 读带宽受 SNIC 限制, DRAM 缓存若在本节点能省掉 SNIC 读, 收益应当取决于命中率; 论文没有给出这组测量.
6.2. 其他相关工作与 DeepSeek 自身的 KV 落盘: §9 把相关工作分成三类. 分布式内存池: Mooncake 和 TokenLake (段级前缀缓存池), DualPath 的区别是直接以存储后端为对象, 平衡所有 SNIC 的流量, DRAM 用量小得多. 单路径 I/O 优化: Strata 联合设计 GPU 辅助 I/O 与缓存感知调度, KVPR 用重算与传输重叠, TailorKV 用分层混合量化, 都在一条读路径上减少字节或隐藏延迟; DualPath 增加路径, 两类方法可以叠加. 推理系统: PD 分离 (DistServe, Splitwise) 已经是事实标准, DualPath 在其上改读路径. 对照来看, DualPath 不压缩 KV, 不改模型, 只改数据从哪块网卡进来, 经哪条链路到 GPU.
DeepSeek 把 KV cache 落到磁盘不是从这篇论文开始的. 2024 年 8 月 DeepSeek API 上线硬盘缓存, 命中部分按更低价格计费; 3FS 的 README 把推理 KVCache 列为主要用途之一, 3FS 解析里给出了单客户端读峰值约 40 GiB/s 的数据. DualPath 补上的是这套部署在 Agent 负载下的带宽问题. 模型侧, V4 与 V4.1-Flash 进一步压缩 KV 体积, 并把 KV 在 HBM, 主机内存和 SSD 之间分层放置, 从字节数一侧降低同一个 cache-compute 比. 两条线合起来看, DeepSeek 的推理栈把 KV 当作要长期保存, 跨轮复用的数据, 而 Agent RL 的 rollout 是对这套设计压力最大的负载. 前缀缓存的一般机制见 增量式 Prefill 与 KV-Cache 机制, 分页管理见 PagedAttention 原理.
6.3. 需要打折看的几处结论: 几处数字的口径与标题措辞有出入, 按章节汇总. §4.2 式 (1) 的条件应为 , 论文写成 . §3 图 3 的 28.8 倍混合了 BF16, FP8 和 FP4 三种精度, 14.4 倍的 I/O 算力比下降因此偏大. 摘要和 §7.3 的 1.87 倍包含 Basic 没有的逐层 prefill, 双路径加调度单独约 1.4 到 1.6 倍. 摘要和 §7.4 的 1.96 倍是两个模型加速比的算术平均, 在线实验用的 trace 没有说明.
另有几处缺少支撑数据. §7.5 图 13 的「三台机器」与默认配置不符, 图 14 的 1.06 只覆盖任务前 5%. §9 关于结合 DRAM 缓存收益很小的说法没有实验. 附录 A.1 的「约 99% 带宽留给模型通信」可以按 InfiniBand 仲裁单位推出 (见 4.1 节), 但论文没有测关闭隔离时 TPOT 的变化. §8.2 的工作集数字依赖的每 token 字节数也未给出. 图 8 的等带宽配置对比支持存储网卡构成瓶颈, 上述缺项主要限制了对收益幅度和适用范围的判断.
参考文献
- Yongtong Wu 等. DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference. arXiv:2602.21548, 2026. https://arxiv.org/abs/2602.21548
- Ruoyu Qin 等. Mooncake: Trading More Storage for Less Computation, A KVCache-centric Architecture for Serving LLM Chatbot. FAST 2025. https://arxiv.org/abs/2407.00079
- Mooncake issue #1860: SGLang PD 模式下 decode 节点是否直接读 Mooncake Store. https://github.com/kvcache-ai/Mooncake/issues/1860
- DeepSeek-AI. 3FS: Fire-Flyer File System. https://github.com/deepseek-ai/3FS
- DeepSeek-AI. DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models. 2025.
- Kuntai Du 等. PrefillOnly: An Inference Engine for Prefill-only Workloads in Large Language Model Applications. SOSP 2025.
- InfiniBand Trade Association. InfiniBand Architecture Specification Volume 1, VL Arbitration 一节.